Lecția pe scurt
Întrebarea centrală: atunci când numim un sistem algoritm, automatizare, machine learning, inteligență artificială generativă, asistent, workflow, agent sau sistem autonom, ce afirmăm de fapt despre el?
Această lecție oferă un sistem precis de orientare în vocabularul domeniului AI. Vei învăța să privești un produs dincolo de numele comercial și să identifici ce anume produce comportamentul său, cum este controlată execuția și ce autoritate i s-a acordat software-ului asupra lumii reale sau digitale — adică ce anume are voie să facă singur, fără să te mai întrebe: doar să răspundă pe ecran, sau și să trimită un e-mail în numele tău, să șteargă un fișier, să modifice o bază de date, să facă o plată. Autoritatea nu este o însușire a modelului, ci o permisiune pe care i-o dă cineva — prin chei de acces, drepturi de scriere sau acces la rețea — și care poate fi oricând restrânsă.
Pornim de la software determinist, continuăm cu sisteme care învață din date, apoi separăm modelele generative de aplicațiile care folosesc instrumente și, la final, analizăm când un sistem devine agent și când primește autonomie.
La finalul lecției vei putea
- Să deosebești un algoritm, un program bazat pe reguli, automatizarea, statistica, machine learning, deep learning, un foundation model și inteligența artificială generativă.
- Să explici de ce un model lingvistic mare — LLM — nu este automat un agent.
- Să diferențiezi un asistent, un workflow, un agent și un sistem autonom.
- Să clasifici orice sistem pe trei axe independente, fără să-l forțezi într-o singură categorie de marketing.
- Să alegi mecanismul cel mai simplu și mai fiabil care poate rezolva o problemă.
- Să clasifici 25 de sisteme reale sau ambigue și să-ți aperi argumentarea.
1. Cum descriem corect un sistem
Această secțiune stabilește metoda de lucru pentru întreaga lecție: nu clasificăm un produs după impresia pe care o produce, ci după elementele sale observabile.
Pentru orice aplicație, întreabă mai întâi ce primește, ce transformare execută, cum alege următorul pas și ce acțiuni poate realiza fără aprobare. Aceleași întrebări funcționează pentru un calculator de buzunar, un filtru de spam, un chatbot, un robot industrial sau un agent27 care modifică un repository50 (depozitul în care sunt păstrate codul sursă al unui proiect și toate versiunile lui anterioare, astfel încât să se vadă cine ce a modificat și să se poată reveni oricând la o variantă mai veche).
Aceste proprietăți se pot combina în moduri diferite. Un proces poate fi complet automat fără machine learning5. Un model foarte performant poate să nu aibă voie să modifice nimic. Un agent27 poate utiliza simultan reguli, baze de date, simulatoare și modele.
Un exemplu în zece secunde: filtrul de spam din e-mailul tău. Intrare: mesajul primit. Transformare: un model învățat din milioane de exemple, plus câteva reguli fixe ale administratorului. Control: o singură predicție per mesaj. Autoritate: mută mesajul într-un folder — atât. Patru răspunsuri scurte și ai clasificat un sistem întreg, fără să pomenești vreun termen de marketing.
2. De ce este necesară această clasificare
Această secțiune arată consecințele practice ale confuziei dintre termeni. O etichetă greșită nu rămâne o problemă de vocabular: ea duce la costuri mai mari, la rezultate mai slabe și la permisiuni care pot periclita securitatea întregului sistem.
De exemplu, dacă o echipă numește „agent27 autonom” o aplicație care doar rezumă un text, va căuta probabil infrastructură, memorie și instrumente30 de care nu are nevoie. Invers, dacă tratează drept simplu chatbot un sistem care poate trimite mesaje, șterge fișiere sau controla procese, acesta poate fi începutul unui incident de securitate cu urmări greu de reparat.
Clasificarea corectă ne ajută să alegem o soluție potrivită — o arhitectură proporțională cu problema: reguli pentru cerințe exacte, modele pentru ambiguitate și percepție, workflow-uri26 pentru procese stabile, agenți27 pentru sarcini în care următorul pas nu poate fi stabilit complet dinainte.
Fără această hartă, echipele ajung frecvent:
- să cumpere un LLM16 acolo unde ar fi fost de ajuns câteva reguli clare;
- să numească „agent27” un chatbot care nu poate acționa;
- să acorde permisiuni extinse unui agent27 doar fiindcă pare inteligent;
- să încerce să antreneze un model când problema reală este accesul la informații mai bune;
- să folosească generare probabilistică11 pentru calcule care trebuie să fie exacte;
- să automatizeze o decizie periculoasă fără aprobare umană32;
- să construiască un sistem multi-agent27 pentru o problemă care cere doar un workflow26 cu cinci pași.
Un inginer bun întreabă înainte de a selecta un produs:
- Ce proprietate trebuie să aibă sistemul? Predicție, generare de conținut, planificare, folosirea instrumentelor30, memorie sau autonomie29?
- Care este mecanismul cel mai simplu și mai fiabil care oferă acea proprietate?
Principiu de proiectare: folosește componenta cel mai puțin „inteligentă” care poate executa corect un pas. Păstrează modelele pentru ambiguitate, percepție, limbaj și raționament dificil de exprimat prin reguli.
3. De ce termenii nu formează o singură scară
În această secțiune verificăm o reprezentare des întâlnită, dar incorectă: ideea că fiecare termen ar fi pur și simplu o versiune „mai avansată” a celui anterior.
Algoritm → Machine learning → Deep learning → AI generativă → Agent → AutonomieȘirul de mai sus nu este o definiție și nici o evoluție obligatorie. El amestecă tehnici de calcul — precum machine learning5 — cu tipare de control — precum agentul27 — și cu niveluri de permisiune — precum autonomia29. Din acest motiv, un sistem nu poate fi plasat corect pe o singură linie.
3.1 Cele trei întrebări independente
Această subsecțiune transformă problema de clasificare în trei întrebări concrete. Le analizăm separat deoarece un sistem poate folosi un model avansat, poate urma un flux simplu și poate avea totuși autoritate foarte redusă.
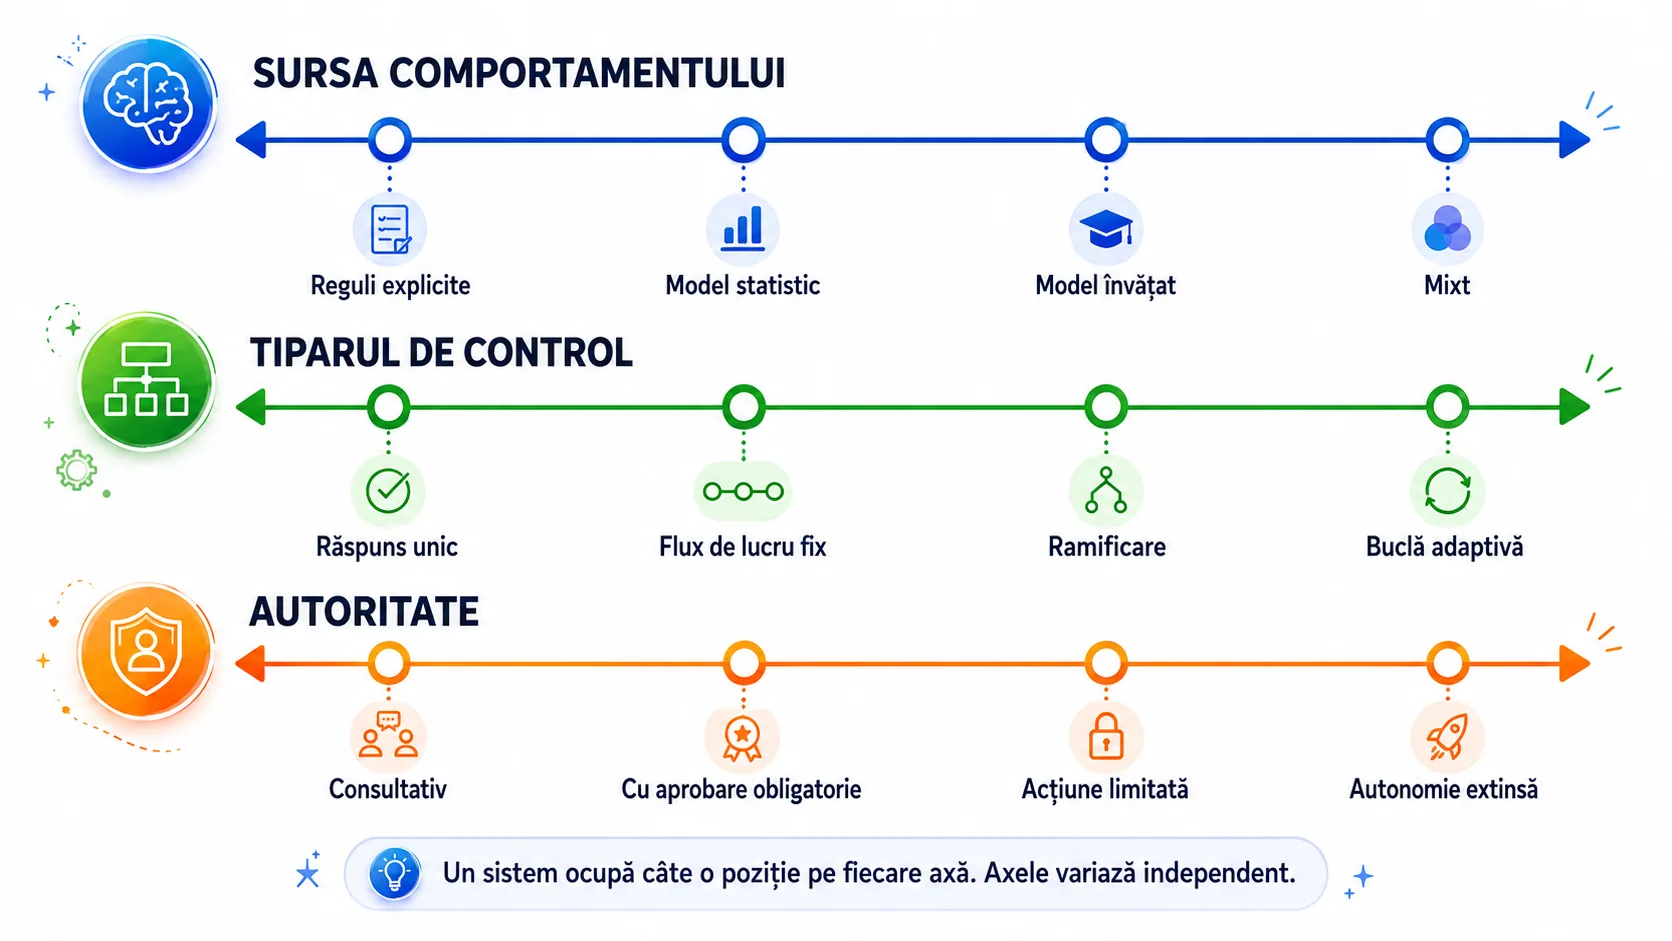
Descriere text: clasifică separat (1) ce produce comportamentul, (2) cum este ales pasul următor și (3) ce are sistemul permisiunea să facă. Axele sunt independente.
| Sistem | Sursa comportamentului | Tiparul de control | Autoritate |
|---|---|---|---|
| Calculator | Reguli explicite | Un singur răspuns | Consultativ |
| Script de backup nocturn | Reguli explicite | Workflow26 fix | Autonom, dar foarte restrâns |
| Filtru de spam | Model învățat plus reguli de rutare | Predicție și rutare | De obicei automat |
| Asistent25 conversațional LLM16 | Model generativ învățat | Răspuns conversațional | Consultativ |
| Agent27 de programare | Model plus instrumente30 deterministe10 | Buclă adaptivă28 | Poate modifica fișiere automat |
| Asistent25 pentru controlul inundațiilor | Modele, simulări și reguli | Investigație adaptivă | Acțiunile fizice trebuie aprobate |
Cuvântul autonom spune puțin despre inteligență. Un script simplu poate acționa autonom; un model extrem de capabil poate rămâne doar consultativ.
4. Relația dintre AI, machine learning, deep learning și AI generativă
Această secțiune clarifică relația dintre principalele familii tehnice. Inteligența artificială este domeniul larg; machine learning5 este una dintre abordările sale, iar rețelele neuronale și deep learning7 reprezintă familii mai specifice din interiorul machine learning.
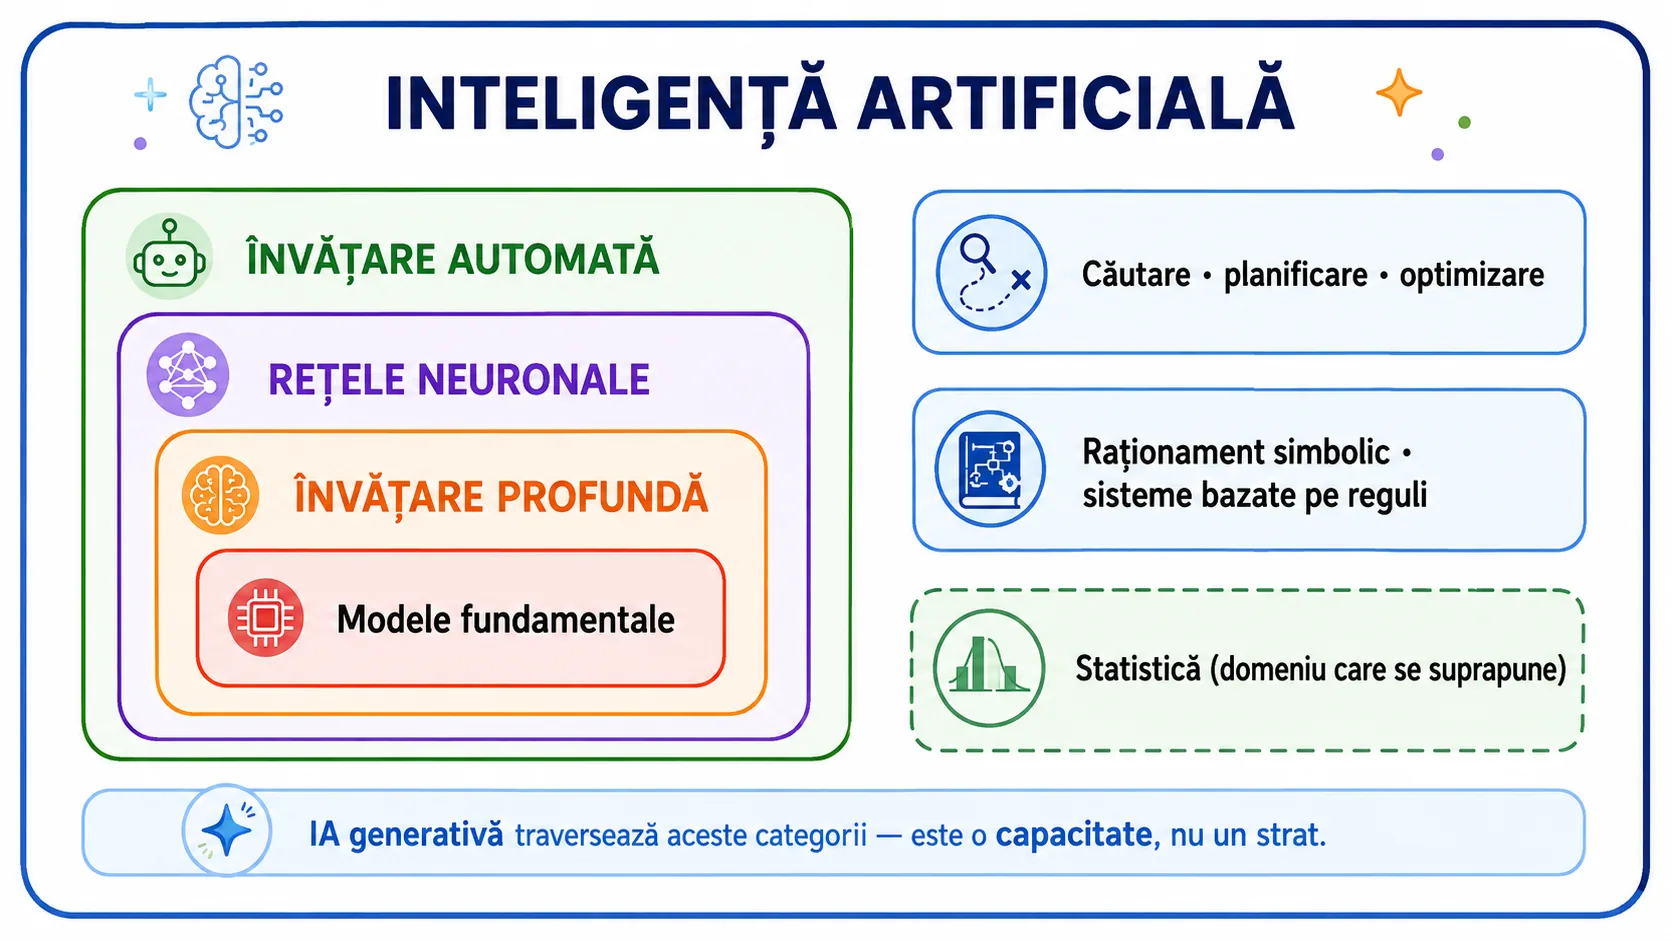
Aceasta este o hartă conceptuală, nu un arbore rigid:
- Statistica4 și machine learning5 se suprapun.
- Căutarea și planificarea pot funcționa fără modele învățate.
- Nu orice rețea neuronală6 este „adâncă” (deep).
- Nu orice foundation model8 este generativ; un model de embedding21 poate transforma textul, imaginea sau sunetul într-o reprezentare vectorială — o listă de numere folosită pentru compararea asemănărilor — fără să genereze conținut nou.
- Modelele generative existau cu mult înainte de apariția foundation models8.
- Automatizarea3 traversează toate ramurile și poate exista fără AI.
5. Conceptele de bază, pe rând
Următoarele subsecțiuni definesc fiecare termen separat. Pentru fiecare concept urmărim aceeași logică: ce problemă descrie, cum funcționează în termeni tehnici, ce poate face bine și cu ce nu trebuie confundat.
Este important să nu sari direct la „agent27”. Agenții sunt construiți din componente mai simple, iar calitatea lor depinde de înțelegerea acestor componente.
5.1 Algoritm
Începem cu algoritmul1 deoarece orice software, inclusiv un sistem AI, execută proceduri concrete pentru a transforma datele.
Un algoritm1 este o procedură finită care transformă o intrare într-o ieșire prin operații neambigue. Poate sorta o listă, găsi cel mai scurt drum, comprima un fișier ori calcula un impozit.
Intrare: [7, 2, 9]
Procedură: compară și reordonează valorile
Ieșire: [2, 7, 9]
Un algoritm1 nu este neapărat AI, nu trebuie să fie învățat din date, nu este automat adaptiv și nu este obligatoriu probabilistic11. Orice sistem ML5 folosește algoritmi, dar majoritatea algoritmilor nu sunt machine learning.
Analogie: un algoritm1 este o rețetă de bucătărie scrisă fără loc de interpretare. Aceleași ingrediente, aceiași pași, același fel de mâncare — de fiecare dată. Rețeta nu „gândește”; doar descrie exact ce se face și în ce ordine.
5.2 Software bazat pe reguli
Aici vedem cum oamenii pot specifica direct condițiile și acțiunile unui program, fără ca sistemul să învețe din exemple.
Oamenii scriu explicit condițiile și acțiunile:
DACĂ total_factură > limita_aprobare
ATUNCI solicită_aprobarea_managerului
Puncte forte: predictibil, testabil, explicabil, eficient și potrivit pentru constrângeri legale, matematice sau de siguranță.
Puncte slabe: devine fragil în situații cu multe excepții, greu de întreținut când regulile se înmulțesc și slab pentru limbaj, imagini ori ambiguitate brută.
Regulile rămân esențiale în arhitecturile moderne de agenți27. Modelele nu trebuie să înlocuiască restricțiile nenegociabile.
Analogie: software-ul bazat pe reguli este un arbitru cu regulamentul în mână. Aplică litera legii perfect și la nesfârșit — dar dacă pe teren apare o situație pe care regulamentul nu a prevăzut-o, arbitrul rămâne blocat. Cineva trebuie să scrie o regulă nouă.
5.3 Automatizare
Această subsecțiune separă execuția fără intervenție umană de ideea de inteligență.
Automatizarea3 înseamnă că un proces rulează cu intervenție umană redusă. Ea descrie execuția, nu inteligența.
Exemple: copierea fișierelor în fiecare noapte, trimiterea unei notificări de reamintire după 14 zile, redimensionarea imaginilor, deploy-ul53 după teste sau mutarea unui tichet prin etape fixe.
Un workflow26 poate conține pași AI fără să devină agent27. Un singur apel către un LLM16 nu schimbă automat natura controlului.
Analogie: automatizarea3 este mașina de spălat. Apeși un buton și programul rulează singur, pas cu pas, fără tine. Nimeni nu ar spune că mașina de spălat e „inteligentă” — și totuși îți economisește ore. Exact asta promite automatizarea: execuție fără prezență, nu gândire.
5.4 Statistică
Statistica4 este disciplina care arată câtă încredere poți avea în ceea ce spun datele.
Statistica4 oferă metode pentru a înțelege populații, relații, variație și incertitudine din date. Întrebări tipice:
- Este diferența observată semnificativă?
- Cât de incertă este estimarea?
- Ce variabile sunt corelate?
- Ce proces ar fi putut produce observațiile?
Machine learning5 pune accentul, de regulă, pe predicție și pe decizii luate asupra unor date noi, pe care modelul nu le-a văzut la antrenare13. Domeniile se suprapun puternic; regresia liniară se încadrează firesc în amândouă.
De ce contează pentru un dezvoltator: vei folosi statistică4 ori de câte ori interpretezi un test A/B, compari două variante de prompt15 sau te întrebi dacă îmbunătățirea măsurată e reală ori doar zgomot. Este instrumentul30 care te ferește să tragi concluzii din trei rulări norocoase.
Analogie: statistica4 este lingura cu care guști din oală. Nu mănânci toată supa ca să afli dacă e sărată: iei o probă, judeci întregul și rămâi conștient că o singură lingură poate înșela. Eșantion, concluzie, incertitudine — toată statistica într-un gest de bucătărie.
5.5 Machine learning
Machine learning5 devine util atunci când regulile complete sunt greu de scris, dar există exemple din care pot fi învățate tipare.
Un sistem își îmbunătățește performanța învățând tipare din exemple, în loc să primească fiecare regulă explicit. O formulare clasică folosește:
Sarcină + experiență + măsură de performanțăExistă patru moduri în care un model poate învăța, și ele se deosebesc prin ce fel de material primește:
| Tip de învățare | Ce primește ca material de învățare | Exemplu concret |
|---|---|---|
| Supervizată | Exemple în care răspunsul corect este deja scris lângă fiecare intrare: „acest e-mail este spam”, „acest apartament s-a vândut cu 90.000 €”. Cineva a etichetat manual, dinainte, mii sau milioane de cazuri. | Filtrul de spam din căsuța ta poștală, antrenat pe mesaje marcate de utilizatori ca fiind spam; estimarea prețului unei locuințe pornind de la suprafață, zonă și anul construcției. |
| Nesupervizată | Date brute, fără niciun răspuns corect atașat. Nimeni nu îi spune modelului ce să caute; el trebuie să descopere singur structura ascunsă în date. | Clustering: gruparea automată a clienților unui magazin în categorii de comportament pe care nimeni nu le-a definit dinainte. Detectarea anomaliilor: semnalarea tranzacției care nu seamănă cu nimic din istoricul cardului. |
| Auto-supervizată | Tot date brute, dar sarcina de învățare este construită chiar din date, fără etichete scrise manual. Unele metode ascund o parte din intrare și cer modelului să o reconstruiască; altele, precum modelele autoregresive de limbaj, cer prezicerea următorului token dintr-o secvență. | Modelele de limbaj: un model autoregresiv primește începutul unei secvențe și exersează să prezică tokenul următor, de foarte multe ori, pe texte care nu au nevoie de etichete scrise manual. Alte familii de modele pot învăța reconstruind fragmente ascunse. |
| Prin întărire (RL) | Nu exemple, ci consecințe. Modelul încearcă o acțiune, primește în schimb o recompensă sau o penalizare și își ajustează comportamentul ca să obțină un scor total cât mai mare pe termen lung. | Un program care învață să joace șah pierzând mii de partide și reținând ce mutări au dus la victorie; un termostat care învață să mențină temperatura consumând cât mai puțin curent. |
Doi termeni din tabel, explicați:
Clustering înseamnă gruparea automată a datelor în „ciorchini” de elemente asemănătoare între ele și diferite de restul, fără ca cineva să fi stabilit dinainte câte grupuri există sau cum se numesc. Dacă îi dai unui algoritm1 de clustering istoricul de cumpărături a zece mii de clienți, el poate întoarce trei grupuri distincte; nu îți spune ce reprezintă ele — asta rămâne interpretarea ta, care ar putea fi „cumpărători de weekend”, „cumpărători de necesitate” și „vânători de reduceri”.
Învățarea prin întărire (în engleză reinforcement learning, prescurtat RL) este metoda prin care un sistem învață din consecințele acțiunilor sale, nu din exemple rezolvate dinainte. Face o mișcare, primește un punctaj — recompensă dacă s-a apropiat de obiectiv, penalizare dacă s-a îndepărtat — și, după foarte multe încercări, ajunge la un mod stabil de a acționa. Acel mod de a acționa se numește politică: regula internă care spune „în situația asta, fă mișcarea asta”. Așa au fost antrenate programele care joacă Go la nivel supraomenesc și tot așa, parțial, sunt ajustate modelele de chat pe baza feedbackului dat de oameni.
Antrenare versus inferență
Un model are două etape de viață complet diferite, cu costuri, durate și riscuri diferite. Confundarea lor este una dintre cele mai frecvente surse de neînțelegere.
- Antrenarea13 este etapa în care modelul se schimbă. I se dă un set de date pregătit dinainte, iar un algoritm1 de optimizare parcurge exemplele și corectează, puțin câte puțin, valorile numerice din interiorul modelului — se numesc parametri12 și sunt, la modelele mari, miliarde de numere. Corecția se face în direcția care reduce greșeala pe exemplele văzute. Antrenarea se face o singură dată, sau rar, când modelul e reantrenat; durează de la ore la săptămâni, cere hardware scump, iar rezultatul ei este un fișier: modelul antrenat.
- Inferența14 este etapa în care modelul deja antrenat este folosit. Îi trimiți o intrare nouă — un e-mail sosit acum, o fotografie făcută azi, o întrebare scrisă de un utilizator — și el întoarce un rezultat: o etichetă („spam”), un scor („risc 0,83”), un text. În inferența obișnuită, cererea nu modifică parametrii12 modelului. Aplicația poate totuși să păstreze conversația, starea31 sarcinii ori o memorie externă și să le trimită din nou la cererile următoare; asta schimbă contextul pe care îl primește modelul, nu înseamnă că parametrii lui au fost reantrenați din conversație. Inferența se întâmplă de fiecare dată când modelul este apelat și consumă resurse la fiecare cerere.
Rezumat: în antrenare13 se modifică parametrii12 modelului; în inferența14 obișnuită modelul este aplicat fără ca cererea curentă să-i rescrie parametrii. Sistemul din jur poate însă păstra stare31, istoric sau memorie externă și le poate folosi la cererile viitoare. Antrenarea o face, de regulă, echipa care construiește modelul; inferența este costul repetat al folosirii lui. De aceea aproape toate deciziile de arhitectură din acest curs privesc inferența și sistemul construit în jurul modelului.
Analogie: machine learning5 este ucenicul care învață meserie privind, nu citind manualul. Nimeni nu îi dictează regulile croitoriei; vede mii de haine bune și proaste și prinde singur tiparul. Antrenarea13 este ucenicia; inferența14 este ziua în care lucrează pentru clienți. Și, ca orice ucenic, judecă bine doar situațiile care seamănă cu ce a văzut.
5.6 Rețele neuronale
Rețelele neuronale sunt o familie de modele machine learning5; nu sunt o copie literală a creierului, ci structuri matematice optimizabile.
O rețea neuronală6 este o funcție matematică parametrizată, construită din straturi conectate. În timpul antrenării13, un algoritm1 de optimizare ajustează parametrii12 pentru a reduce eroarea.
Rețelele pot învăța reprezentări interne. În loc să definim manual fiecare trăsătură vizuală a unei pisici, rețeaua poate învăța progresiv trăsături mai abstracte.
O rețea neuronală6 nu este un creier digital. Metafora biologică este utilă istoric, dar limitată tehnic.
Analogie: o rețea neuronală6 este un pupitru de mixaj cu milioane de butoane. Nimeni nu le poate regla manual; în antrenare13, o procedură automată le rotește puțin câte puțin, ascultă cât de „greșit” sună rezultatul și corectează. Când eroarea nu mai scade, butoanele îngheață — acesta este modelul antrenat.
5.7 Deep learning
Deep learning7 duce mai departe rețelele neuronale: mai multe straturi și o capacitate mai mare, care fac posibilă învățarea unor reprezentări complexe.
Deep learning7 folosește rețele neuronale6 cu multe straturi de transformare. Este deosebit de puternic pentru imagini, voce, limbaj, video, sisteme multimodale și învățarea reprezentărilor la scară mare.
Intuiția adâncimii: primele straturi învață lucruri simple, iar ultimele le combină în concepte tot mai abstracte — la imagini: margini → forme → părți → obiecte. Nimeni nu programează această ierarhie manual; ea apare din antrenare13. Exact această capacitate de a-și construi singur reprezentările face deep learning7 potrivit pentru date brute și nestructurate.
„Deep” descrie adâncimea arhitecturii, nu înțelepciunea, conștiința ori fiabilitatea.
Analogie: deep learning7 este o linie de asamblare a percepției. Prima stație vede doar linii și pete; următoarea combină liniile în forme; alta asamblează formele în părți, iar ultima recunoaște obiectul întreg. Nicio stație nu înțelege singură „pisica” — înțelegerea apare din lanț.
5.8 Foundation models
Foundation models8 sunt modele antrenate pe date și sarcini suficient de largi încât să poată fi reutilizate în multe aplicații. Termenul descrie un rol economic și arhitectural — „fundație pe care se construiește” — nu o arhitectură anume, și nu implică automat un model generativ: modelele de embeddings, de exemplu, sunt foundation models care produc reprezentări numerice, nu text.
Trei proprietăți le definesc în practică:
- antrenare13 la scară mare, pe date variate, de regulă auto-supervizată — modelul învață din structura datelor, fără etichete scrise manual pentru fiecare exemplu;
- reutilizare: același model servește sarcini pentru care nu a fost antrenat explicit, prin metodele de adaptare de mai jos;
- omogenizare: multe aplicații moștenesc atuurile și defectele aceluiași model de bază — o eroare sau o părtinire (în engleză bias) din fundație se propagă în tot ce este construit deasupra.
Reutilizarea este avantajul major, dar vine la pachet cu erori moștenite de toate aplicațiile construite peste el, cu un cost de operare permanent, cu întrebări de licențiere și cu o evaluare mai greu de făcut. Un foundation model8 poate lucra cu text, imagini, audio, video, cod, structuri științifice ori mai multe modalități simultan.
Metodele de adaptare, de la ieftin la costisitor
Ordinea contează: în practică se începe cu metoda cea mai ieftină care rezolvă problema și se avansează doar cu justificare.
Prompting
Formularea instrucțiunii și a datelor trimise modelului. Nu modifică modelul; costă doar cererea. Primul lucru de încercat, întotdeauna.
Exemple în context
Câteva exemple rezolvate incluse în aceeași cerere (in-context learning). Modelul imită tiparul, fără nicio modificare internă.
RAG
Retrieval-augmented generation: fragmente relevante din surse externe sunt recuperate și incluse în context înainte de răspuns. Aduce cunoștințe proaspete sau private fără reantrenare.
Instrumente
Modelul apelează funcții — căutare, calculator, bază de date, API48. Faptele și acțiunile vin din sisteme verificabile, nu din memoria modelului.
PEFT
Parameter-efficient fine-tuning19: se adaptează o mică parte din parametri12 sau se adaugă componente mici (de exemplu adaptoare LoRA). Specializare la o fracțiune din costul reantrenării.
Fine-tuning complet
Continuarea antrenării13 pe o parte foarte mare sau pe toți parametrii12. Cel mai scump și mai riscant; justificat doar când metodele de mai sus au fost epuizate.
Regula practică a cursului: promptul15 înaintea RAG-ului18, RAG-ul înaintea fine-tuningului. Fiecare treaptă adaugă cost, întreținere și risc de regresie*. Treci la treapta următoare numai după ce ai măsurat că cea de dinainte nu îți mai ajunge — nu pentru că pare mai interesantă.
Regresie* înseamnă aici o îmbunătățire care, fără ca cineva să urmărească asta (din greșeală), strică ceva ce mergea bine până atunci. Un model trecut prin fine-tuning19 răspunde vizibil mai bine la sarcina pentru care a fost specializat, dar poate răspunde mai slab la alte trei sarcini mai vechi, pe care nimeni nu s-a mai gândit să le verifice.
5.9 Inteligență artificială generativă
AI generativă9 descrie modele care produc conținut sau structuri noi, nu doar etichete și scoruri.
AI generativă9 produce conținut sau ieșiri structurate noi pe baza tiparelor învățate: text, cod, imagini, audio, video, obiecte 3D, molecule, planuri sau JSON (un format text simplu, alcătuit din perechi „nume: valoare”, în care programele își transmit unele altora date structurate; este citibil și de om, și de mașină, motiv pentru care a devenit formatul implicit al comunicării dintre aplicații).
Generarea este probabilistică11. Modelul produce o continuare ori un artefact plauzibil, nu un adevăr garantat.
Cum funcționează, pas cu pas
Ține în minte o singură imagine: un autocomplete uriaș. Telefonul tău îți propune următorul cuvânt după ce a văzut câteva mii de mesaje; un model generativ face același gest după ce a „citit” biblioteci43 întregi — și îl repetă de mii de ori pe secundă. Procesul are patru pași:
- Antrenare13 — învață tiparele. Modelul primește cantități enorme de text, imagini sau sunet și exersează un singur joc: „ghicește fragmentul care urmează”. Milioane de runde ajustează parametrii12 până când predicțiile devin bune. Modelul nu memorează o bază de date de răspunsuri; comprimă tiparele — cum arată o frază corectă, un contract, o funcție Python, o fotografie plauzibilă.
- Promptul15 — primește contextul. Ce îi scrii tu devine începutul pe care trebuie să-l continue. De aceea formularea contează atât de mult: schimbi contextul, schimbi continuarea.
- Generare — fragment cu fragment. Modelul nu compune răspunsul întreg dintr-o dată. Alege următorul fragment (un cuvânt sau o bucată de cuvânt), îl lipește la context, apoi alege din nou, și din nou — până la condiția de oprire. Fiecare alegere este probabilistică11: dintre continuările plauzibile, una este aleasă. De aceea aceeași întrebare poate primi azi și mâine răspunsuri diferite.
- Oprire. Un semnal de final, o limită de lungime sau o instrucțiune încheie secvența.
Din această mecanică decurge tot ce trebuie să știi despre punctele forte și despre riscuri: modelul produce continuarea cea mai plauzibilă, nu adevărul verificat. Când plauzibil și adevărat coincid — rezumate, redactare, cod uzual — rezultatul pare magie. Când nu coincid, modelul „halucinează”: afirmă senin lucruri false, pentru că fals-dar-plauzibil câștigă jocul pentru care a fost antrenat. Nu este o defecțiune; este natura mecanismului — și exact motivul pentru care ieșirile care contează se validează cu reguli, calcule sau oameni.
Tabelul de mai jos arată, pe rânduri, ce diferență face întrebarea pusă. Coloana din stânga adună sarcini discriminative: sistemul alege dintr-un set de răspunsuri care există deja — spam sau nu, pisică sau câine, pozitiv sau negativ. Există un răspuns corect, deci rezultatul poate fi verificat și măsurat exact. Coloana din dreapta adună sarcini generative: sistemul produce un conținut care nu exista înainte și pentru care nu există un singur răspuns corect, ci multe variante acceptabile. Pe fiecare rând, cele două coloane pornesc de la același material — același e-mail, aceeași imagine, același document — și diferă doar prin ce i se cere sistemului să facă cu el.
| Sarcină discriminativă — alege dintre răspunsuri existente | Sarcină generativă — produce conținut nou |
|---|---|
| Este acest e-mail spam? | Redactează un răspuns. |
| Ce obiect apare în imagine? | Creează o imagine nouă. |
| Care este sentimentul? | Scrie un rezumat într-un ton calm. |
| În ce clasă intră documentul? | Generează un raport structurat pe baza lui. |
Granița dintre cele două coloane nu este etanșă. Poți cere unui model generativ să facă o sarcină discriminativă: îi scrii pur și simplu „citește e-mailul de mai jos și răspunde cu un singur cuvânt — spam sau curat”, iar el îți întoarce eticheta cerută. Asta se numește clasificare prin prompting: obții un rezultat de clasificator fără să antrenezi vreun clasificator, doar formulând sarcina ca instrucțiune.
Diferența, și motivul pentru care rezultatul trebuie verificat, stă în ce probabilitate este proiectat sistemul să estimeze. Un clasificator dedicat pentru spam produce direct un scor sau o probabilitate pentru clasele relevante — de exemplu „spam” versus „curat” — și poate fi evaluat și calibrat pentru exact această sarcină. Un model lingvistic autoregresiv calculează, în schimb, scoruri și probabilități pentru următorul token posibil. Dacă îi ceri să răspundă numai cu „spam” sau „curat”, folosești această distribuție de tokeni ca mecanism de clasificare. Rezultatul poate fi foarte bun, dar probabilitatea unui token nu este automat o probabilitate calibrată că mesajul este spam. Iar tonul răspunsului nu îți spune cât de sigur este modelul: poate formula la fel de convingător o etichetă corectă și una greșită.
În practică: pentru un prototip sau pentru o sarcină în care o greșeală ocazională nu costă nimic, clasificarea prin prompting este cea mai rapidă soluție. Când corectitudinea contează — bani, siguranță, decizii ireversibile — eticheta obținută astfel se validează: cu reguli, cu un clasificator dedicat sau cu un om.
Analogie: un model generativ este un muzician de jazz care a ascultat toată muzica lumii. Îi dai o temă — promptul15 — și improvizează o continuare în stilul cerut, notă cu notă, fără partitură. Improvizația sună aproape întotdeauna coerent; dacă este și adevărată este altă întrebare — jazzul nu are fact-checking. De aceea modelul strălucește la formă (text, ton, structură, cod) și are nevoie de verificare la fapte.
5.10 Asistent
Un asistent25 este definit în primul rând prin relația cu utilizatorul, nu printr-o anumită tehnologie internă.
„Asistent25” descrie rolul față de utilizator. Sistemul poate răspunde, sugera, redacta, căuta sau organiza. Poate fi un ajutor bazat pe reguli, un chatbot LLM16, un sistem RAG18, un agent27 cu instrumente30 sau chiar un operator uman sprijinit de software.
Termenul nu spune automat nimic despre arhitectura internă ori autoritate.
Test rapid: autocomplete-ul din editorul de cod și un chatbot LLM16 sunt amândoi „asistenți25” — deși unul e un model mic de completare, iar celălalt un foundation model8. Eticheta descrie relația cu tine, nu ce e înăuntru. De aceea, când cineva spune „am un asistent AI”, încă nu știi nimic despre cum funcționează sau ce are voie să facă.
În forma lui cea mai simplă, tu conduci interacțiunea: asistentul25 răspunde când îl întrebi, redactează când îi ceri și se oprește după rezultat. Dar „asistent” rămâne o etichetă de rol, nu o definiție a mecanismului intern. Un produs prezentat utilizatorului ca asistent poate avea în interior un workflow26, un sistem RAG18 sau chiar un agent27 care execută mai mulți pași. De aceea nu clasificăm arhitectura doar din cuvântul „asistent”; verificăm separat cine alege pașii, ce instrumente30 există și ce autoritate are sistemul.
Analogie: un asistent25 simplu seamănă cu un consilier de la ghișeu: îți explică formularele, îți redactează cererea și îți spune ce opțiuni ai, iar acțiunea rămâne la tine. Dar o aplicație numită comercial „asistent” poate avea în spate și un agent27 care face investigații sau pregătește acțiuni. Numele interfeței nu decide arhitectura.
5.11 Workflow — flux de lucru
Un workflow26 organizează pașii unui proces atunci când ordinea și ramificațiile pot fi proiectate dinainte.
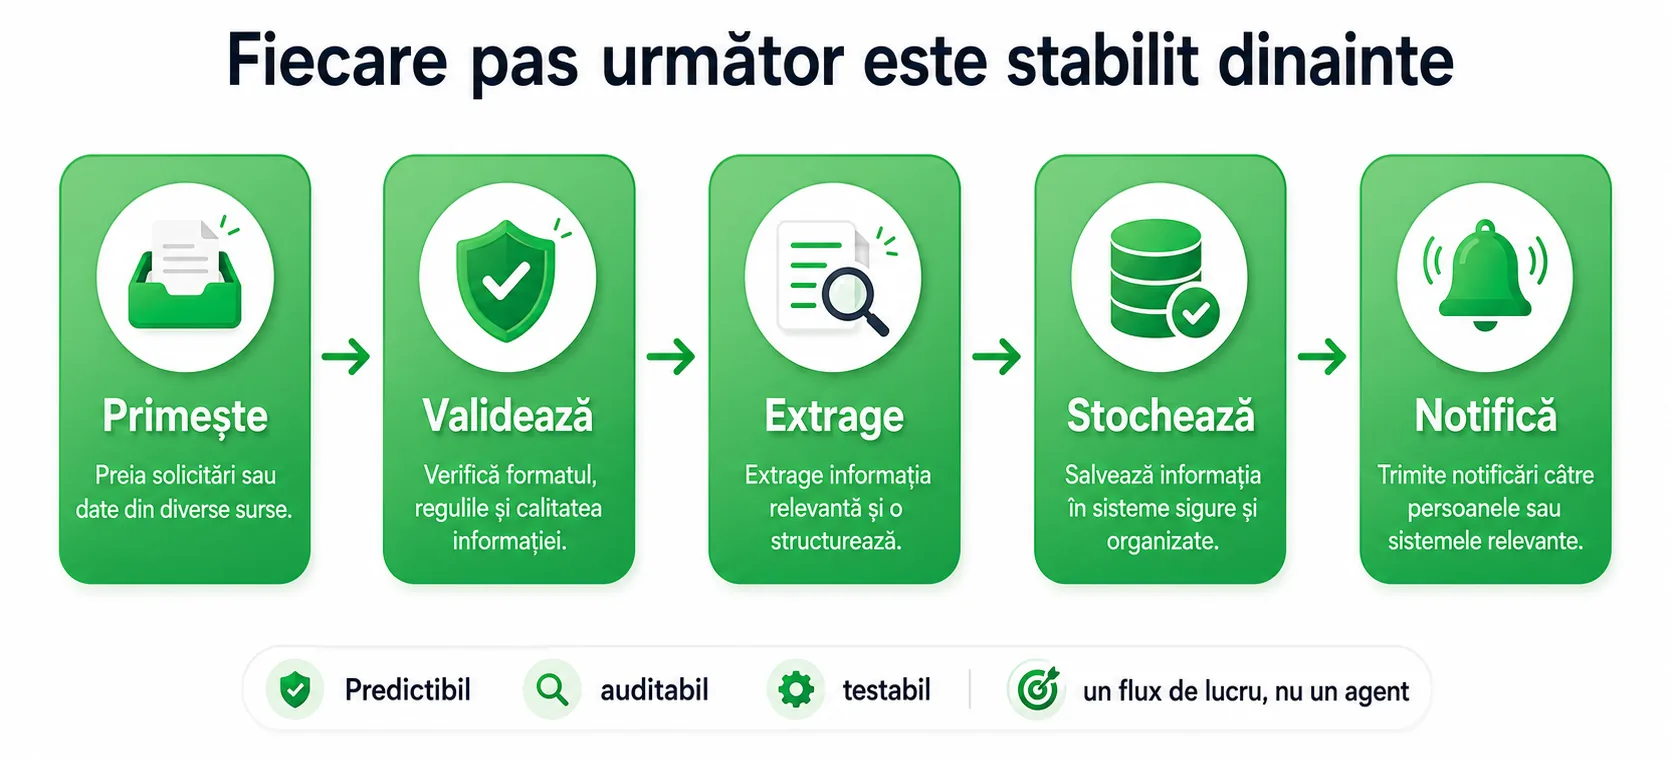
Un workflow26 este o succesiune explicită de pași sau o schemă ramificată în care, pentru fiecare pas, se știe dinainte ce poate urma după el.
Descriere text: pasul următor este ales dintre tranzițiile stabilite dinainte. Un workflow26 poate avea ramificații, reîncercări automate după o eroare și pași rezolvați de un model, fără ca prin asta să devină agent27.
Un workflow26 bine proiectat are câteva proprietăți care îl fac valoros în producție:
- ordine și ramificații definite dinainte — fiecare tranziție este scrisă de un om, deci poate fi citită, revizuită și testată înainte de rulare;
- comportament repetabil — aceleași intrări produc aceleași trasee, ceea ce face ca erorile să fie reproductibile și remedierea posibilă;
- reacție clară la erori — un pas care nu reușește duce sistemul într-o situație prevăzută dinainte: se reîncearcă, se oprește sau se cheamă un om. Nu se improvizează nimic;
- urmă verificabilă — se poate răspunde oricând, exact, la întrebarea „ce pas a rulat, cu ce date și cu ce rezultat”;
- controlul versiunilor (versionare) — orice schimbare a procesului este o schimbare de cod sau de configurație, care rămâne vizibilă în istoricul proiectului: se vede cine a modificat, ce a modificat și când, iar la nevoie se poate reveni la varianta anterioară.
Workflow26-urile sunt alegerea corectă atunci când procesul este cunoscut și stabil: procesarea facturilor, generarea rapoartelor, pipeline-uri de date, aprobări care parcurg pași ficși. Devin insuficiente când pasul următor depinde de rezultate imprevizibile — acolo începe teritoriul agentului27 din secțiunea următoare. Multe sisteme reale sunt hibride: un schelet de workflow determinist10, în care doar anumiți pași sunt delegați unui model, fiecare urmat de validare.
Un detaliu de vocabular: în unele produse, „workflow26” numește și scheme care se pot întoarce din drum și pot alege singure ce urmează — adică pași care se reiau și ramificații hotărâte în timpul rulării, nu dinainte. Pentru arhitecturile software moderne, în acest curs păstrăm o distincție operațională utilă: dacă toate tranzițiile sunt proiectate dinainte, spunem workflow; dacă sistemul alege dinamic cel puțin o parte dintre acțiunile următoare în funcție de obiectiv, stare31 și feedback, spunem agent27. Sensul clasic, mai larg, al termenului „agent” este explicat în secțiunea următoare.
Analogie: un workflow26 este banda de asamblare dintr-o fabrică: fiecare stație își știe operația dinainte, piesa trece mereu prin aceleași puncte, iar dacă ceva nu se potrivește, banda se oprește și cheamă un om. Nimic nu improvizează — tocmai de aceea producția e verificabilă.
Avantaje: trasee predictibile, audit36 clar, testare mai simplă, cost controlat, evaluare de conformitate mai ușoară și risc mai mic decât în cazul unei autonomii necontrolate.
5.12 Agent
„Agent27” are un sens larg în inteligența artificială clasică și un sens operațional mai îngust în multe aplicații software moderne. Declararea sensului folosit evită contradicțiile dintre manuale, framework-uri43 și documentația furnizorilor.
În sens larg, un agent27 operează într-un mediu pentru a urmări un obiectiv: primește observații și selectează acțiuni. Mecanismul poate fi o regulă fixă, un algoritm1 de căutare, o politică învățată prin reinforcement learning sau un model de limbaj.
Un agent27 software modern conține, de regulă:
- un obiectiv sau o sarcină;
- observații de la utilizator, din fișiere, de la API-uri48 sau alte instrumente30;
- un mecanism de decizie — componenta care alege pasul următor. De cele mai multe ori este un model de limbaj (LLM16), dar poate fi la fel de bine un set de reguli, un algoritm1 de planificare sau un model antrenat special pentru sarcina respectivă;
- acțiuni sau instrumente30 permise;
- stare31 despre progres;
- o buclă care inspectează rezultatul și alege o altă acțiune;
- o condiție de oprire, de aprobare sau de solicitare a intervenției unui om.
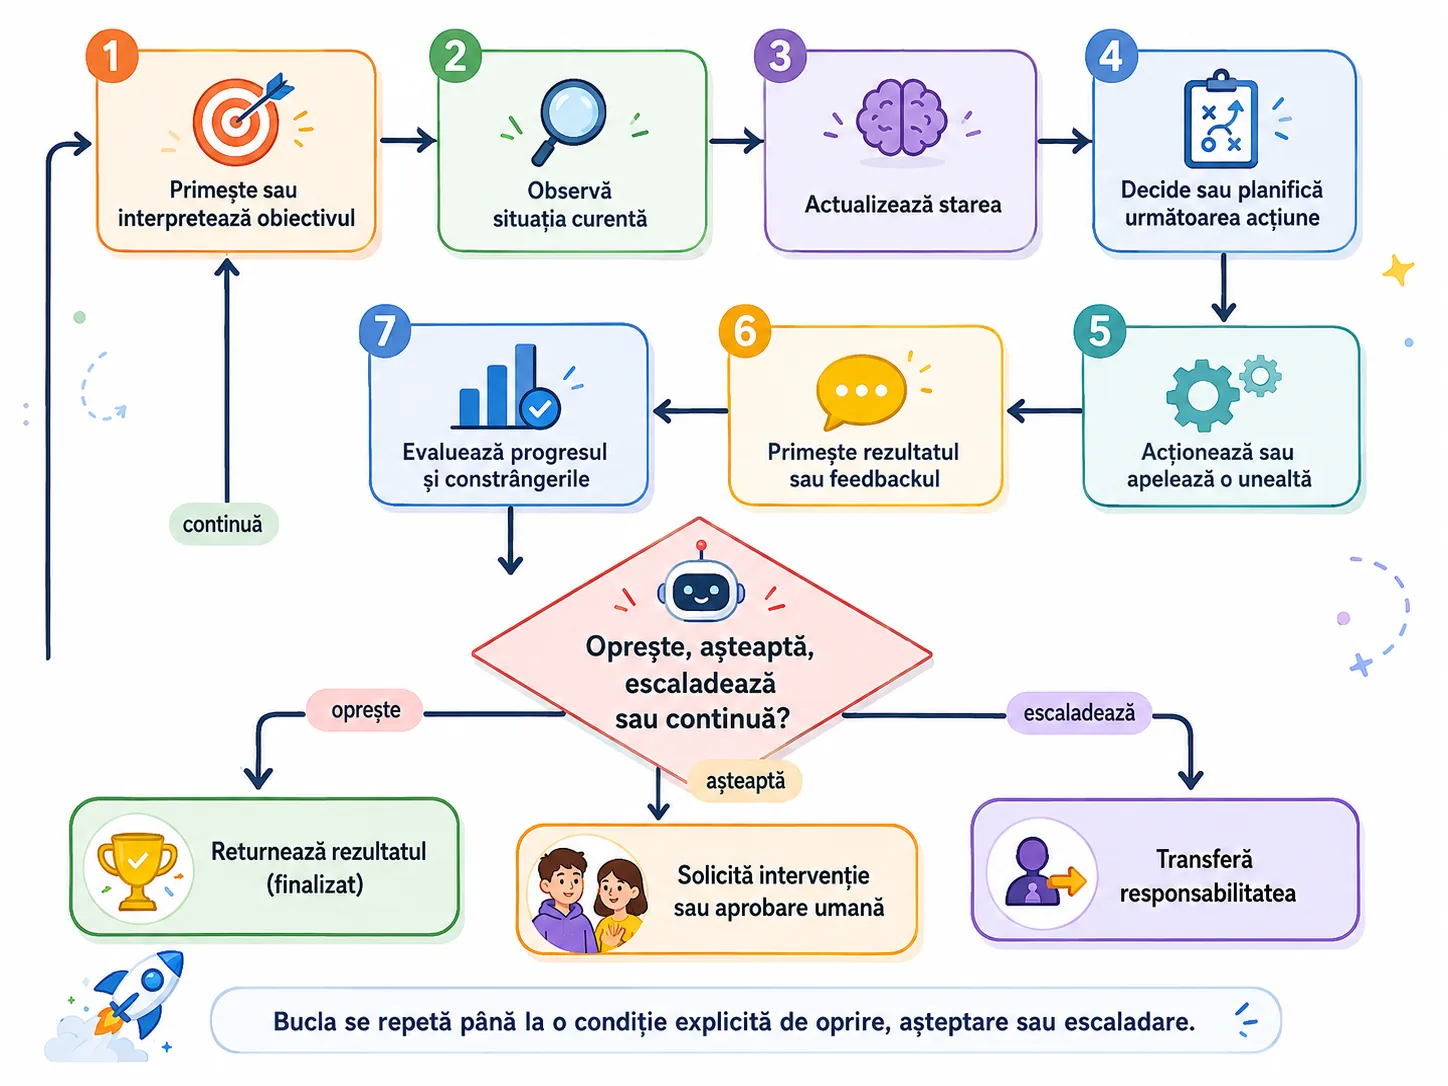
Descriere text: obiectiv → observă → decide → acționează → inspectează rezultatul → verifică oprirea sau aprobarea → continuă ori finalizează.
Pentru agentul27 software modern, ideea esențială este că cel puțin o parte dintre pași sunt aleși în timpul rulării, în funcție de stare31 și de observații, în loc să fie executată o singură secvență fixă. Un agent clasic poate fi mult mai simplu — chiar reflex și determinist10 — motiv pentru care declarăm întotdeauna sensul atunci când clasificăm un caz-limită.
Nu orice agent27 are nevoie de un LLM16. Inteligența artificială clasică lucra cu agenți cu mult înainte de modelele de limbaj: agenți reflex, care răspund direct la ce percep, după reguli fixe; agenți de planificare, care își construiesc dinainte un lanț de acțiuni către obiectiv; agenți de joc, care aleg mutarea explorând variantele posibile; și agenți antrenați prin întărire (RL), care își învață comportamentul din recompense și penalizări.
Invers este la fel de adevărat: folosirea unui LLM16 nu transformă automat un program în agent27. Când trimiți un paragraf unui model și primești înapoi un rezumat, ai făcut o singură cerere — o intrare, o ieșire, gata. Nu ai stabilit niciun obiectiv de urmărit mai departe, nu ai pus la dispoziție niciun instrument30, nu ai lăsat în urmă nicio memorie a ceea ce s-a întâmplat înainte și nu ai prevăzut niciun moment în care sistemul să decidă singur dacă merge mai departe sau se oprește. Este un apel către un model, nu un agent.
Citește bucla de mai sus încă o dată: ea descrie agentul27 software modern pe care îl vom construi în curs. Traseul complet nu este stabilit dinainte. Sistemul primește un obiectiv, inspectează situația, încearcă o acțiune, verifică rezultatul și abia atunci decide ce urmează. Tocmai această alegere bazată pe feedback îl face util acolo unde toate ramurile nu pot fi proiectate convenabil dinainte.
Asistent25 simplu sau agent27 software modern? Test practic în trei întrebări. (1) Primește doar o cerere punctuală sau urmărește un obiectiv care poate cere mai mulți pași? (2) După un rezultat intermediar, poate continua fără ca utilizatorul să-i scrie fiecare pas? (3) Alege dinamic acțiunea următoare în funcție de stare31 și feedback, sau ordinea este fixată dinainte? Dacă răspunsurile indică obiectiv persistent, continuare multi-pas și alegere dinamică, ai comportament de agent în sensul operațional modern. Faptul că aplicația se numește „asistent” și faptul că acțiunile externe cer aprobare nu schimbă singure această clasificare.
Analogie: agentul27 este instalatorul chemat pentru că nu curge apă caldă. Nu îi dictezi pașii; îi dai obiectivul. El inspectează, alege o unealtă, încearcă, verifică, alege altceva dacă nu a mers — și se oprește când apa curge sau te sună când problema îl depășește. Consilierul de la ghișeu (asistentul25) ți-ar fi explicat frumos ce ai putea face tu; instalatorul face.
5.13 Sistem autonom
Autonomia29 nu descrie cât de inteligent este sistemul, ci câtă autoritate are să acționeze fără o confirmare imediată.
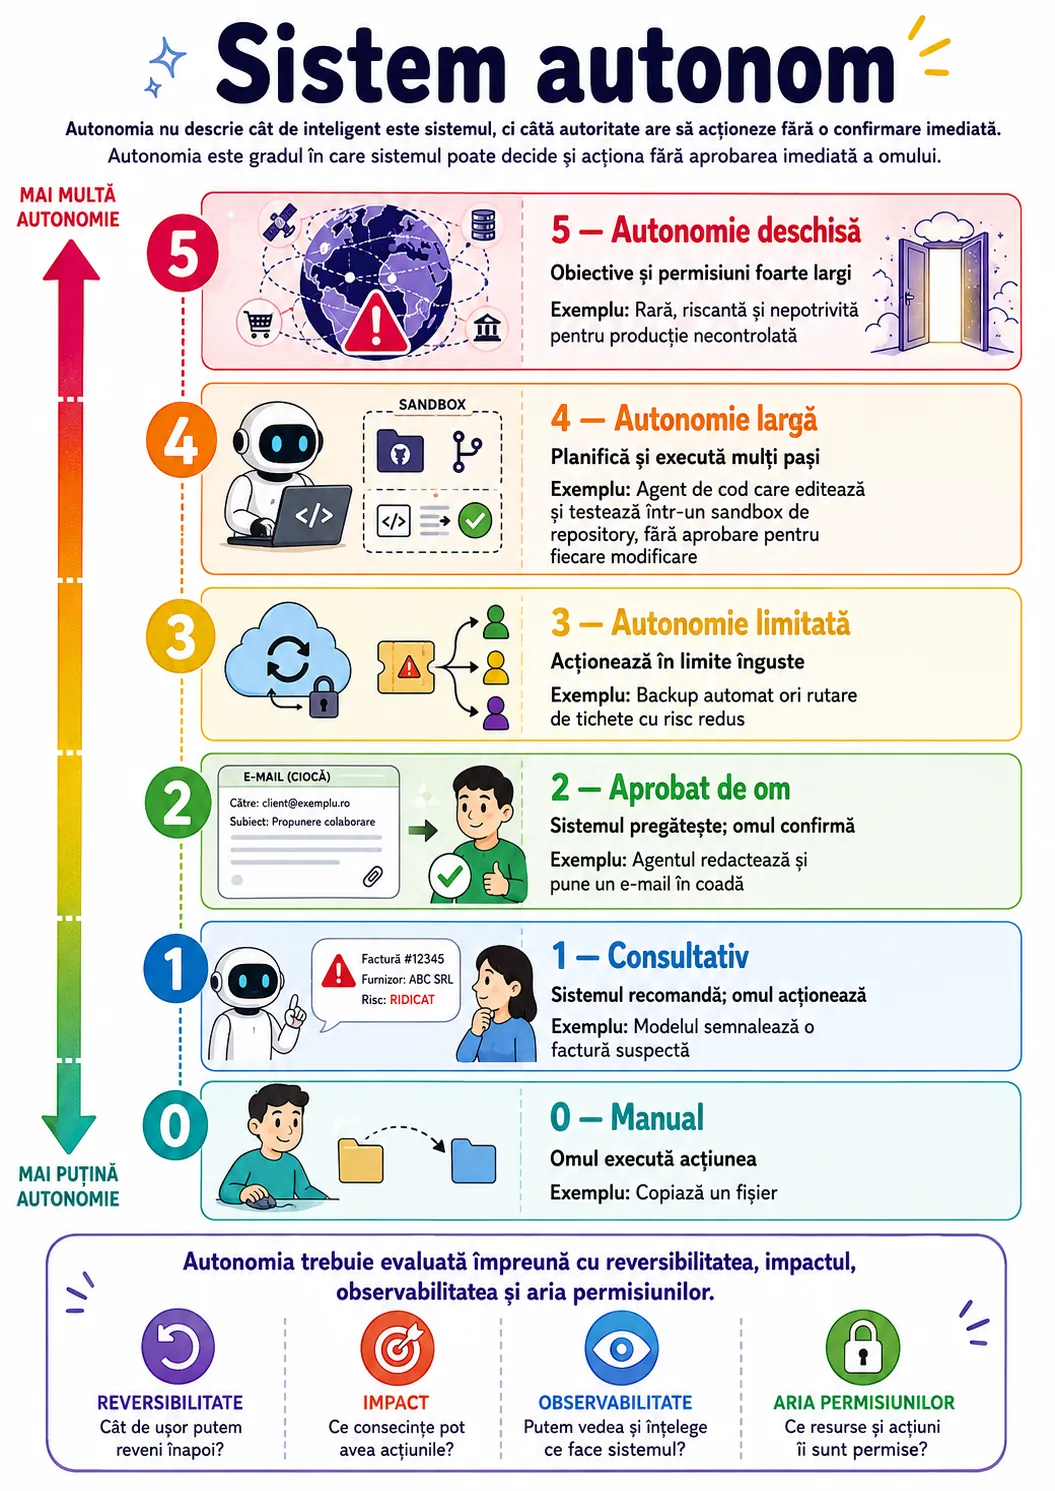
Autonomia29 se judecă întotdeauna împreună cu alte patru lucruri: cât de ușor pot fi anulate acțiunile, ce impact au, cât de bine se vede din afară ce face sistemul și cât de largi sunt permisiunile primite.
6. Cele mai importante diferențe
Această secțiune pune conceptele în perechi deoarece cele mai multe confuzii apar între termeni apropiați. Pentru fiecare pereche analizăm exact criteriul care îi separă.
6.1 AI versus automatizare
Comparația separă capacitățile asociate inteligenței de simpla execuție automată a unui proces.
- AI descrie capabilități precum învățarea, percepția, raționamentul sau limbajul.
- Automatizarea3 descrie rularea unui proces fără ca un om să execute fiecare pas.
Un backup nocturn este automatizat, dar nu are nimic inteligent în el. Un model care recomandă un diagnostic poate folosi AI, rămânând complet consultativ.
6.2 Machine learning versus AI generativă
Comparația separă învățarea de tipare din date de producerea unor ieșiri noi.
Machine learning5 este domeniul mai larg al sistemelor care învață tipare. AI generativă9 este familia care produce secvențe sau artefacte noi. Un exemplu lămurește diferența: sistemul care dă fiecărei tranzacții cu cardul o notă de risc — „cât de probabil este ca plata asta să fie o fraudă” — este machine learning. A învățat din milioane de tranzacții trecute, marcate ca frauduloase sau curate, iar acum produce un număr pentru fiecare plată nouă. Nu este AI generativă, pentru că nu creează niciun conținut nou: doar evaluează ceva ce există deja.
6.3 Model versus agent
Comparația separă componenta care produce predicții sau text de sistemul complet care urmărește un obiectiv și utilizează instrumente30.
- Un model transformă o intrare într-o ieșire.
- Un agent27 organizează decizii și acțiuni în timp.
Modelul poate fi doar o componentă din agent27.
6.4 Workflow versus agent
Comparația arată dacă traseul execuției este proiectat dinainte sau ales dinamic în funcție de observații.
Workflow-ul26 urmează o cale prestabilită; agentul27 alege dintre acțiuni pe baza observațiilor și obiectivului. Produsele mai complexe combină frecvent cele două abordări: workflow-ul ține procesul sub control, iar agentul se ocupă de porțiunea ambiguă, cea care nu putea fi proiectată dinainte.
6.5 Asistent versus agent
Comparația separă interfața orientată către utilizator de arhitectura internă de control.
„Asistent25” descrie relația cu utilizatorul; „agent27” descrie arhitectura de control. Un asistent poate fi agent sau nu. Un agent poate lucra fără interfață conversațională.
6.6 Agentic versus autonom
Comparația separă comportamentul de selectare a acțiunilor de permisiunea efectivă de a le executa.
„Agentic27” indică folosirea unui mecanism asemănător agentului: planificare, instrumente30, buclă de observație și acțiune. „Autonom” indică permisiunea efectivă de a acționa fără aprobare. Un sistem poate fi agentic și totuși blocat la fiecare acțiune importantă.
7. Metodă practică de clasificare
În continuare vom transforma definițiile într-o procedură repetabilă: șapte întrebări, puse mereu în aceeași ordine, care clasifică orice sistem software — indiferent de numele lui comercial.
Pasul 0 — delimitează sistemul. Metoda se aplică software-ului, nu obiectelor fizice. O pâine sau o ladă de cartofi nu au „comportament” — dar software-ul din jurul lor are: magazinul online care primește comenzi de legume, casa de marcat care aplică TVA, motorul care recomandă „clienții au cumpărat și…”. Înainte de orice întrebare, spune exact ce bucată de software analizezi și unde îi sunt granițele: ce intră în ea, ce iese din ea și ce sisteme atinge. Abia apoi întrebările au sens.
Prin comportament înțelegem tot ce face sistemul ca reacție la intrări: ce ieșiri produce (un număr, o etichetă, un scor, un text, o imagine) și ce acțiuni execută (salvează, trimite, modifică, pornește ceva). Întrebarea „ce produce comportamentul?” nu se referă deci la personalitatea produsului, ci la mecanismul din spatele acestor reacții.
Regula de aur: folosește întrebările în ordine și nu porni niciodată de la numele produsului. Numele este marketing; comportamentul este inginerie.
Întrebarea 1 — Ce produce comportamentul sistemului?
Privește mecanismul care transformă intrarea în ieșire:
- reguli explicite — cod scris de oameni: „dacă totalul depășește 100 de lei, cere aprobare”;
- metode statistice — praguri și relații calculate din date: „blochează tranzacția dacă suma e de 10 ori peste media clientului”;
- model învățat — parametri12 ajustați prin antrenare13 pe exemple: filtrul de spam care a văzut milioane de e-mailuri etichetate;
- o combinație — cazul cel mai frecvent în produsele reale.
Cum afli: citește documentația tehnică și caută formulări precum „trained on”, „rule-based” sau „threshold”; uită-te la configurație și la ce date cere sistemul ca să funcționeze.
Întrebarea 2 — Ce produce sistemul?
Acum privește ieșirea, nu mecanismul:
- un calcul exact — TVA-ul unei facturi;
- o etichetă sau un scor — „spam”, „0,93 probabilitate de fraudă”;
- o recomandare — „ai putea adăuga și roșii la comandă”;
- face conținut nou — redactează e-mailul, generează imaginea, dar se oprește aici: rezultatul rămâne la tine;
- acționează pe baza noului conținut — chiar trimite e-mailul, chiar scrie în baza de date, chiar plătește factura.
Diferența dintre ultimele două este granița cea mai importantă din întreaga lecție: a propune nu este totuna cu a face.
Întrebarea 3 — Cum este ales pasul următor?
- există un singur răspuns — o funcție pură: intră numerele, iese suma;
- pașii sunt fixați — scriptul de backup rulează aceiași pași în fiecare noapte;
- există ramuri51 prestabilite — „dacă lipsește data, cere data; altfel continuă”;
- sistemul alege dinamic — după fiecare observație decide singur ce încearcă în continuare, în funcție de obiectiv.
Indiciul practic pentru agenții27 software moderni: întreabă cine a stabilit traseul complet al pașilor. Dacă toate tranzițiile au fost scrise de un om dinainte, ai un workflow26. Dacă sistemul alege în timpul rulării cel puțin o parte dintre acțiunile următoare pe baza obiectivului, stării31 și feedbackului, ai comportament de agent în sensul operațional modern. În sensul clasic, mai larg, pot exista și agenți reflex deterministici; de aceea cazurile-limită trebuie etichetate cu definiția folosită.
Întrebarea 4 — Are instrumente?
Un instrument30 este orice poate fi apelat: o bază de date, un calculator, un sistem de fișiere, un API48 de plăți. Accesul la instrumente crește simultan utilitatea și riscul. Dar un singur apel de instrument nu dovedește un agent27: contează cine alege instrumentul și dacă rezultatul lui influențează pasul următor.
Întrebarea 5 — Păstrează stare?
Starea31 înseamnă că sistemul ține minte unde a ajuns: pași executați, rezultate intermediare, un plan, o sesiune. Un formular cu „pasul 2 din 4” are stare; un calculator de buzunar nu are. Fără stare nu există progres; fără progres nu există buclă reală — iar un agent27 fără memorie despre propriul progres repetă sau se contrazice.
Întrebarea 6 — Ce autoritate are?
- doar răspunde — îți arată scrisoarea;
- pregătește o acțiune — scrisoarea este gata, tu apeși „trimite”;
- acționează după aprobare — trimite după ce confirmi;
- acționează automat în limite — trimite singur, dar numai către adrese interne;
- are permisiuni largi — trimite oricui, oricând.
Cum afli: autoritatea se citește din permisiunile reale — chei API48, drepturi de scriere, acces la rețea — nu din felul în care arată interfața.
Întrebarea 7 — Cum se oprește?
Caută o condiție explicită: obiectiv atins, buget de pași epuizat, timp expirat, eroare, cerere de aprobare, rezultat imposibil sau nevoia de intervenție umană. În producție, întrebarea matură nu este „cât de deștept este sistemul?”, ci „când și cum se oprește?”. Fără o oprire clară, o buclă nu este pregătită pentru lumea reală.
Metoda aplicată: magazinul online de legume
Să răspundem la confuzia firească „dar dacă eu vând cartofi?”. Cartoful nu se clasifică; software-ul din jurul lui, da. Delimităm sistemul: motorul de recomandări al magazinului.
- Ce produce comportamentul? Un model învățat din istoricul comenzilor.
- Ce produce? O recomandare — „clienții care au luat cartofi au luat și varză”.
- Cum alege pasul următor? Un singur răspuns per pagină afișată; nicio buclă.
- Are instrumente30? Doar citește catalogul; nu modifică nimic.
- Păstrează stare31? Da — istoricul clientului.
- Ce autoritate are? Doar recomandă; clientul decide.
- Cum se oprește? După fiecare afișare.
Concluzie: machine learning5 + control simplu + autoritate consultativă. Nu este agent27, oricât de „inteligent” ar părea în reclamă.
Aplică acum aceleași șapte întrebări casei de marcat din același magazin și obții un profil complet diferit: reguli explicite în loc de model învățat, un calcul exact în loc de o recomandare, zero autonomie29. Două mecanisme care nu seamănă deloc — și totuși același verdict: nici unul, nici celălalt nu este agent27. Exact asta face metoda utilă. Nu întreabă cât de avansată este tehnologia din spate, ci cine alege pașii și cine are voie să acționeze; iar la aceste două întrebări casa de marcat și motorul de recomandări răspund la fel, deși unul învață din date și celălalt doar aplică reguli scrise de oameni.
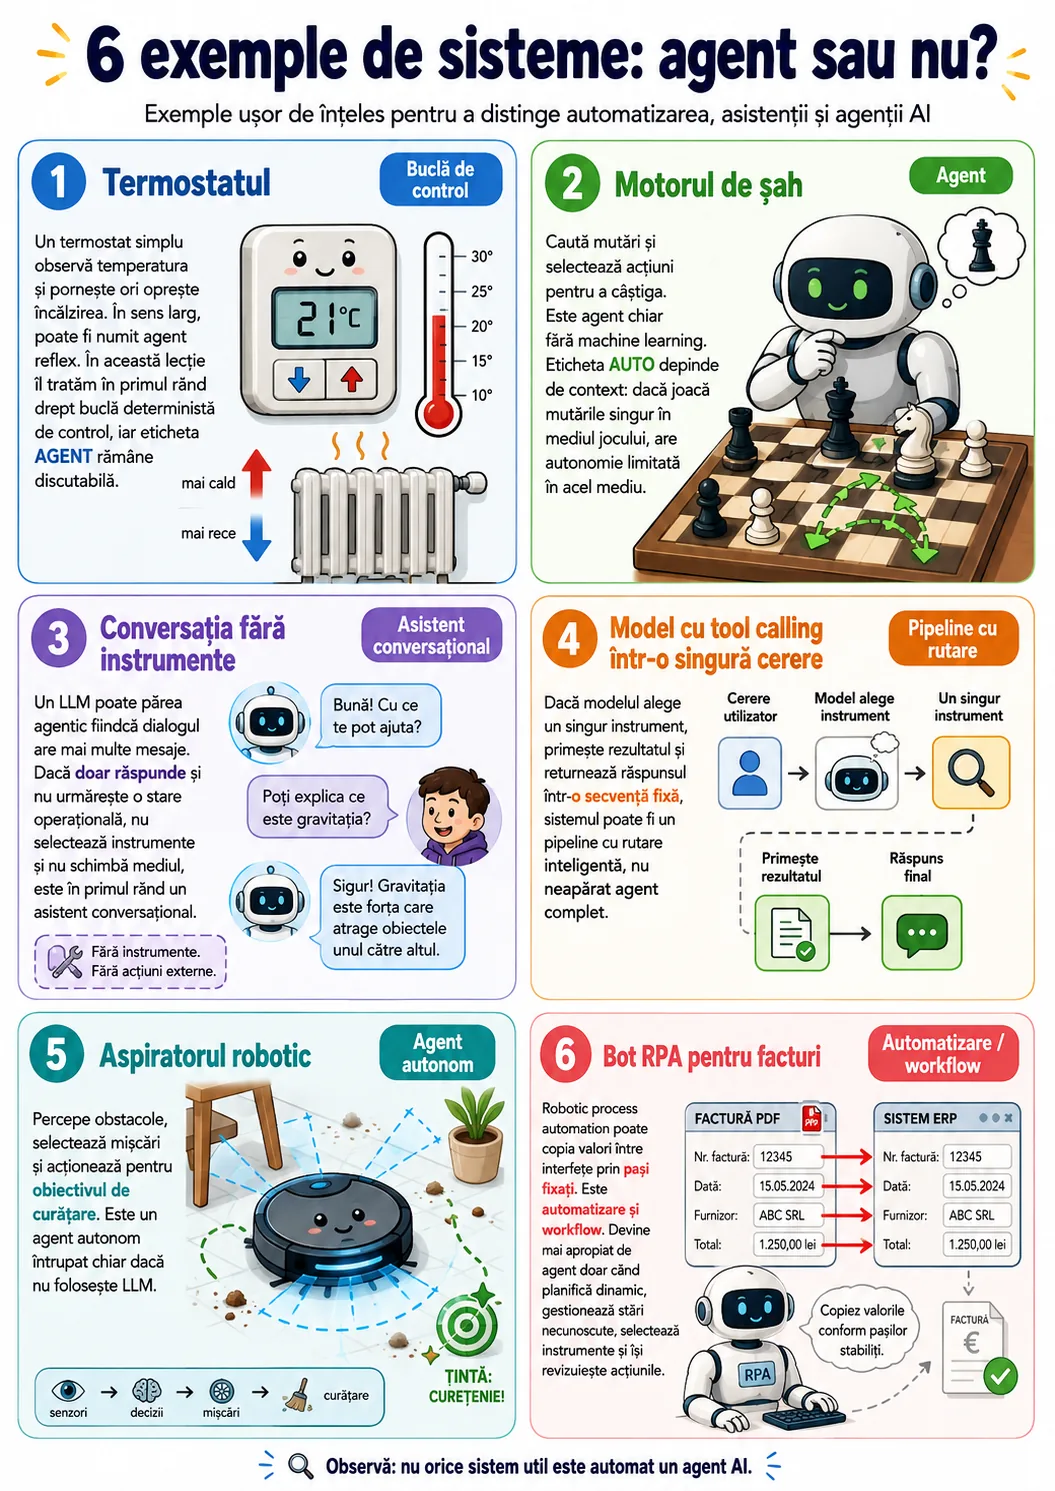
8. Cazuri-limită
Cazurile-limită sunt importante deoarece unele sisteme pot fi descrise corect în mai multe moduri, în funcție de granițele pe care le alegem. Scopul nu este să memorăm un răspuns unic, ci să ne declarăm ipotezele.
9. Principiu arhitectural: sistemele hibride câștigă
În aplicațiile reale, rezultatele cele mai bune provin de obicei din distribuirea responsabilităților între modele probabilistice11, cod determinist10, date verificate și oameni.
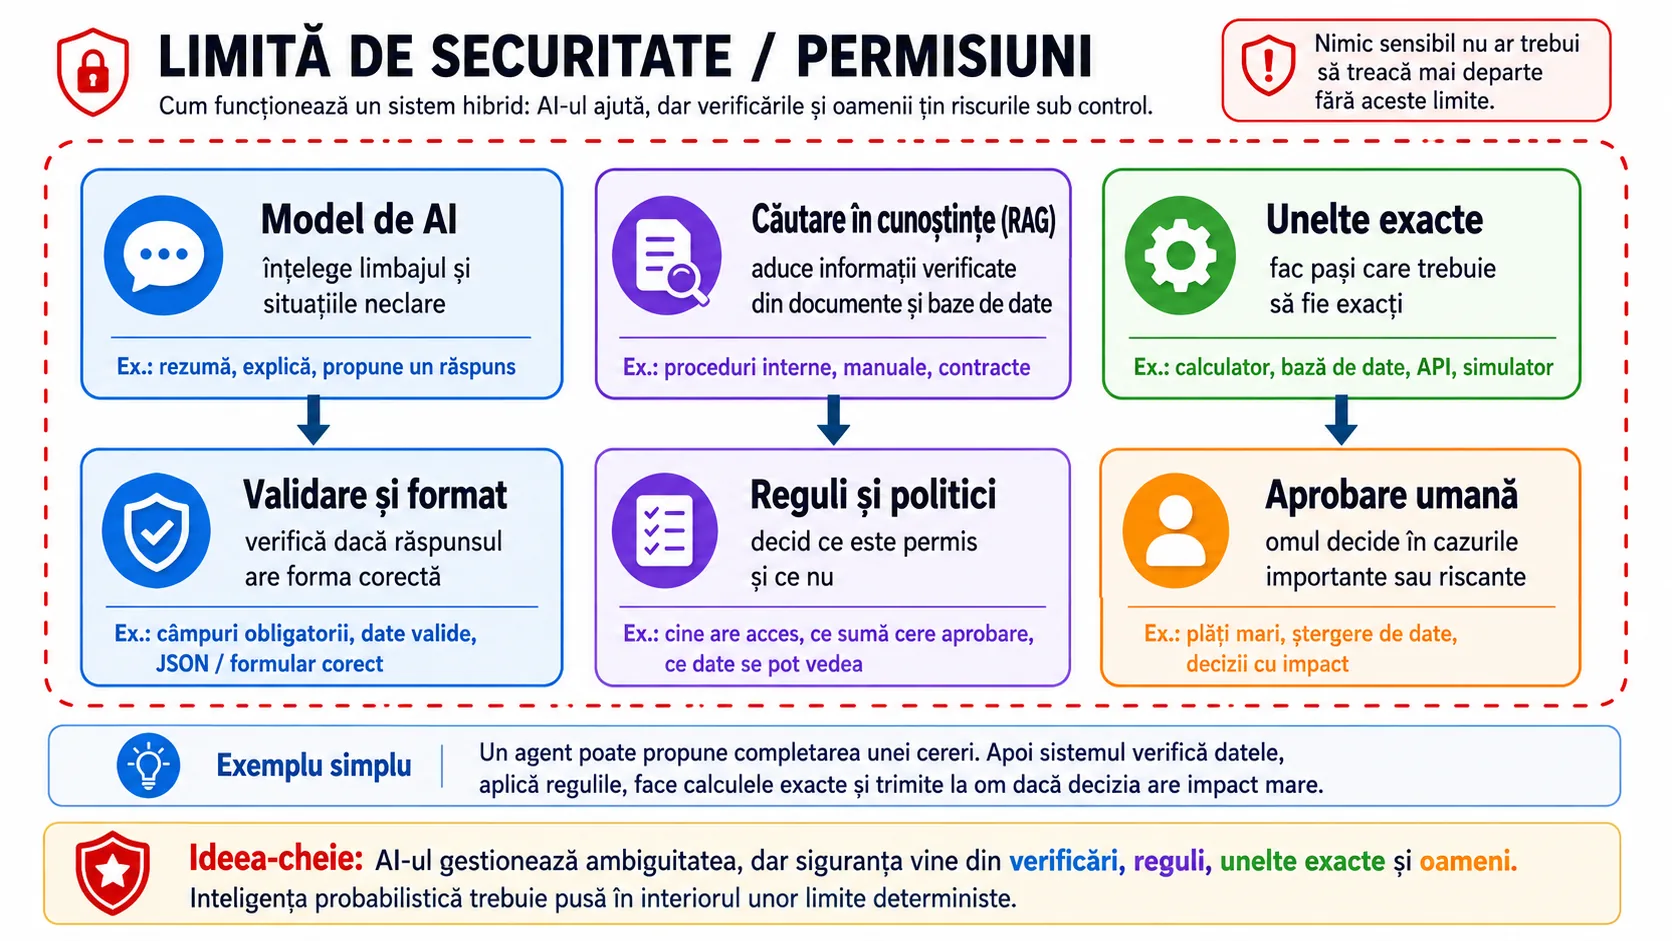
Produsele fiabile rareori folosesc aceeași tehnică peste tot.
Un sistem puternic poate folosi:
- reguli pentru permisiuni și câmpuri obligatorii;
- ML5 pentru a depista abaterile de la normal — o plată neobișnuit de mare, un consum ieșit din tipar;
- un foundation model8 pentru limbaj;
- retrieval pentru cunoștințe private și actuale;
- calculator ori simulator pentru calcule exacte;
- workflow26 pentru pași verificabili și urmă clară a execuției;
- agent27 pentru coordonare flexibilă;
- om pentru judecată cu impact mare.
Principiul practicii moderne: plasează inteligența probabilistică11 în interiorul unor limite deterministe10.
10. Mituri frecvente
Această secțiune verifică afirmații des întâlnite în marketing și conversații informale. Fiecare mit este reformulat într-un criteriu tehnic care poate fi testat.
Mitul 1 — AI înseamnă machine learning
Machine learning5 este o abordare majoră, dar planificarea, căutarea, optimizarea, logica simbolică și sistemele de reguli fac și ele parte din istoria și practica AI.
Prin urmare, AI nu înseamnă doar machine learning5: este un domeniu mult mai larg, iar o bună parte din el nu învață absolut nimic din date.
Mitul 2 — Orice aplicație LLM este agent
Un apel de model nu reprezintă o buclă de agent27. Când o aplicație trimite un text unui LLM16 și afișează răspunsul primit, ea a făcut o singură cerere: nu urmărește niciun obiectiv mai departe, nu alege instrumente30, nu ține minte unde a ajuns și nu decide dacă mai continuă. Întrebarea corectă nu este „folosește un model de limbaj?”, ci „cine alege pasul următor și pe baza a ce observă?”. Un editor de text care rescrie un paragraf la cerere folosește exact același model ca un agent de programare — și totuși unul este o funcție, iar celălalt un sistem care lucrează singur.
Prin urmare, într-o aplicație LLM16 modernă nu numim sistemul agent27 doar fiindcă folosește un model: căutăm un obiectiv urmărit în timp, stare31 sau feedback despre progres și alegerea dinamică a cel puțin unei părți din pașii următori. Instrumentele30 apar frecvent atunci când sistemul trebuie să acționeze sau să obțină informații externe.
Mitul 3 — Mai multă autonomie înseamnă mai multă inteligență
Autonomia29 este permisiunea de a acționa. Un script simplu poate fi autonom; un model sofisticat poate rămâne consultativ.
Prin urmare, inteligența și autonomia29 sunt două axe diferite: se pot combina în orice fel, iar creșterea uneia nu o ridică niciodată pe cealaltă.
Mitul 4 — Regulile sunt depășite
Regulile rămân cea mai bună reprezentare pentru multe calcule, permisiuni, constrângeri și cerințe de siguranță.
Prin urmare, regulile nu sunt o etapă depășită, ci exact partea pe care nu vrei să o lași la latitudinea unui model: acolo unde răspunsul trebuie să fie exact și identic de fiecare dată, regula rămâne soluția corectă.
Mitul 5 — Agentul trebuie să fie chatbot
Agenții27 pot opera prin API-uri48, joburi de fundal, roboți, terminal, sisteme industriale sau fără conversație vizibilă.
Prin urmare, conversația este doar o interfață posibilă, nu o condiție: cei mai mulți agenți27 din producție nu vorbesc cu nimeni.
Mitul 6 — Agentul este modelul
Modelul este adesea o singură componentă. Agentul27 are și orchestrare, instrumente30, stare31, permisiuni, evaluări și condiții de oprire.
Prin urmare, modelul este piesa care decide, dar agentul27 este întregul montaj din jurul ei — iar cea mai mare parte din muncă stă în montaj, nu în model.
Mitul 7 — Primul pas este antrenarea
Majoritatea agenților27 specializați trebuie să înceapă cu un model existent, instrumente30 bune, retrieval, instrucțiuni și evaluări. Antrenarea13 devine justificată după identificarea unei limitări măsurate.
Prin urmare, antrenarea13 nu este primul pas, ci ultimul: se justifică abia după ce ai măsurat o limitare pe care instrucțiunile, instrumentele30 și retrieval-ul* nu o pot acoperi.
Retrieval* înseamnă căutarea automată a informației relevante în surse externe — documentele firmei, o bază de date, un set de fișiere — și adăugarea fragmentelor găsite în cererea trimisă modelului. Modelul nu învață nimic nou: primește pur și simplu, odată cu întrebarea, textul de care are nevoie ca să răspundă.
Mitul 8 — Multi-agent este automat mai bun
Mai mulți agenți27 adaugă erori de coordonare, latență, cost și dificultăți de observabilitate. Începe cu un agent sau workflow26 determinist10 și adaugă specializare doar când valoarea poate fi măsurată.
Prin urmare, mai mulți agenți27 nu înseamnă automat un sistem mai bun: pornește de la unul singur și adaugă al doilea abia când poți arăta, cu cifre, ce câștigi.
11. Provocare interactivă: clasifică 25 de sisteme
Această activitate verifică dacă poți aplica simultan cele trei axe. Pentru fiecare sistem bifează toate etichetele pe care le consideri potrivite. Unele cazuri acceptă o etichetă opțională atunci când este justificată printr-o definiție mai largă. Citește întâi ce înseamnă exact fiecare etichetă — sunt aceleași șase pe care le vei folosi la toate cele 25 de întrebări.
Bifează etichetele pe care le consideri potrivite pentru fiecare sistem. Apoi deschide răspunsul recomandat. Răspunsul recomandat apare imediat sub fiecare întrebare și funcționează chiar dacă JavaScript este dezactivat.
1. Un calculator de buzunar evaluează 17 × 43.
Verifică răspunsul
Etichete recomandate: algoritm1
Rezultatul vine dintr-o procedură fixă de calcul, scrisă de oameni: aceleași două numere dau întotdeauna 731, deci algoritm1.
Nu există niciun model învățat din exemple, deci nu este machine learning5. Un număr calculat nu este conținut nou, deci nu generează conținut. Nu există pași înlănțuiți dinainte, deci nu este flow. Aparatul nu urmărește niciun obiectiv și nu alege nimic: așteaptă să apeși tastele — deci nici agent27, nici automat.
2. Un model lingvistic scrie o poezie dintr-un singur prompt.
Verifică răspunsul
Etichete recomandate: machine learning5, generează conținut
Textul este produs de un model antrenat pe cantități mari de date (machine learning5), iar poezia este conținut nou, compus pe loc (generează conținut).
Aici se oprește: o cerere, un răspuns. Nu există pași stabiliți dinainte (nu este flow), nu există obiectiv urmărit prin mai multe acțiuni și niciun instrument30 apelat (nu este agent27), iar textul apare pe ecran fără ca sistemul să schimbe ceva în lume (nu este automat). Eticheta algoritm1 nu apare deși, evident, există cod care rulează modelul: o folosim pentru sistemele al căror comportament vine din reguli scrise de om, iar aici comportamentul vine din model.
3. Un bot RPA (robotic process automation — un program care imită clicurile și tastările unui om în alte aplicații) copiază câmpuri de factură între două aplicații, prin pași fixați dinainte.
Verifică răspunsul
Etichete recomandate: algoritm1, flow, automat
Pașii sunt scriși de un om și se repetă identic (algoritm1), sunt înlănțuiți într-o ordine stabilită dinainte (flow), iar botul execută copierea singur, fără să ceară confirmare la fiecare câmp (automat).
Nu învață nimic din exemple — dacă interfața aplicației se schimbă, botul se strică (nu este machine learning5). Nu compune nimic nou, ci mută valori existente (nu generează conținut). Și nu alege nimic în timpul rulării: dacă apare o situație neprevăzută, se oprește cu eroare, nu caută o soluție (nu este agent27).
4. Un model bancar atribuie unei tranzacții un scor de risc de fraudă.
Verifică răspunsul
Etichete recomandate: machine learning5
Scorul de risc vine dintr-un model antrenat pe tranzacții trecute, nu dintr-un set de praguri scrise de un analist (machine learning5).
Ieșirea este un număr, nu conținut nou (nu generează conținut). Modelul nu blochează cardul și nu sună clientul: el doar evaluează, iar acțiunea aparține altei componente sau unui om — de aceea nu este nici automat, nici agent27. Dacă am eticheta întregul sistem antifraudă, cu regulile lui de blocare, s-ar adăuga algoritm1, flow și automat; întrebarea de aici este însă despre model.
5. Un sistem de cod planifică modificări, editează fișiere, rulează teste, observă erori și încearcă din nou.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5, generează conținut, agent27, automat
Sistemul primește un obiectiv, observă rezultatul testelor, alege singur ce corectează și reia ciclul: aceasta este bucla care definește un agent27. Editează fișiere și rulează comenzi fără să ceară voie la fiecare pas (automat), scrie cod nou (generează conținut), folosește un model antrenat (machine learning5) și, în jurul lui, cod determinist10 scris de oameni — rularea testelor, citirea fișierelor (algoritm1).
Singura etichetă care lipsește este flow, și tocmai ea face diferența: succesiunea pașilor nu este stabilită dinainte, ci rezultă din ce observă sistemul după fiecare încercare.
6. O foaie de calcul recalculează totalurile când se schimbă datele din celule.
Verifică răspunsul
Etichete recomandate: algoritm1. Etichete acceptabile în anumite definiții: flow.
Formulele sunt reguli scrise de om, iar recalcularea este complet deterministă10: aceleași valori dau același total (algoritm1).
Flow este acceptabil dacă privești lanțul de dependențe dintre celule ca pe un micro-workflow26 declanșat de fiecare modificare — de aceea apare ca etichetă opțională, nu greșită. Nu învață nimic (nu este machine learning5), nu produce conținut nou, ci numere calculate (nu generează conținut), nu urmărește un obiectiv (nu este agent27) și nu acționează în afara documentului (nu este automat).
7. Un aspirator robotic cartografiază camerele și schimbă traseul când este blocat.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5, agent27, automat
Aspiratorul are un obiectiv (curăță suprafața), observă mediul prin senzori, iar când se blochează alege alt traseu în timpul rulării — deci agent27. Se deplasează și aspiră fără ca cineva să confirme fiecare mișcare (automat). Logica de acoperire a camerei și regulile de siguranță sunt scrise de oameni (algoritm1), iar recunoașterea obstacolelor și a tipului de podea folosește componente învățate (machine learning5).
Nu produce conținut (nu generează conținut) și nu urmează o listă de pași fixată dinainte, fiindcă traseul se schimbă în funcție de ce întâlnește (nu este flow). La un aspirator foarte simplu, construit numai din reguli, eticheta machine learning5 nu s-ar aplica.
8. Un bot de suport urmează un arbore fix de răspunsuri FAQ (frequently asked questions — întrebări puse frecvent).
Verifică răspunsul
Etichete recomandate: algoritm1, flow
Întrebările, răspunsurile și ramurile sunt scrise de oameni (algoritm1) și sunt parcurse într-o structură stabilită dinainte, aceeași pentru toți utilizatorii (flow).
Nu învață din conversații (nu este machine learning5) și nu compune text, ci alege dintr-un set existent de răspunsuri (nu generează conținut). Pasul următor nu este ales de bot, ci de butonul pe care apasă utilizatorul (nu este agent27), iar în afara conversației nu se întâmplă nimic (nu este automat). Faptul că vorbește nu îl apropie deloc de un agent — este mitul 5 văzut invers: conversația nu face agentul, la fel cum lipsa ei nu îl împiedică.
9. Un motor de căutare ordonează pagini pentru o interogare.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5
Indexarea, potrivirea și afișarea sunt cod determinist10 scris de ingineri (algoritm1), iar ordonarea rezultatelor este calculată de modele învățate din comportamentul utilizatorilor (machine learning5).
Motorul nu scrie text, ci ordonează pagini care există deja (nu generează conținut). Fiecare interogare este tratată separat, fără obiectiv păstrat între căutări și fără instrumente30 apelate în numele tău (nu este agent27), iar afișarea unei liste nu schimbă nimic în lume (nu este automat). Un motor care adaugă deasupra un rezumat scris de model ar primi și eticheta generează conținut — dar acela este alt produs.
10. Un termostat tradițional pornește căldura sub 19 °C.
Verifică răspunsul
Etichete recomandate pentru sensul operațional modern al quizului: algoritm1, automat. În sensul clasic, larg al AI: și agent27.
Comportamentul vine dintr-o singură regulă scrisă de om — sub 19 °C pornește căldura (algoritm1) — iar termostatul comandă centrala fără să întrebe pe nimeni (automat).
În literatura clasică de AI, termostatul este exemplul tipic de agent27 reflex: percepe mediul și selectează o acțiune după o regulă. În clasificarea operațională folosită de acest quiz pentru agenți software moderni, nu îl bifăm drept agent deoarece nu urmărește progresul unei sarcini multi-pas și nu alege dinamic o strategie pe baza feedbackului. Ambele descrieri sunt coerente dacă spui de la început ce sens al cuvântului „agent” folosești. Nu învață (nu este machine learning5) și nu produce conținut.
11. Un sistem investighează o factură lipsă, interoghează date, redactează un mesaj și așteaptă aprobarea înainte de trimitere.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5, generează conținut, flow, agent27
Sistemul urmărește un obiectiv — lămurește ce s-a întâmplat cu factura — interoghează surse, evaluează ce a găsit și decide ce face mai departe (agent27). Redactează un mesaj nou (generează conținut) cu ajutorul unui model antrenat (machine learning5), folosește interogări și validări deterministe10 (algoritm1) și are și pași ficși, stabiliți de proiectant: ce surse se verifică și în ce ordine (flow).
Eticheta care lipsește este automat, și lipsește dintr-un motiv esențial: trimiterea mesajului este blocată până când un om aprobă. Aici se vede limpede că agent27 și automat sunt două axe diferite — sistemul alege singur pașii de investigare, dar nu are autoritatea de a acționa în exterior.
12. Un telefon detectează fețe pentru a focaliza camera.
Verifică răspunsul
Etichete recomandate: machine learning5
Detectarea fețelor este făcută de un model antrenat pe imagini (machine learning5).
Ieșirea lui este o poziție în cadru, nu conținut nou (nu generează conținut). Nu urmărește un obiectiv prin mai mulți pași și nu alege între acțiuni (nu este agent27). Nu apare nici eticheta automat, fiindcă discutăm despre detector: el livrează o coordonată, iar focalizarea propriu-zisă o execută mecanismul camerei. Dacă ai eticheta aparatul foto ca întreg, eticheta automat ar putea fi susținută — iar asta este exact genul de ipoteză care trebuie declarată.
13. Un motor clasic de șah caută mutări cu logică de evaluare proiectată manual.
Verifică răspunsul
Etichete recomandate: algoritm1, agent27. Etichete acceptabile în anumite definiții: automat.
Căutarea în arborele de mutări și funcția de evaluare sunt scrise de oameni, fără nimic învățat din date (algoritm1). Cu toate acestea, motorul are un obiectiv — câștigarea partidei — evaluează poziția și alege singur mutarea dintre multe posibile, deci este agent27.
Este exemplul care demontează ideea că „agent27” înseamnă AI modernă: nu există niciun model antrenat aici (nu este machine learning5), iar mutarea aleasă nu este conținut generat (nu generează conținut). Automat este acceptabil dacă motorul își execută singur mutările pe tablă; dacă doar recomandă mutarea unui om, eticheta nu se aplică.
14. Un LLM răspunde la întrebări, dar nu are acces la instrumente sau datele clienților.
Verifică răspunsul
Etichete recomandate: machine learning5, generează conținut
Răspunsurile vin dintr-un model antrenat (machine learning5) și sunt text nou, compus pe loc (generează conținut).
Enunțul spune explicit ce lipsește: fără instrumente30 și fără acces la date, sistemul nu poate nici alege acțiuni, nici executa ceva — deci nici agent27, nici automat. Comparat cu exemplul 5, modelul poate fi identic; diferența stă în ce i s-a permis să atingă. Acesta este mitul 2 în formă pură: folosirea unui LLM16 nu produce, singură, un agent.
15. Un job cron — o sarcină programată să pornească singură la o oră fixă — copiază un folder pe un disc de backup în fiecare noapte.
Verifică răspunsul
Etichete recomandate: algoritm1, flow, automat
Comenzile de copiere sunt scrise de om (algoritm1), rulează mereu în aceeași ordine (flow), iar sarcina pornește la ora stabilită fără ca cineva să apese ceva (automat).
Nu învață și nu produce conținut. Nu este agent27, deși rulează singur: dacă discul este plin, jobul se oprește cu eroare, în timp ce un agent ar căuta o alternativă sau ar anunța pe cineva. Exemplul arată că „autonom” în sens operațional — pornește fără om — nu are legătură cu inteligența.
16. Un prototip de conducere autonomă percepe drumul și controlează direcția și viteza într-o zonă de test.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5, agent27, automat
Percepția drumului este făcută de modele antrenate (machine learning5), în jurul lor există control și reguli de siguranță scrise de ingineri (algoritm1), sistemul alege manevrele în timp real în funcție de ce observă (agent27) și acționează fizic asupra direcției și vitezei (automat).
Nu produce conținut: ieșirile lui sunt comenzi de control, nu text sau imagini (nu generează conținut), și nu urmează o secvență fixată dinainte (nu este flow). Combinația dintre agent27, automat și efect fizic este exact motivul pentru care astfel de sisteme rulează întâi în zone de test, cu limite stricte.
17. Un serviciu de streaming recomandă filme pe baza vizionărilor.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5
Ordonarea recomandărilor este calculată de modele învățate din istoricul vizionărilor (machine learning5), iar în jurul lor există cod determinist10 care filtrează catalogul și compune pagina (algoritm1).
Sistemul alege dintre filme existente, nu creează nimic (nu generează conținut). Nu urmărește un obiectiv prin acțiuni succesive și nu apelează instrumente30 în numele tău (nu este agent27), iar afișarea unei liste nu este o acțiune asupra lumii (nu este automat). Un sistem care ar cumpăra singur licențe pe baza acestor predicții ar fi cu totul altceva.
18. Un robot industrial repetă aceeași traiectorie de sudură.
Verifică răspunsul
Etichete recomandate: algoritm1, flow, automat
Traiectoria este programată de oameni (algoritm1), pașii se execută în aceeași ordine la fiecare piesă (flow), iar robotul lucrează fără operator lângă el (automat).
Nu percepe și nu se adaptează: dacă piesa este așezată strâmb, sudura iese strâmb. De aceea nu este agent27, deși este o mașină impresionantă și periculoasă. Nu învață nimic (nu este machine learning5) și nu produce conținut. Este cel mai clar exemplu că automatizarea3 nu presupune AI.
19. Un asistent de documente recuperează pasaje și scrie un răspuns cu citări.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5, generează conținut, flow. Etichete acceptabile în anumite definiții: agent27.
Sistemul rulează un lanț stabilit dinainte — caută pasaje, le trimite modelului, compune răspunsul, atașează citările (flow și algoritm1) — folosind un model antrenat (machine learning5) care scrie text nou (generează conținut).
Agent27 apare ca etichetă opțională fiindcă totul depinde de o singură întrebare: cine decide dacă mai este nevoie de o căutare? Într-un RAG18 obișnuit, lanțul este fix, deci nu este agent. Într-un RAG agentic — sistemul evaluează ce a găsit, reformulează întrebarea și caută din nou — eticheta devine corectă. Nu este automat: produce un răspuns, nu o acțiune.
20. Un sistem de e-mail mută automat unele e-mailuri în folderul de spam.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5, flow, automat
Clasificatorul de spam este antrenat pe mesaje etichetate (machine learning5), pragurile și mutarea în folder sunt reguli scrise de om (algoritm1), executate într-o secvență fixă (flow), iar mesajul este mutat fără să fii întrebat (automat).
Nu compune nimic (nu generează conținut) și nu alege între strategii: după clasificare, urmează exact aceeași acțiune, de fiecare dată (nu este agent27). Este tiparul cel mai frecvent din produsele reale — un model care decide o etichetă, prins într-o rutare deterministă10.
21. Un program de joc alege mutările după o strategie învățată prin reinforcement learning — învățare din recompense: a jucat milioane de partide și a păstrat ce i-a adus puncte.
Verifică răspunsul
Etichete recomandate: machine learning5, agent27, automat
Strategia nu a fost scrisă de nimeni: a rezultat din milioane de partide și din recompensele primite (machine learning5). Programul urmărește un obiectiv și alege mutările în funcție de starea31 jocului (agent27), pe care le și execută singur (automat).
Nu apare eticheta algoritm1, iar comparația cu exemplul 13 este lecția acestui punct: motorul clasic de șah este agent27 cu reguli scrise de om, acesta este agent cu politică învățată. Aceeași etichetă de control, sursă complet diferită a comportamentului. Mutările sunt alese dintr-un set legal, deci nu generează conținut.
22. Un model de imagine creează un afiș dintr-o descriere.
Verifică răspunsul
Etichete recomandate: machine learning5, generează conținut
Imaginea este produsă de un model antrenat (machine learning5) și este conținut nou, construit pe loc din descriere (generează conținut).
O singură cerere, un singur rezultat: fără pași ficși (nu este flow), fără obiectiv urmărit prin acțiuni succesive (nu este agent27) și fără efect în afara fișierului livrat (nu este automat). Este exemplul 2 mutat în alt mediu — dovada că „generativ” descrie tipul ieșirii, nu gradul de autonomie29.
23. Un model clasifică facturile și le ordonează în liste de lucru stabilite dinainte.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5, flow, automat
Eticheta fiecărei facturi este dată de un model antrenat (machine learning5), regulile care traduc eticheta într-o destinație sunt scrise de om (algoritm1), listele de lucru există dinainte (flow), iar factura ajunge în listă fără intervenția cuiva (automat).
Nu generează conținut: o etichetă atribuită nu este text nou. Și nu este agent27, deși are un model în interior — nu există nicio alegere între strategii. Comparat cu exemplul 11, aici nimeni nu investighează nimic: se clasifică și se rutează.
24. Un asistent de cod sugerează linii, dar nu poate modifica fișiere.
Verifică răspunsul
Etichete recomandate: machine learning5, generează conținut
Sugestiile vin dintr-un model antrenat pe cod (machine learning5) și sunt cod nou, scris pe loc (generează conținut).
Nu poate modifica fișiere, deci nu acționează (nu este automat) și nu poate urmări un obiectiv prin pași succesivi (nu este agent27). Pune-l alături de exemplul 5: modelul poate fi același, dar acolo sistemul are voie să scrie, să ruleze și să reia. Eticheta se schimbă din cauza autorității acordate, nu din cauza capacității modelului.
25. Un robot ghidat vizual identifică un obiect și își ajustează prinderea.
Verifică răspunsul
Etichete recomandate: algoritm1, machine learning5, agent27, automat
Identificarea obiectului este făcută de un model de viziune24 antrenat (machine learning5), controlul brațului conține reguli și calcule scrise de ingineri (algoritm1), iar ajustarea prinderii în funcție de ce vede este exact bucla observă–decide–acționează (agent27), executată fără confirmare umană la fiecare mișcare (automat).
Nu produce conținut și nu urmează o listă de pași fixată dinainte: forma prinderii depinde de obiectul întâlnit, nu de o secvență stabilită de proiectant (nu este flow).
Cum interpretezi scorul
Scorul măsoară coerența față de definițiile folosite în această lecție, nu valoarea ta ca inginer. Dacă un răspuns diferă, citește explicația și verifică dacă ai confundat sursa comportamentului, modul de control sau autoritatea.
- 90–100%: clasificarea este foarte solidă; concentrează-te pe cazurile opționale.
- 70–89%: baza este bună, dar revizuiește diferențele model–agent27 și workflow26–autonomie29.
- sub 70%: reia secțiunile 3, 5 și 6 și încearcă activitatea din nou.
12. Exercițiu de proiectare: folosește sistemul cel mai simplu
În acest exercițiu nu căutăm tehnologia cea mai spectaculoasă, ci mecanismul minim care rezolvă corect fiecare etapă a unei probleme.
O companie vrea software care să proceseze bonuri și chitanțe de cheltuieli.
Cerințe posibile:
- Respinge fișierele mai mari de 20 MB.
- Extrage comerciantul, data, totalul și moneda.
- Verifică dacă totalul este egal cu suma pozițiilor.
- Cere clarificări când încrederea este redusă.
- Salvează înregistrarea aprobată.
- Notifică departamentul contabil.
O arhitectură slabă trimite totul unui singur LLM16 și îi cere „ocupă-te de chitanță”. O arhitectură mai bună atribuie fiecărei cerințe mecanismul potrivit:
| Cerință | Mecanism inițial recomandat | De ce |
|---|---|---|
| Limită de dimensiune | Regulă | Exactă și nenegociabilă |
| Extragere text | OCR23* ori model de viziune24* | Percepție din imagine brută |
| Extragere câmpuri | Ieșire structurată plus validare | Limbaj și structură vizuală ambiguă |
| Verificare aritmetică | Cod de calculator | Calcul exact |
| Clarificare la încredere scăzută | Workflow26 ori decizie de agent27 | Depinde de rezultatul observat |
| Salvare | Instrument30 de bază de date | Acțiune externă deterministă10 |
| Notificare contabilitate | Workflow26 cu regulă de permisiune | Verificabil și limitat |
Ce înseamnă OCR
OCR23* vine de la optical character recognition, în română recunoașterea optică a caracterelor. Este tehnologia care transformă imaginea unui text — fotografia unui bon, o pagină scanată, un PDF făcut din poze — în text propriu-zis, adică în caractere pe care software-ul le poate căuta, copia, corecta și aduna.
Diferența contează exact în exemplul de mai sus. Fără OCR23, chitanța fotografiată este pentru calculator o suprafață de pixeli, în care „TOTAL 148,50 lei” nu se deosebește cu nimic de un logo sau de o pată de cafea: nu există niciun număr de verificat, fiindcă nu există încă niciun număr. După OCR există un șir de caractere pe care o regulă îl poate valida și un program îl poate calcula. Un model de viziune24* merge un pas mai departe: pe lângă litere, interpretează și așezarea lor în pagină, deci poate spune care număr este totalul, care este TVA-ul și care este numărul de telefon al magazinului.
OCR23 nu este infailibil. Confundă cifre cu litere (0 cu O, 1 cu l), se împiedică de scrisul de mână, de umbre, de hârtia mototolită și de scanările la rezoluție mică. De aceea rezultatul lui este trimis mai departe către reguli și calcule care îl verifică, și nu este luat drept adevăr.
Sistemul poate deveni agentic27 ulterior, dacă trebuie să aleagă între mai multe strategii de recuperare. Nu are nevoie de autonomie29 largă pentru a fi util.
12.1 Patru exemple de domeniu
| Domeniu | Capabilitate potrivită pentru model | Limită deterministă | Autoritate inițială potrivită |
|---|---|---|---|
| Producție de film | Transcriere, descriere de cadre, căutare semantică | Checksum56*, reguli de stocare, metadata canonică57*, permisiuni de export | Consultativ și cu aprobare |
| Apă și canalizare | Explicarea anomaliilor și sinteza dovezilor | Validare senzori, topologie GIS60, simulare hidraulică, control SCADA61 | Consultativ, doar citire |
| Operațiuni de business | Extragere de documente și redactare | Calcule fiscale, validare de schemă, plăți, ștergere | Pregătește; omul aprobă impactul |
| Dezvoltare software | Explicare cod și propuneri de patch52 | Teste, sandbox37* de repository50*, branch51-uri* protejate, gate38-uri* de deploy53* | Autonomie29 limitată în sandbox37 |
13. Previzualizare de produse și tehnologii
Produsele de mai jos apar la niveluri diferite ale arhitecturii. Tabelul nu le recomandă încă; arată doar ce tip de problemă rezolvă fiecare categorie.
Pentru această lecție, citește tabelul doar pe primele două coloane: ce nevoie are un proiect și ce familie tehnologică răspunde acelei nevoi. Coloana a treia este trecută aici ca să știi că produsele există, nu ca să le reții acum și cu atât mai puțin ca să alegi ceva. Ne întoarcem la acest tabel după Lecția 4, când vom lega fiecare nevoie și de programele concrete care o rezolvă.
| Nevoie | Familie tehnologică | Exemple studiate ulterior |
|---|---|---|
| Logică deterministă10 și automatizare3 | Limbaje, shell40*, schedulere41*, motoare de workflow26* | Python, Bash, timere systemd |
| Machine learning5 clasic | Biblioteci43 ML5 | Scikit-learn, fastText |
| Deep learning7 | Framework-uri43* de antrenare13 | PyTorch, TensorFlow, JAX |
| Foundation models8 | Biblioteci43 și hub44-uri* | Transformers, Hugging Face Hub44, NeMo |
| Inferență14 locală | Runtime-uri45* și servere de model46* | Ollama, llama.cpp, llamafile, LM Studio |
| Orchestrare de agenți27 | Mașini de stare47* și framework-uri43 | LangGraph, Python propriu, Hermes, OpenClaw |
| Instrumente30 și integrări | API-uri48* și protocoale49* | REST, baze de date, MCP |
| Execuție sigură | Sandbox-uri37 și politici | OpenShell, containere, mașini virtuale |
| Retrieval și memorie | Sisteme de căutare și date | SQL, indexuri vectoriale, componente GraphRAG |
| Evaluare | Teste, seturi de date, traces54*, dashboard-uri55* | Teste unitare, evaluări de sarcini, observabilitate |
Nu selecta încă stack-ul58 final. Lecția 3 mapează stack-ul complet, iar Lecția 4 decodează numele produselor.
14. Notă de securitate și guvernanță
Orice creștere a autorității trebuie însoțită de limite, aprobări, jurnalizare și condiții clare de oprire. Inteligența modelului nu înlocuiește aceste mecanisme.
Cât de periculos este un sistem AI nu se măsoară după cât de „uman” sună, ci după ce poate atinge în realitate. Un model care vorbește impecabil, dar nu are acces la nimic, nu poate provoca pagube; un program banal, cu drepturi mari, poate. Riscul real îl stabilesc răspunsurile la aceste șapte întrebări:
- Ce date poate citi? Doar informații publice sau și contracte, dosare de personal, date medicale, baza de clienți?
- Ce credențiale33 deține? Credențialele sunt parolele, cheile de acces și token-urile date sistemului. Fiecare credențială primită este o ușă în plus pe care o poate deschide singur.
- Ce instrumente30 poate apela? Numai o căutare, sau și trimiterea unui e-mail, o plată, ștergerea unui fișier, pornirea unui utilaj?
- Acțiunile lui pot fi anulate? Un text scris greșit se rescrie în cinci minute; un transfer bancar executat sau un e-mail plecat către cinci mii de clienți, nu. Aceasta este reversibilitatea34: cât de ușor se dă înapoi ce s-a făcut.
- Cine aprobă acțiunile cu impact mare? Există un om care confirmă înainte de execuție, sau sistemul acționează singur și anunță după?
- Cum se observă că a greșit? Există verificări automate care prind eroarea în aceeași zi, sau se află abia când reclamă un client?
- Ce dovezi rămân în urmă? Logurile — jurnalele de execuție — sunt înregistrarea a ce a făcut sistemul, când, la cererea cui și cu ce rezultat. Fără ele, un incident nu poate fi nici explicat, nici demonstrat.
Un asistent25 care vorbește impecabil, dar nu are niciun instrument30 la dispoziție, este de regulă mai puțin periculos în practică decât un script de zece linii care rulează cu drepturi de administrator. Fluența impresionează oamenii; permisiunile schimbă lumea.
Pentru fiecare agent27 viitor, completează:
DATE:       Ce poate citi?
INSTRUMENTE: Ce poate apela?
AUTORITATE: Ce poate modifica?
LIMITĂ:     Unde este izolat?
APROBARE:   Ce acțiuni cer om?
OPRIRE:     Cum este oprit?
AUDIT:      Ce dovezi se păstrează?
15. Exerciții
Exercițiile te obligă să aplici harta asupra unor sisteme reale și asupra propriilor idei, nu doar să repeți definițiile.
Exercițiul A — Desenează schema noțiunilor
Ia o foaie și un creion și desenează o schemă care arată cum se leagă între ele noțiunile de mai jos: care intră una în alta, care se suprapun doar parțial și care nu se cuprind deloc, ci se folosesc una pe alta. Nu contează cât de frumos desenezi; contează ce spun formele și săgețile pe care le pui. Lucrează din memorie și abia la final verifică.
Folosește o notație simplă și ține-te de ea peste tot în desen:
- pătrat sau dreptunghi — o familie de tehnici, adică un fel de a produce comportamentul: AI, reguli, statistică4, machine learning5, deep learning7 și așa mai departe;
- cerc — o proprietate care se poate atașa oricărei tehnici, nu o tehnică în sine: automatizare3, autonomie29;
- formă în interiorul altei forme — incluziune completă: „tot ce este X este și Y”;
- forme care se suprapun parțial — doar o parte dintre elemente sunt comune;
- săgeată — o relație de folosire, nu de apartenență: „se sprijină pe”, „apelează”, „este construit peste”. Scrie pe fiecare săgeată, în două-trei cuvinte, ce relație reprezintă.
Construiește schema în patru pași:
- Incluziunile. Începe cu termenii care se cuprind unul pe altul și desenează-i ca forme concentrice. Pune în interiorul dreptunghiului de AI și acele familii care nu învață nimic din date — sunt și ele AI, chiar dacă nu sunt machine learning5.
- Suprapunerile. Există perechi care nu se cuprind, dar au parte comună: nu tot ce este generativ este un foundation model8 și nu tot ce este foundation model generează conținut; statistica4 și machine learning-ul5 împart metode, fără ca una să fie inclusă în cealaltă. Desenează-le ca forme care se intersectează și hașurează zona comună.
- Ce nu intră în niciun dreptunghi. Doi termeni din listă nu descriu o tehnică, ci o proprietate a sistemului: câtă intervenție umană mai există și cât are voie sistemul să facă singur. Desenează-i ca cercuri așezate deasupra schemei, nu în interiorul ei, și marchează cu o săgeată faptul că se pot atașa la orice formă de dedesubt — inclusiv la sisteme complet lipsite de AI.
- Relațiile de folosire. Leagă prin săgeți termenii care descriu sisteme — asistent25, workflow26, agent27 — de ceea ce folosesc ele: modele, instrumente30, pași stabiliți dinainte. Din desen trebuie să reiasă limpede ce are agentul în plus față de asistent și față de workflow.
Când ai terminat, schema ta trebuie să poată răspunde, fără niciun cuvânt în plus, la patru întrebări: unde se află granița dintre AI și machine learning5; de ce automatizarea3 nu este o felie din AI; ce anume adaugă agentul27 peste un asistent25; și care sunt perechile de termeni care se suprapun fără ca unul să îl conțină pe celălalt.
Abia acum întoarce-te la secțiunile 3.1, 4 și 17 și compară. Nu căuta desenul „identic cu al lecției” — două scheme corecte pot arăta diferit. Caută doar locurile în care ai desenat o incluziune acolo unde există de fapt o suprapunere, ori o apartenență acolo unde este doar o relație de folosire: acelea sunt exact paragrafele care merită recitite.
Cheia instructorului — o variantă corectă de schemă
Desenul de mai jos este o rezolvare posibilă, nu singura. Compară-l cu al tău la nivel de relații, nu de aspect: dacă ai desenat aceleași incluziuni, aceleași suprapuneri și aceleași săgeți, schema ta este corectă chiar dacă arată complet altfel.
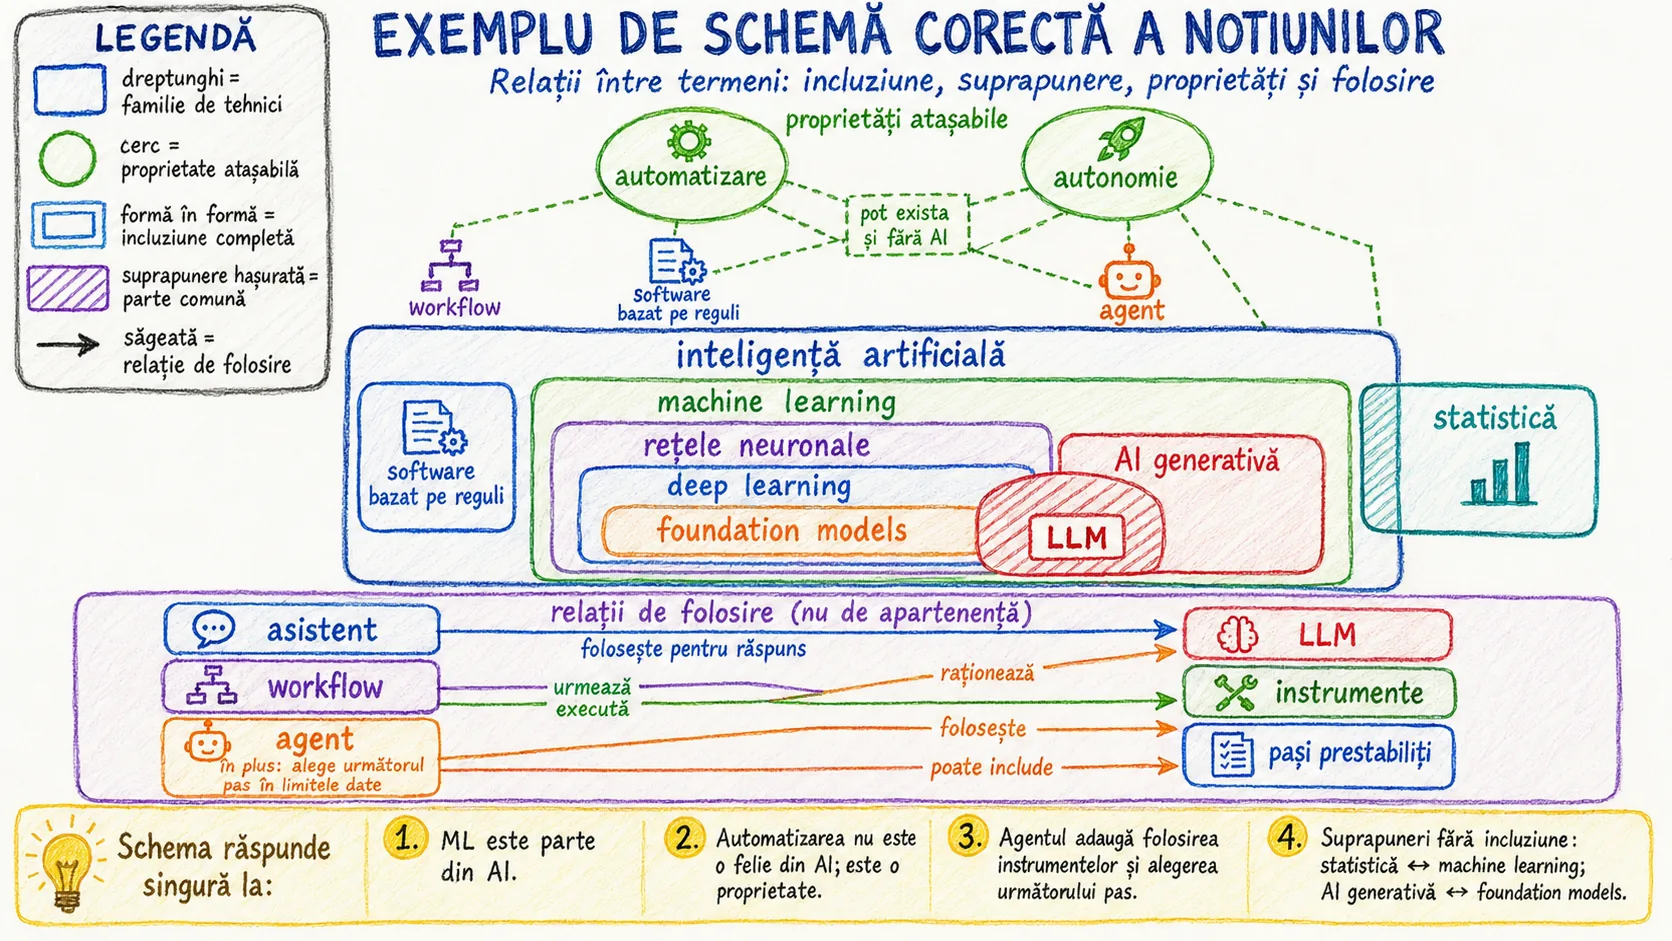
Ce trebuie să se regăsească în desen. Incluziunile se așază astfel: rețelele neuronale sunt o familie de machine learning5, deep learning7 este partea lor cu multe straturi, iar foundation models8 sunt modele de deep learning antrenate larg. Software-ul bazat pe reguli stă tot în interiorul AI, dar în afara machine learning-ului — este AI care nu învață nimic din date.
Suprapunerile. AI generativă9 și foundation models8 se intersectează fără ca una s-o conțină pe cealaltă: există foundation models care produc mai ales reprezentări, nu conținut, și există sisteme generative construite altfel. LLM-ul16 cade în zona comună. Statistica4 se suprapune cu machine learning5 prin metodele împărțite, dar are și o parte proprie, care nu ține de AI.
Cercurile de deasupra. Automatizarea3 și autonomia29 nu sunt tehnici, ci proprietăți: se leagă prin linii punctate de workflow26, de software-ul bazat pe reguli și de agent27 — inclusiv de sisteme fără nicio urmă de AI. Acesta este punctul în care greșesc cei mai mulți: le desenează înăuntrul dreptunghiului de AI.
Săgețile de folosire. Asistentul25 folosește un model pentru a formula răspunsul; workflow-ul26 urmează pași stabiliți dinainte; agentul27 raționează cu un model, folosește instrumente30 și poate include în el workflow-uri întregi — în plus față de amândouă, alege pasul următor în limitele primite. Dacă din desenul tău reiese această diferență, ai înțeles secțiunile 6.3–6.5.
Exercițiul B — Apără un caz-limită
Alege unul dintre cele patru sisteme de mai jos și scrie 150–250 de cuvinte despre motivul pentru care este sau nu agent27. Începe prin a declara definiția pe care o folosești, fiindcă de ea depinde răspunsul.
- Termostatul inteligent — citește temperatura și pornește sau oprește încălzirea după un prag.
- Motorul de șah — analizează mutările posibile și o alege pe cea mai bună pentru a câștiga partida.
- Asistentul25 cu RAG18 — asistentul care, înainte de a răspunde, caută fragmente în documentele firmei și le adaugă în context, apoi formulează răspunsul pe baza lor (retrieval-augmented generation, explicat în secțiunea 5.8). Reține că el nu ține minte nimic între două întrebări și nu execută nicio acțiune în afara răspunsului.
- Aspiratorul robotic — se deplasează singur prin cameră, ocolește obstacolele și se întoarce la stație când bateria scade.
Cheia instructorului
Termostatul: automatizare3, nu agent27. Motorul de șah: agent în sensul clasic. Asistentul25 cu RAG18: asistent, nu agent. Aspiratorul robotic: agent, cu autonomie29 limitată. Toate patru se decid din definiția declarată la început — de aceea exercițiul cere ca ea să vină prima.
Termostatul inteligent. Citește o valoare și o compară cu un prag: „dacă temperatura scade sub 19 °C, pornește încălzirea”. Regula a fost scrisă de om, sistemul nu învață nimic și nu alege pași — deci este automatizare3 bazată pe reguli, oricât ar spune numele comercial. Capcana: „inteligent” de pe cutie descrie marketingul, nu mecanismul. Pentru constructorul de agenți27, distincția arată unde se pun limitele: unui sistem fără obiectiv urmărit i se acordă și mai puține permisiuni.
Motorul de șah. Percepe tabla și selectează mutarea care duce spre câștig — bucla percepe → decide → acționează din definiția clasică. Poate fi complet determinist10 (minimax cu evaluare pozițională), fără nicio picătură de machine learning5, și tot agent27 este. Capcana: să-l negați fiindcă „nu învață”; sensul clasic cere percepție și alegere de acțiuni, nu învățare. Lecția practică: capabilitatea vine din mecanism, nu din tehnologie.
Asistentul25 cu RAG18. Căutarea în documente pare un instrument30, dar este apelată de un flux fix, înaintea fiecărui răspuns, nu aleasă de sistem; după răspuns nu păstrează nicio stare31 și nu execută nimic. Este un apel one-shot20 cu context mai bogat. Capcana: „are acces la datele firmei, deci e agent27” — accesul nu e buclă. Dacă vrei agent, trebuie adăugate explicit: stare între pași, alegere dinamică a pasului următor și o condiție de oprire.
Aspiratorul robotic. Percepe camera, ocolește obstacolele, revine la stație: buclă reală, cu stare31 și decizii luate pe loc, fără confirmare la fiecare mișcare — deci agent27, cu autonomie29 limitată la o resursă (podeaua) și o condiție de oprire (bateria). Capcana: niciun model generativ în el; autonomia nu are nicio legătură cu generativitatea. Exemplul arată forma minimală a unui agent util: senzori, reguli, o singură resursă acordată.
Exercițiul C — Renunță la AI acolo unde nu ajută
Alege un proces de muncă sau din viața zilnică. Împarte-l în pași și alocă fiecăruia una dintre opțiuni:
- regulă;
- algoritm1 software obișnuit;
- model statistic;
- model ML5;
- model generativ;
- workflow26;
- decizie de agent27;
- decizie umană.
Încearcă să reduci folosirea modelelor fără să reduci capabilitatea.
Cheia instructorului
Într-un proces rezolvat corect, cei mai mulți pași nu au nevoie de niciun model. Alocare exemplu pentru procesul „o factură primită pe e-mail devine plată aprobată”:
deschiderea și parsarea e-mailului — algoritm1 software (o bibliotecă43 de parsare); decizia „este factură?” — regulă pe expeditor și subiect, cu model ML5 doar când regula nu e suficientă; citirea textului din PDF-ul scanat — model ML (OCR23 sau model de viziune24); extragerea câmpurilor — model ML cu schemă de date39 la ieșire; verificarea totalului contra sumei pozițiilor — calcul, exact; cererea de clarificare la încredere scăzută — workflow26 cu ramificare; aprobarea plății — decizie umană; execuția plății — workflow cu permisiuni.
Capcana: să dai tot procesul unui singur model generativ, fiindcă pare mai rapid de construit. Fiecare pas mutat la un model aduce eroare probabilistică11 acolo unde exista un răspuns exact — suma facturilor se calculează, nu se ghicește. Pentru constructorul de agenți27, exercițiul e antrenamentul de bază al proiectării: mecanismul minim pe fiecare pas este și cel mai ușor de testat, de auditat și de înlocuit.
Exercițiul D — Scara autonomiei
Proiectează cinci versiuni ale unui agent27 de e-mail, de la consultativ la autonomie29 largă. Pentru fiecare nivel, notează riscul nou introdus de autoritatea suplimentară.
Cheia instructorului
Scara se urcă acordând la fiecare nivel o autoritate mai mare numai după ce riscul nivelului precedent este acoperit de un test. O variantă corectă, de jos în sus:
1. Consultativ — agentul27 propune mesajul, omul îl trimite. Risc nou: greșeli de conținut; se acoperă prin revizuirea de către un om. 2. Execută cu aprobare la fiecare acțiune — trimite doar după un clic de confirmare. Risc nou: aprobarea devine formalitate bifată mecanic, iar omul nu mai citește ce aprobă. 3. Execută singur acțiunile reversibile — drafturi, foldere locale — și cere aprobare pentru ireversibile: trimitere, ștergere. Risc nou: clasificarea greșită a reversibilității; un e-mail către o adresă greșită pare reversibil și nu este. 4. Autonom în limite declarate — plafon de destinatari, de volum, de oră, cu oprire automată la anomalii. Risc nou: efectele combinate ale multor acțiuni mici, fiecare în limite, împreună în afara lor. 5. Autonomie29 largă — acționează singur pe domeniul lui, cu audit36 complet. Risc nou: erorile în lanț și o decizie greșită multiplicate.
Capcana: să proiectezi direct nivelul 5 „ca să fie gata”. Pentru constructorul de agenți27, scara este un plan de testare: fiecare nivel nou se câștigă cu dovezi, nu cu intenții.
Exercițiul E — Începe profilul agentului tău
Răspunde într-un paragraf:
- Pentru cine este agentul27?
- Ce rezultat trebuie să îmbunătățească?
- Ce informații poate folosi?
- Ce acțiuni ar putea executa în viitor?
- Ce acțiuni trebuie întotdeauna aprobate?
Păstrează răspunsurile: în laborator le vei scrie într-un fișier numit docs/agent-profile.md, în folderul proiectului pe care îl creezi la secțiunea 3. Este o fișă scurtă, în format text, cu utilizatorul vizat, rezultatul urmărit, sursele pe care agentul27 le-ar putea citi, acțiunile pe care le-ar putea pregăti și acțiunile care cer obligatoriu aprobarea unui om.
Fișierul acesta nu rămâne un exercițiu de lecție: el este primul document al proiectului pe care îl construim din lecție în lecție, salvat în Git încă din prima zi. Îl vei deschide și completa din nou pe măsură ce agentul27 capătă instrumente30, memorie și autoritate — iar când vei ajunge să-i dai voie să acționeze singur, tot din el vei citi ce ai declarat, la început, că trebuie aprobat de om.
Cheia instructorului
Profilul trebuie să spună cine folosește agentul27, ce rezultat urmărește, ce are voie să citească, ce are voie să pregătească și ce rămâne întotdeauna la om. Un paragraf model: „Agentul este pentru contabilii firmei; rezultatul pe care îl îmbunătățește este timpul până la o plată verificată. Poate citi facturile din folderul primit/ și registrul furnizorilor; nu are acces la contracte și la date de salarii. Poate pregăti fișa de plată completată și un draft de e-mail către furnizor; nu trimite nimic. Plățile peste 5 000 lei și orice adresă nouă de destinatar cer întotdeauna aprobarea unui om.”
Capcana: să răspunzi cu capabilități („poate citi PDF-uri”) în loc de limite. Un profil util enumeră la fel de concret ce nu poate agentul27; exact de acolo vor porni permisiunile, testele și, mai târziu, scara autonomiei29 din exercițiul D.
Exercițiul F — Găsește greșeala: MightyAgent™
O pagină fictivă de produs afirmă:
MightyAgent™ este un agent27 de raționament complet autonom. Utilizatorul trimite un paragraf, LLM-ul16 îl rezumă, iar rezumatul apare pe ecran. Fiindcă modelul este generativ, sistemul este autonom. Învață din fiecare cerere, planifică cea mai bună succesiune de instrumente30 și garantează răspunsuri factuale. Nu sunt necesare aprobări sau limite de securitate, fiindcă nu are corp robotic.
Identifică minimum șase afirmații incorecte sau nesusținute. Pentru fiecare dintre ele precizează:
- termenul folosit greșit;
- dovezile necesare pentru justificare;
- cum ar trebui numit sistemul descris de fapt.
Cheia instructorului
Luăm textul propoziție cu propoziție. Fiecare afirmație este comparată cu ce descrie de fapt pagina de produs, nu cu ce sugerează numele lui.
1. „MightyAgent™ este un agent27 de raționament complet autonom.” — două probleme într-o singură frază. În contextul unei aplicații LLM16 moderne, afirmația agent ar cere dovezi despre urmărirea unei sarcini pe mai mulți pași, observarea rezultatelor și alegerea dinamică a pașilor următori; nimic din toate acestea nu apare mai jos în descriere. Complet autonom este o afirmație despre autoritate: ar trebui să spună ce are voie sistemul să facă singur, asupra căror date și resurse. Un sistem care doar afișează text pe ecran nu are nicio autoritate externă — deci nu poate fi „complet autonom” în sens operațional. Dovezi necesare: descrierea buclei, lista instrumentelor30 și lista permisiunilor.
2. „Utilizatorul trimite un paragraf, LLM-ul16 îl rezumă, iar rezumatul apare pe ecran.” — aceasta este singura propoziție corectă din tot textul și, culmea, ea îl contrazice pe restul. Descrie exact o transformare intrare–ieșire, adică un apel one-shot20: o cerere, un răspuns, fără pas următor. Este definiția unui asistent25 generativ, nu a unui agent27.
3. „Fiindcă modelul este generativ, sistemul este autonom.” — raționamentul este greșit din construcție, fiindcă leagă două axe independente. Generativ descrie ce produce sistemul (text nou, în loc de un scor sau o etichetă). Autonom descrie ce are voie să facă fără aprobare. Un model generativ fără instrumente30 nu poate face nimic în lume, iar un script de trei linii fără nicio urmă de AI poate șterge fișiere singur. Din prima proprietate nu rezultă niciodată a doua.
4. „Învață din fiecare cerere.” — confundă inferența14 cu antrenarea13. La fiecare cerere, modelul este aplicat, nu modificat: parametrii12 lui rămân exact aceiași. Ce se poate întâmpla realmente este ca aplicația să păstreze istoricul conversației și să îl trimită din nou modelului — asta înseamnă mai mult context, nu învățare. O învățare adevărată ar cere date colectate, o rulare de antrenare, versiuni de model și evaluări înainte și după. Dovezi necesare: exact acestea.
5. „Planifică cea mai bună succesiune de instrumente30.” — afirmă două lucruri pe care descrierea nu le susține. Întâi, nu este menționat niciun instrument: nu există căutare, bază de date, calculator sau API48 pe care sistemul să le poată apela. Fără instrumente nu există nici ce să planifici. Apoi, „cea mai bună” este o afirmație de optimalitate, care s-ar putea demonstra doar cu un criteriu declarat și cu măsurători comparative.
6. „Garantează răspunsuri factuale.” — este afirmația cea mai periculoasă din text, fiindcă un model generativ alege continuări probabile, nu adevărate. Plauzibil și adevărat sunt lucruri diferite, iar un model poate formula convingător o informație complet greșită. Corectitudinea nu vine niciodată din model, ci din ce se pune în jurul lui: surse verificabile, citări, validări, calcule făcute de cod și, unde contează, un om care confirmă. „Garantează” nu poate fi susținut nici măcar atunci; se poate raporta cel mult o rată de eroare măsurată pe un set de teste.
7. „Nu sunt necesare aprobări sau limite de securitate, fiindcă nu are corp robotic.” — confundă riscul fizic cu riscul digital. Un sistem fără corp citește date, primește credențiale33, trimite mesaje, poate publica sau șterge. Paguba nu are nevoie de brațe mecanice: scurgerea unui dosar de personal sau ștergerea unei baze de date se fac exclusiv prin software. Limitele se stabilesc după ce poate atinge sistemul, nu după cum arată.
Cum ar trebui numit, de fapt. „Asistent25 de rezumare bazat pe un model de limbaj, fără instrumente30 și fără autoritate de acțiune” — sau, dacă textul trece prin mai mulți pași ficși, „pipeline de transformare a textului”. Nici agent27, nici autonom. Exercițiul este util tocmai pentru că descrierea nu este o caricatură: exact așa arată majoritatea paginilor de produs pe care le vei citi.
16. Quiz cu răspunsuri explicate
Răspunde mai întâi în minte sau în scris. Apoi deschide răspunsul imediat sub întrebare și compară nu doar concluzia, ci și criteriul folosit.
1Este automatizarea3 o subcategorie a inteligenței artificiale? Explică.
Deschide răspunsul
Nu. Automatizarea3 descrie faptul că un proces este executat cu intervenție umană redusă. Ea nu spune ce tehnică produce decizia.
Un sistem automat poate folosi reguli scrise de programatori, un model de machine learning5, o combinație între cele două sau un mecanism simplu precum un temporizator. De aceea automatizarea3 și inteligența artificială sunt proprietăți diferite: una descrie cine execută procesul, iar cealaltă descrie ce metode de calcul sunt folosite.
2Care este diferența dintre antrenare13 și inferență14?
Deschide răspunsul
Antrenarea13 este etapa în care un model își ajustează parametrii12 folosind date și o metodă de optimizare. Un parametru este o valoare numerică internă care influențează rezultatele modelului.
Inferența14 este etapa de utilizare: modelul deja antrenat primește o intrare nouă și produce o predicție, o clasificare, un text sau alt rezultat. Pe scurt, în antrenare13 modelul este modificat; în inferență modelul este aplicat.
3Poate exista un agent27 fără machine learning5? Dă un exemplu.
Deschide răspunsul
Da. Un agent27 este definit prin felul în care urmărește un obiectiv și alege acțiuni, nu prin obligația de a folosi machine learning5.
Un motor clasic de șah poate analiza mutări cu algoritmi1 de căutare și reguli scrise de oameni, apoi poate alege mutarea care îi maximizează șansele de câștig. El poate funcționa ca agent27 în mediul jocului chiar dacă nu a învățat un model din date.
4De ce un rezumat LLM16 one-shot20 nu este, de regulă, agent27?
Deschide răspunsul
Un rezumat one-shot20 înseamnă o singură cerere urmată de un singur răspuns. Un LLM16 — model lingvistic de mari dimensiuni — primește textul și generează rezumatul, dar nu urmărește neapărat un obiectiv prin mai mulți pași.
Pentru a vorbi despre un agent27, ne așteptăm de regulă la o buclă: sistemul observă starea31, alege o acțiune, folosește eventual instrumente30, verifică rezultatul și decide dacă trebuie să continue sau să se oprească. O transformare unică intrare–ieșire nu demonstrează această buclă.
5Ce deosebește un workflow26 de un agent27?
Deschide răspunsul
Un workflow26, adică un flux de lucru, urmează pași sau ramuri51 stabilite dinainte de proiectant. Poate conține condiții și reluări, dar traseele posibile sunt descrise explicit.
Un agent27 selectează dinamic cel puțin o parte dintre acțiuni pe baza obiectivului, a stării31 curente și a rezultatelor observate. Diferența nu este că workflow-ul26 ar fi simplu și agentul complex, ci că mecanismul de alegere a pasului următor este diferit.
6AI generativă9 garantează rezultate factuale?
Deschide răspunsul
Nu. Modelele generative produc rezultate folosind probabilități: aleg continuări sau structuri plauzibile pe baza tiparelor învățate. „Plauzibil” nu înseamnă automat „adevărat”.
Un rezultat factual trebuie verificat prin surse, baze de date, calcule sau alte mecanisme potrivite domeniului. Un model poate formula convingător o afirmație greșită, poate confunda date ori poate completa goluri cu informații nesusținute.
7Ce descrie autonomia29?
Deschide răspunsul
Autonomia29 descrie autoritatea de a acționa fără aprobarea imediată a unui om. Ea nu măsoară cât de inteligent este sistemul.
Autonomia29 trebuie precizată împreună cu limitele sale: asupra căror fișiere, conturi, dispozitive sau procese poate acționa, pentru cât timp, cu ce buget și în ce condiții se oprește. Un script simplu poate avea autonomie restrânsă, iar un model foarte capabil poate rămâne doar consultativ.
8Dă un exemplu unde regulile sunt preferabile unui LLM16.
Deschide răspunsul
Regulile sunt preferabile atunci când rezultatul trebuie să respecte exact o condiție verificabilă. Exemple: calculul unei taxe, verificarea unei limite de dimensiune, controlul permisiunilor sau validarea unei scheme de date39.
O schemă de date39 descrie câmpurile, tipurile și structura obligatorie a datelor. Dacă o factură trebuie să conțină un câmp numeric într-un format precis, o regulă deterministă10 poate verifica cerința exact; un LLM16 nu trebuie folosit ca înlocuitor pentru această verificare.
9Care sunt cele trei axe ale lecției?
Deschide răspunsul
Cele trei axe sunt: sursa comportamentului, tiparul de control și autoritatea.
Prima întreabă dacă sistemul folosește reguli, statistică4, modele învățate sau o combinație. A doua urmărește cum este ales pasul următor: răspuns unic, workflow26, ramificare sau buclă adaptivă28. A treia stabilește ce are voie sistemul să facă fără aprobarea imediată a unui om.
10De ce aritmetica exactă trebuie delegată unui calculator?
Deschide răspunsul
Un calculator aritmetic este determinist10: pentru aceleași numere și aceeași operație produce același rezultat, care poate fi verificat direct.
Un model lingvistic generează limbaj pe baza probabilităților și nu este construit ca motor aritmetic exact. Un agent27 bine proiectat poate înțelege cererea printr-un model, dar deleagă operația numerică unui instrument30 de calcul și verifică apoi rezultatul.
11Ce înseamnă „inteligență probabilistică11 în limite deterministe10”?
Deschide răspunsul
Înseamnă să folosim modelele probabilistice11 acolo unde sunt utile — de exemplu pentru limbaj ambiguu, clasificare flexibilă sau interpretarea unor documente — dar să limităm efectele lor prin componente verificabile.
Aceste limite pot fi cod determinist10, permisiuni restrânse, scheme de date39, validări, bugete, reguli de oprire și aprobări umane32. Modelul poate propune sau interpreta; sistemul din jur decide ce este permis, verifică formatul și împiedică acțiunile periculoase.
17. Recapitulare: harta într-o singură pagină
Harta
Control și autoritate
Testul celor trei axe
Testul agentului software modern
Obiectiv + observații + stare31 + alegeri dinamice între acțiuni + feedback + buclă repetată + oprire sau solicitarea intervenției unui om. Instrumentele30 apar când sarcina cere acces la informații ori acțiuni externe.
Regula inginerească: folosește mecanismul cel mai simplu și mai fiabil pentru fiecare pas. Combină modele, reguli, instrumente30, workflow-uri26 și oameni, în loc să forțezi un singur model să facă totul.
Vocabular esențial
Recitește definițiile după parcurgerea lecției — acum fiecare termen are context. Sunt grupate în patru familii: cum ia sistemul deciziile, cum se construiesc și se folosesc modelele, cum se controlează comportamentul lor și ce infrastructură apare în jurul lor. Termenii explicați pe parcursul lecției, sub tabele, apar și aici, cu detalii în plus. Apasă pe numărul de lângă un termen ca să ajungi la explicația lui; butonul Înapoi al browserului te duce înapoi unde citeai.
Cum ia sistemul deciziile
| Termen | Ce înseamnă |
|---|---|
| 1 Algoritm | O procedură finită și explicită: o listă de pași care transformă o intrare într-o ieșire și care se termină. Rețeta unei prăjituri și instrucțiunile de sortare a unui teanc de facturi sunt algoritmi, chiar dacă niciunul nu are legătură cu AI. Cuvântul nu spune nimic despre inteligență: spune doar că pașii sunt stabiliți și pot fi urmați identic de fiecare dată. |
| 2 Software bazat pe reguli | Program ale cărui condiții și acțiuni au fost scrise direct de oameni, sub forma „dacă se întâmplă X, fă Y”. Nu învață nimic din date: comportamentul lui se schimbă doar când cineva rescrie regulile. Rămâne alegerea corectă acolo unde răspunsul trebuie să fie exact și identic de fiecare dată — calcule de taxe, limite, permisiuni, validări. |
| 3 Automatizare | Executarea unui proces cu intervenție umană redusă. Descrie cine face treaba, nu cât de inteligentă este metoda: un temporizator de irigație este automat fără urmă de AI, iar un model foarte capabil care doar propune un răspuns nu este automat deloc. Automatizarea și AI sunt axe diferite, care se pot combina în orice fel. |
| 4 Statistică | Ansamblul metodelor prin care descriem date, măsurăm relații între ele și punem cifre pe incertitudine. Este fundația matematică pe care s-a construit machine learning, dar nu se confundă cu el: o medie, o corelație sau un interval de încredere sunt statistică fără să existe vreun model antrenat. |
| 5 Machine learning — ML | Familie de metode care extrag tipare din date sau din experiență, în loc să primească fiecare regulă scrisă de om. Programatorul stabilește forma modelului și modul de învățare; conținutul regulilor rezultă din exemple. De aceea un model ML poate recunoaște lucruri pe care nimeni nu le-a descris explicit — și de aceea greșește în feluri pe care nimeni nu le-a prevăzut explicit. |
| 6 Rețea neuronală | Model matematic construit din straturi de operații simple, conectate între ele, ale căror ponderi se ajustează în timpul antrenării. Numele vine dintr-o analogie îndepărtată cu neuronii; nu este o simulare a creierului. Este doar una dintre familiile de modele ML — nu toate modelele sunt rețele neuronale. |
| 7 Deep learning | Machine learning cu rețele neuronale care au multe straturi de transformare, adică „adânci”. Fiecare strat învață o reprezentare mai abstractă decât cel dinainte, ceea ce permite lucrul direct cu date brute — imagini, sunet, text — fără ca un om să descrie manual trăsăturile importante. În schimb, cere mult mai multe date și mult mai mult calcul. |
| 8 Foundation model | Model antrenat pe date foarte variate, gândit să fie reutilizat pentru multe sarcini diferite, în loc să fie construit pentru una singură. Rolul lui este de bază comună: aceeași bază este adaptată prin instrucțiuni, exemple, retrieval sau ajustare fină. Nu toate sunt generative — unele produc în principal reprezentări interne, folosite la căutare și comparație. |
| 9 Inteligență artificială generativă | Modele care produc conținut nou: text, imagini, sunet, cod sau structuri de date. Rezultatul este construit pe loc, pe baza tiparelor învățate, nu ales dintr-o listă existentă. „Nou” nu înseamnă „adevărat”: plauzibilitatea este criteriul după care generează, iar verificarea trebuie făcută în afara modelului. |
| 10 Determinist | Proces care, pentru aceleași intrări și aceleași condiții, dă exact același rezultat de fiecare dată. Un calcul aritmetic, o verificare de dimensiune sau o regulă de permisiune sunt deterministe, deci pot fi testate o dată și pot fi presupuse stabile după aceea. Este proprietatea pe care se sprijină toate limitele de siguranță din lecție. |
| 11 Probabilistic | Proces care lucrează cu probabilități și poate produce rezultate diferite, ori scoruri de încredere, pentru aceeași situație. Este util exact acolo unde realitatea este ambiguă — limbaj, imagini, clasificări cu granițe neclare. Devine periculos când i se cere ceva ce trebuie să iasă exact la fel de fiecare dată. |
Modele: antrenare, folosire și adaptare
| Termen | Ce înseamnă |
|---|---|
| 12 Parametru al modelului | Valoare numerică internă, ajustată în timpul antrenării, care influențează felul în care modelul transformă intrarea în rezultat. Modelele mari au miliarde de astfel de valori; ele nu sunt reguli pe care le poate citi un om și nu pot fi editate individual cu sens. Când auzi „model de 7B”, cifra se referă la parametri: șapte miliarde. |
| 13 Antrenare — training | Etapa în care parametrii modelului sunt modificați, folosind date și o metodă de optimizare, până când rezultatele se apropie de cele așteptate. Este scumpă, lentă și se face rar. La finalul ei rezultă un artefact fix: modelul antrenat. |
| 14 Inferență | Etapa de folosire: modelul deja antrenat primește o intrare nouă și produce un rezultat, fără să se modifice pe sine. Tot ce faci zilnic cu un asistent este inferență. De aici vine o confuzie frecventă — un sistem care „pare că învață din conversație” de obicei doar primește mai mult context, nu își schimbă parametrii. |
| 15 Prompt | Textul, instrucțiunea sau combinația de date trimisă modelului pentru a-i cere un rezultat. Este cea mai ieftină formă de adaptare a unui foundation model și, de multe ori, prima care merită încercată. Nu adaugă modelului cunoștințe pe care nu le are: doar orientează ce știe deja. |
| 16 LLM — large language model | Model lingvistic de mari dimensiuni, antrenat pe cantități uriașe de text pentru a procesa și genera limbaj. Este o componentă, nu un sistem: un LLM singur nu are obiectiv, nu are instrumente, nu ține minte între cereri și nu decide nimic despre lumea din afara textului. |
| 17 Exemple în context — few-shot | Câteva exemple de intrare și ieșire corectă puse chiar în prompt, ca modelul să deducă formatul și stilul cerut. Funcționează ca o demonstrație scurtă, nu ca o învățare: exemplele dispar odată cu cererea și nu rămân în model. |
| 18 RAG — retrieval-augmented generation | Tehnică prin care, înainte de a răspunde, sistemul caută fragmente relevante în surse externe — documentele firmei, o bază de date, un set de fișiere — și le adaugă în context. Aduce informație proaspătă sau privată fără reantrenare și permite citarea sursei. Nu garantează corectitudinea: dacă fragmentul găsit este greșit sau nepotrivit, răspunsul construit pe el va fi la fel. |
| 19 Ajustare fină — fine-tuning și PEFT | Modificarea unui model deja antrenat pe date specifice, ca să se comporte mai bine pe un domeniu sau într-un anumit stil. Varianta completă schimbă toți parametrii și este costisitoare; variantele economice (PEFT) antrenează doar un set mic de parametri adăugați. Se justifică abia după ce ai măsurat o limitare pe care instrucțiunile, exemplele și retrieval-ul nu o rezolvă. |
| 20 One-shot | O singură cerere urmată de un singur răspuns, fără buclă în care sistemul să observe rezultatul și să decidă pasul următor. Este forma tipică a unui asistent care rezumă un text sau răspunde la o întrebare — și este exact motivul pentru care un astfel de sistem nu este agent. |
| 21 Embedding — reprezentare vectorială | Listă de numere care codifică proprietățile unui text, ale unei imagini sau ale altui obiect, astfel încât lucrurile cu sens apropiat să primească liste apropiate matematic. Permite căutarea după înțeles, nu doar după cuvinte identice. Revine pe larg într-o lecție viitoare, împreună cu indexurile vectoriale. |
| 22 Vector | Listă ordonată de numere. În AI, vectorii sunt forma standard în care datele ajung să fie comparate și prelucrate matematic, fiindcă distanța dintre doi vectori poate fi calculată. |
| 23 OCR — optical character recognition | Recunoașterea optică a caracterelor: transformarea imaginii unui text — scan, fotografie, PDF din poze — în caractere pe care software-ul le poate căuta, copia și calcula. Fără acest pas, un bon fotografiat este pentru calculator doar o suprafață de pixeli. Greșește previzibil la scris de mână, rezoluție mică și caractere asemănătoare (0/O, 1/l), de aceea rezultatul lui se verifică mai departe. |
| 24 Model de viziune | Model care interpretează imagini, nu doar literele din ele: recunoaște obiecte, structura paginii și relațiile dintre elemente. Pe o factură, diferența față de OCR simplu este că poate spune care număr este totalul și care este TVA-ul, fiindcă înțelege și așezarea în pagină. |
Control, autoritate și siguranță
| Termen | Ce înseamnă |
|---|---|
| 25 Asistent | Sistem orientat spre utilizator, care răspunde, redactează, caută sau organizează la cerere. Omul rămâne cel care decide și acționează; asistentul livrează un rezultat, nu o consecință. Poate fi extrem de capabil și totuși să nu aibă nimic dintr-un agent. |
| 26 Workflow — flux de lucru | Secvență sau graf de pași, condiții și reluări, stabilite dinainte de un om. Poate avea ramificații și reîncercări, dar toate traseele posibile există în proiectare. Este forma potrivită când procesul este cunoscut și trebuie repetat identic și auditabil. |
| 27 Agent | Termen cu două sensuri utile. În sensul clasic, larg, este un sistem care percepe un mediu și selectează acțiuni în raport cu un obiectiv sau cu o politică; poate fi complet determinist și poate să nu folosească machine learning. În sensul operațional modern folosit frecvent pentru aplicații software și LLM, urmărește o sarcină pe mai mulți pași, păstrează stare ori feedback despre progres și alege dinamic cel puțin o parte dintre acțiunile următoare până la oprire. Criteriul nu este numele modelului, ci mecanismul de control și definiția declarată. |
| 28 Buclă adaptivă | Ciclul observă → decide → acționează → evaluează, repetat până la atingerea obiectivului sau până la o condiție de oprire. Este exact elementul care lipsește unui apel one-shot și care transformă o funcție într-un agent. |
| 29 Autonomie | Autoritatea de a decide și de a acționa fără aprobarea imediată a unui om. Descrie permisiuni, nu inteligență: un script banal poate fi autonom, iar un model foarte capabil poate rămâne strict consultativ. Se declară întotdeauna împreună cu limitele ei — asupra căror resurse, pentru cât timp, cu ce buget, până la ce condiție de oprire. |
| 30 Instrument — tool | Capacitate pe care sistemul o poate apela: o căutare, o interogare de bază de date, un calculator, un API, o comandă. Instrumentele sunt locul unde un sistem AI atinge lumea reală, deci și locul unde se pun cele mai importante limite. |
| 31 Stare — state | Informația păstrată despre sarcina curentă: unde s-a ajuns, ce s-a încercat deja, ce a rezultat. Fără stare, un sistem nu poate relua, nu poate corecta și nu poate ști dacă a terminat. |
| 32 Aprobare umană | Punctul în care un om confirmă explicit o acțiune înainte ca sistemul să o execute. Se aplică selectiv, la acțiunile cu impact mare sau ireversibile — plăți, ștergeri, trimiteri către clienți — nu la tot, altfel devine o formalitate bifată mecanic. |
| 33 Credențiale | Parolele, cheile de acces și token-urile prin care un program dovedește că are dreptul să folosească un serviciu. Fiecare credențială dată unui agent este o ușă în plus pe care o poate deschide singur, de aceea se acordă strict cât este necesar și pe durată limitată. |
| 34 Reversibilitate | Cât de ușor poate fi anulat efectul unei acțiuni. Un text scris greșit se rescrie; un transfer executat sau un e-mail trimis către mii de destinatari, nu. Este criteriul principal după care se decide ce are voie un sistem să facă singur. |
| 35 Log — jurnal de execuție | Înregistrarea a ceea ce a făcut sistemul: ce a primit, ce a apelat, ce a răspuns, când și la cererea cui. Fără jurnale, un incident nu poate fi nici explicat, nici demonstrat, iar o îmbunătățire nu poate fi verificată. |
| 36 Audit | Verificarea ulterioară, pe baza dovezilor păstrate, a felului în care s-a comportat sistemul. Presupune că jurnalele există, sunt complete și nu pot fi modificate discret — altfel nu este audit, ci reconstituire din memorie. |
| 37 Sandbox | Spațiu de execuție izolat în care un program poate rula și greși fără să atingă sistemul real: are acces doar la ce i s-a dat explicit. „Autonomie limitată în sandbox” înseamnă libertate completă înăuntru și niciun efect în afară. |
| 38 Gate — poartă de control | Condiție obligatorie prin care o modificare trebuie să treacă înainte de a merge mai departe: testele trec, un om a aprobat, verificarea de securitate a fost făcută. Dacă nu este îndeplinită, procesul se oprește acolo. |
| 39 Schemă de date | Descrierea obligatorie a câmpurilor, tipurilor și structurii pe care trebuie să le aibă datele. Este mecanismul determinist prin care ieșirea unui model devine verificabilă: fie corespunde formei cerute, fie este respinsă înainte să ajungă mai departe. |
Infrastructura și instrumentele de lucru
| Termen | Ce înseamnă |
|---|---|
| 40 Shell | Programul care interpretează comenzile scrise în terminal; pe Ubuntu este de obicei Bash. Prin el ceri sistemului să copieze fișiere, să pornească programe și să le înlănțuie. Terminalul este fereastra; shell-ul este cel care înțelege ce ai scris în ea. |
| 41 Scheduler — planificator | Componenta care pornește singură o sarcină la un moment stabilit sau la un interval fix: „în fiecare noapte la ora 3”, „la fiecare zece minute”. Timerele systemd și cron sunt schedulere. Este cea mai simplă formă de automatizare și, de multe ori, suficientă. |
| 42 Motor de workflow | Programul care ține minte pașii unui flux, îi execută în ordine, reia ce a eșuat și înregistrează unde s-a ajuns. Fluxul îl descrii tu; motorul îl duce la capăt și îți poate spune exact la ce pas a rămas. |
| 43 Bibliotecă și framework | O bibliotecă este cod reutilizabil pe care programul tău îl apelează când are nevoie. Un framework este o bibliotecă mare care impune și structura aplicației: el rulează și îți lasă locuri de completat. Ca să ții minte: biblioteca o chemi tu, framework-ul te cheamă el. |
| 44 Hub | Depozit public online de unde descarci modele gata antrenate sau seturi de date, cu versiuni, licențe și descrieri — Hugging Face Hub este exemplul obișnuit. Pentru modele, un hub joacă rolul pe care îl joacă un magazin de aplicații pentru telefoane. |
| 45 Runtime | Programul care execută efectiv un model sau un cod pe calculatorul tău: îl încarcă în memorie, îl rulează pe procesor sau pe placa video și întoarce rezultatul. Ollama și llama.cpp sunt runtime-uri pentru modele; Python 3 este runtime-ul fișierelor .py din laborator. |
| 46 Server de model | Un runtime care stă pornit și răspunde la cereri venite prin rețea, astfel încât mai multe programe sau persoane să îl folosească simultan. Diferența față de un runtime simplu nu este ce calculează, ci că nu se oprește după o singură rulare. |
| 47 Mașină de stare | Mod de a descrie un sistem prin stările în care se poate afla și prin tranzițiile permise între ele. La agenți este util fiindcă face explicit ce poate urma după fiecare pas și, mai ales, ce nu are voie să urmeze. |
| 48 API | Application programming interface: interfața prin care un program cere date sau acțiuni altui program, într-un format stabilit dinainte. Butoanele și ecranele sunt pentru oameni; API-ul este echivalentul lor pentru programe. |
| 49 Protocol | Setul de reguli convenite prin care două programe se înțeleg: ce mesaje își trimit, în ce format și în ce ordine. HTTP este protocolul web-ului; MCP este un protocol prin care un model poate folosi instrumente externe. |
| 50 Repository — repo | Folderul unui proiect software împreună cu tot istoricul modificărilor: cine a schimbat, ce a schimbat, când și de ce. Git îl gestionează local; GitHub sau GitLab sunt servicii unde poate fi găzduit, dar nu sunt același lucru cu Git. |
| 51 Branch — ramură | Linie de lucru paralelă în interiorul aceluiași repository: modifici acolo, iar varianta principală rămâne neatinsă până când cineva acceptă schimbarea. Un branch protejat este o ramură pe care nimeni — om sau agent — nu poate scrie direct, fără verificare. |
| 52 Patch | Un set concret de modificări propuse asupra codului, exprimat ca diferență față de varianta existentă: aceste linii se scot, acestea se adaugă. Un model poate propune un patch; testele și oamenii decid dacă intră. |
| 53 Deploy — punere în producție | Momentul în care codul ajunge pe serverele folosite de utilizatori reali. Până la deploy, o greșeală rămâne locală; după deploy, o văd clienții — de aceea porțile de control se pun exact înaintea acestui pas. |
| 54 Traces — urme de execuție | Înregistrarea pas cu pas a unei rulări: ce a primit sistemul, ce instrument a apelat, ce a răspuns, cât a durat și cât a costat. Fără ele nu poți afla de ce un agent a greșit; cu ele, poți reconstitui traseul exact. |
| 55 Dashboard — tablou de bord | Pagina care adună măsurătorile în grafice și cifre, ca să vezi dintr-o privire câte rulări au eșuat, cât costă și unde se pierde timpul. Este forma în care observabilitatea devine utilă zilnic, nu doar în anchete. |
| 56 Checksum — sumă de control | Număr calculat din conținutul unui fișier, care funcționează ca o amprentă: dacă se schimbă un singur bit, numărul iese altul. Așa se verifică dacă un fișier uriaș a ajuns nealterat pe alt disc, fără să fie comparat bucată cu bucată. |
| 57 Metadata și metadata canonică | Metadatele sunt datele despre date: pentru un fișier video, data filmării, camera, durata, formatul, deținătorul drepturilor. Metadata canonică este versiunea oficială a acestor informații — o singură sursă de adevăr, cu format și nume de câmpuri stabilite, față de care toate copiile trebuie să corespundă. |
| 58 Stack | Ansamblul de tehnologii folosite împreună într-un proiect, de la limbaj și biblioteci până la runtime, stocare și instrumente de operare. „Alegerea stack-ului” înseamnă alegerea acestui set, nu a unui singur produs. |
| 59 RPA — robotic process automation | Programe care imită clicurile și tastările unui om în alte aplicații, pentru a muta date între sisteme care nu comunică direct. Sunt automatizare fixă: urmează pași stabiliți dinainte și se strică imediat ce interfața se schimbă. |
| 60 GIS | Sisteme informatice pentru date geografice: hărți, rețele de conducte, trasee, poziții. În exemplul cu apa și canalizarea, topologia GIS este descrierea exactă a rețelei — o sursă deterministă față de care orice interpretare a unui model poate fi verificată. |
| 61 SCADA | Sistemele care supraveghează și comandă echipamente industriale — pompe, vane, senzori. Sunt un exemplu clasic de zonă în care un model poate cel mult să explice și să propună, fiindcă acțiunea directă are consecințe fizice imediate. |
18. Referințe și surse istorice
- Alan Turing, Computing Machinery and Intelligence (1950).
- Tom M. Mitchell, Machine Learning5 (1997).
- Stuart Russell și Peter Norvig, Artificial Intelligence: A Modern Approach.
- Ian Goodfellow, Yoshua Bengio și Aaron Courville, Deep Learning7.
- Ashish Vaswani și colaboratorii, Attention Is All You Need (2017).
- Rishi Bommasani și colaboratorii, On the Opportunities and Risks of Foundation Models8 (2021).
- NIST, Artificial Intelligence Risk Management Framework43.
- Dartmouth College, istoria proiectului din 1956
- IBM, istoria programului de dame al lui Arthur Samuel
- Cornell University, Frank Rosenblatt și perceptronul