Lecția pe scurt
Întrebarea centrală: atunci când un utilizator adresează o cerere unui agent AI și primește un răspuns, câte componente diferite au fost necesare pentru ca acel lucru să fie posibil și ce responsabilitate are fiecare?
În Lecția 1 am separat concepte care sunt confundate frecvent — algoritm, model, automatizare, workflow, agent și autonomie. În Lecția 2 am intrat în interiorul agentului: obiectiv, observație, stare, alegerea acțiunii, instrumente, feedback, oprire, LLM și harness. Acum facem un pas înapoi și privim întregul sistem tehnic în care toate acestea pot funcționa.
Un agent nu „plutește” într-un nor abstract numit AI. Chiar și cel mai simplu agent are nevoie de un calculator fizic, de un sistem de operare, de software care să execute codul, de date, de permisiuni și de o interfață prin care cineva îi dă o sarcină. Dacă agentul folosește un model local, mai apar fișierele modelului, software-ul care le încarcă și, uneori, drivere și biblioteci care permit folosirea unui GPU. Dacă modelul este apelat printr-un serviciu extern, acele straturi nu dispar: sunt administrate de altcineva.
Scopul lecției nu este să instalezi toate tehnologiile pe care le vom numi și nici să alegi acum „stack-ul perfect”. Scopul este mai important: să poți privi orice produs sau diagramă și să întrebi „ce responsabilitate îndeplinește această componentă?”. Când știi să pui această întrebare, devine mult mai greu să confunzi un model cu un server de model, un driver cu CUDA, un container cu o politică de securitate sau un API cu agentul care îl folosește.
La finalul lecției vei putea
- să urmărești o cerere de la utilizator până la hardware și înapoi, identificând straturile prin care trece;
- să explici diferența dintre CPU, RAM, stocare, GPU și VRAM fără să le tratezi ca pe o listă de specificații;
- să separi sistemul de operare, kernelul, driverul și platforma de accelerare;
- să explici de ce Python, PyTorch, un fișier GGUF, Ollama și un agent sunt obiecte tehnice diferite;
- să deosebești modelul, artefactul modelului, runtime-ul de inferență și serverul de model;
- să plasezi controllerul agentului, instrumentele, datele, starea și mecanismele de securitate în locul potrivit;
- să diferențiezi logurile, metricile, urmele de execuție, testele și evaluările;
- să explici ce se schimbă și ce nu se schimbă când sistemul rulează local, în cloud, hibrid sau la marginea rețelei (edge);
- să descrii compatibilitatea ca proprietate a întregului sistem, nu ca proprietate izolată a unei singure componente;
- să reconstruiești din memorie harta stack-ului și să justifici relațiile dintre straturi.
1. Ce înseamnă un stack și de ce contează
Începem prin a separa două idei care par asemănătoare, dar nu sunt: lista produselor pe care le folosim și harta responsabilităților care trebuie îndeplinite.
Imaginează-ți că deschizi o pagină web, scrii „rezumă acest contract” și primești un răspuns. Din exterior vezi doar două lucruri: o interfață și textul final. Din interior, însă, pot exista zeci de operații: browserul trimite o cerere, aplicația identifică utilizatorul, salvează documentul, agentul1 decide ce informații îi trebuie, un parser extrage textul, un model este apelat, rezultatul este verificat, starea4 este actualizată, iar sistemul înregistrează ce s-a întâmplat.
Sub toate acestea există alte responsabilități pe care utilizatorul nu le vede: procese care rulează în sistemul de operare, memorie alocată, fișiere citite de pe SSD, trafic de rețea, eventual operații executate pe GPU19. Dacă modelul rulează pe un server al altui furnizor, acele componente nu au dispărut. Ele se află doar în infrastructura furnizorului.
De aceea, în această lecție folosim stack-ul ca pe o hartă a responsabilităților. Întrebarea utilă nu este „ce produs avem aici?”, ci „ce trebuie să facă această parte a sistemului?”. Același produs poate acoperi mai multe responsabilități, iar aceeași responsabilitate poate fi împărțită între mai multe produse.
O analogie utilă: o clădire în care etajele depind unele de altele
Gândește-te la o clădire. Un birou elegant de la etajul zece nu poate exista fără structură de rezistență, electricitate, apă, lifturi, acces și întreținere. Totuși, faptul că există instalația electrică nu îți spune ce activitate se desfășoară în birou. Fiecare nivel are altă responsabilitate.
Un stack software funcționează asemănător. Hardware-ul17 oferă resurse fizice. Sistemul de operare le organizează. Driverul22 permite folosirea corectă a unui dispozitiv. Runtime-ul10 execută un anumit tip de program. Un server de model29 face modelul accesibil. Controllerul12 agentului1 decide ce acțiune urmează. Instrumentele5 modifică sau interoghează lumea din afara modelului. Interfața permite utilizatorului să formuleze obiectivul.
1.1 Ce se schimbă atunci când modelul este local sau găzduit de altcineva
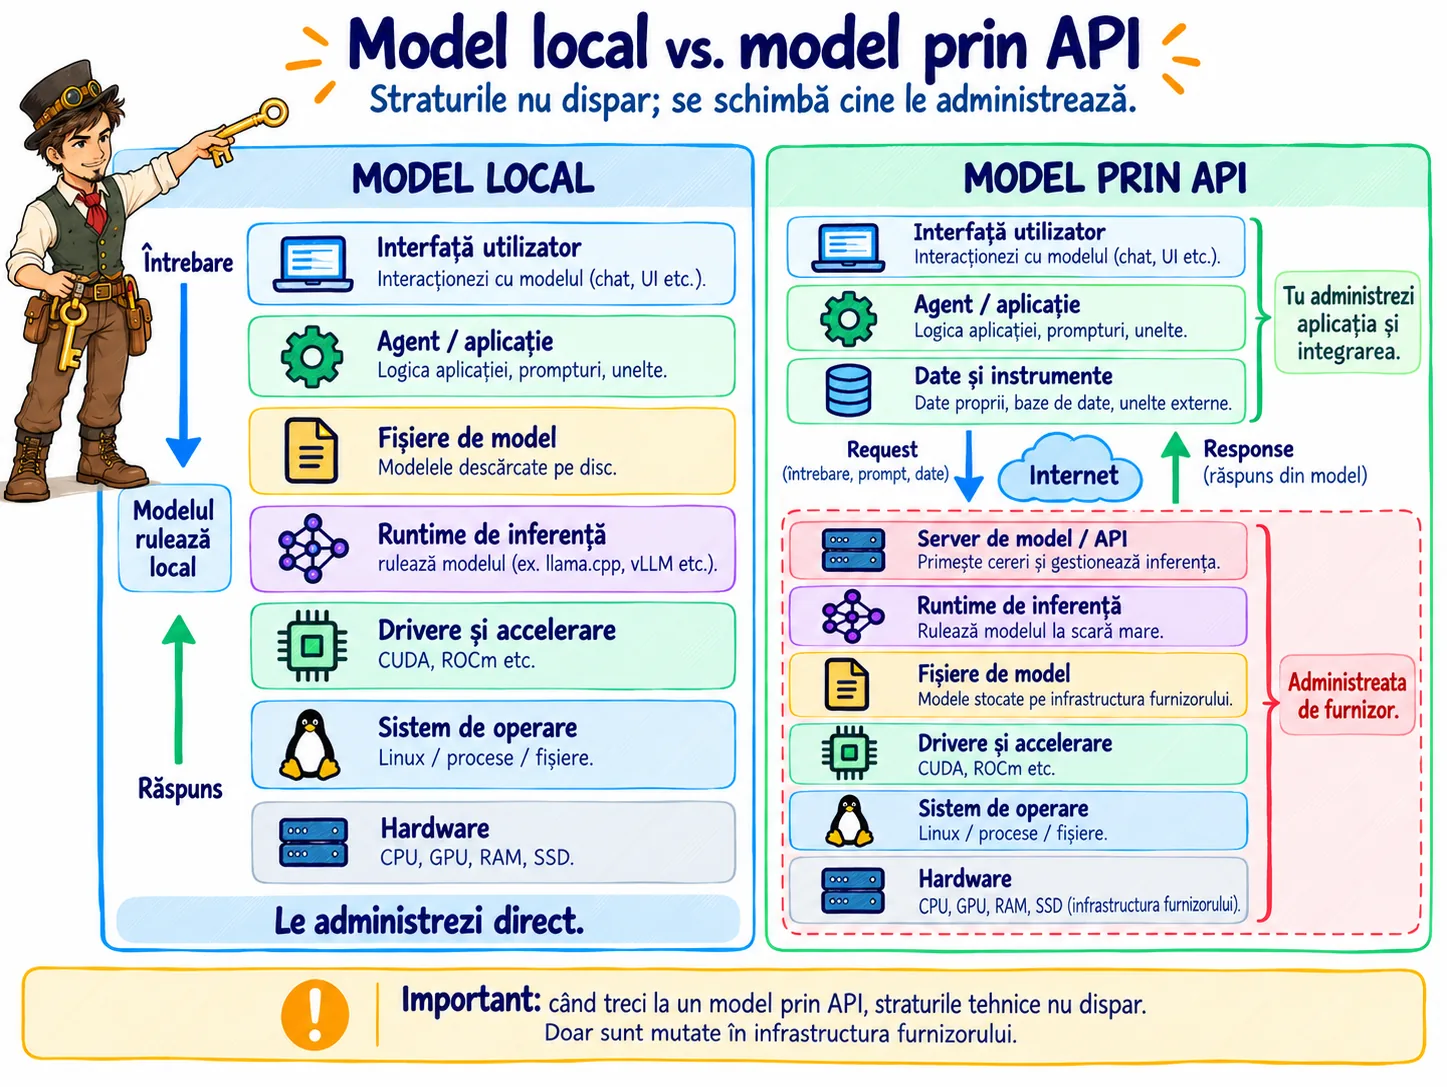
Dacă rulezi un model pe propriul calculator, tu vezi și administrezi o parte mare din stack: modelul ocupă spațiu pe SSD, runtime-ul10 îi alocă RAM sau VRAM20, driverul22 trebuie să funcționeze, iar sistemul de operare trebuie să poată vedea dispozitivul de calcul.
Dacă aplicația ta apelează un model printr-un API9 găzduit de altă companie, propriul calculator nu trebuie să încarce acel model. Totuși, undeva există în continuare servere, memorie, sisteme de operare, drivere22 și software de inferență. Furnizorul le operează pentru tine. În schimb, tu rămâi responsabil de propriile date, de logica agentului1, de permisiunile instrumentelor5 și de ceea ce faci cu răspunsul primit.
2. Harta completă: paisprezece responsabilități, șase zone ușor de reținut
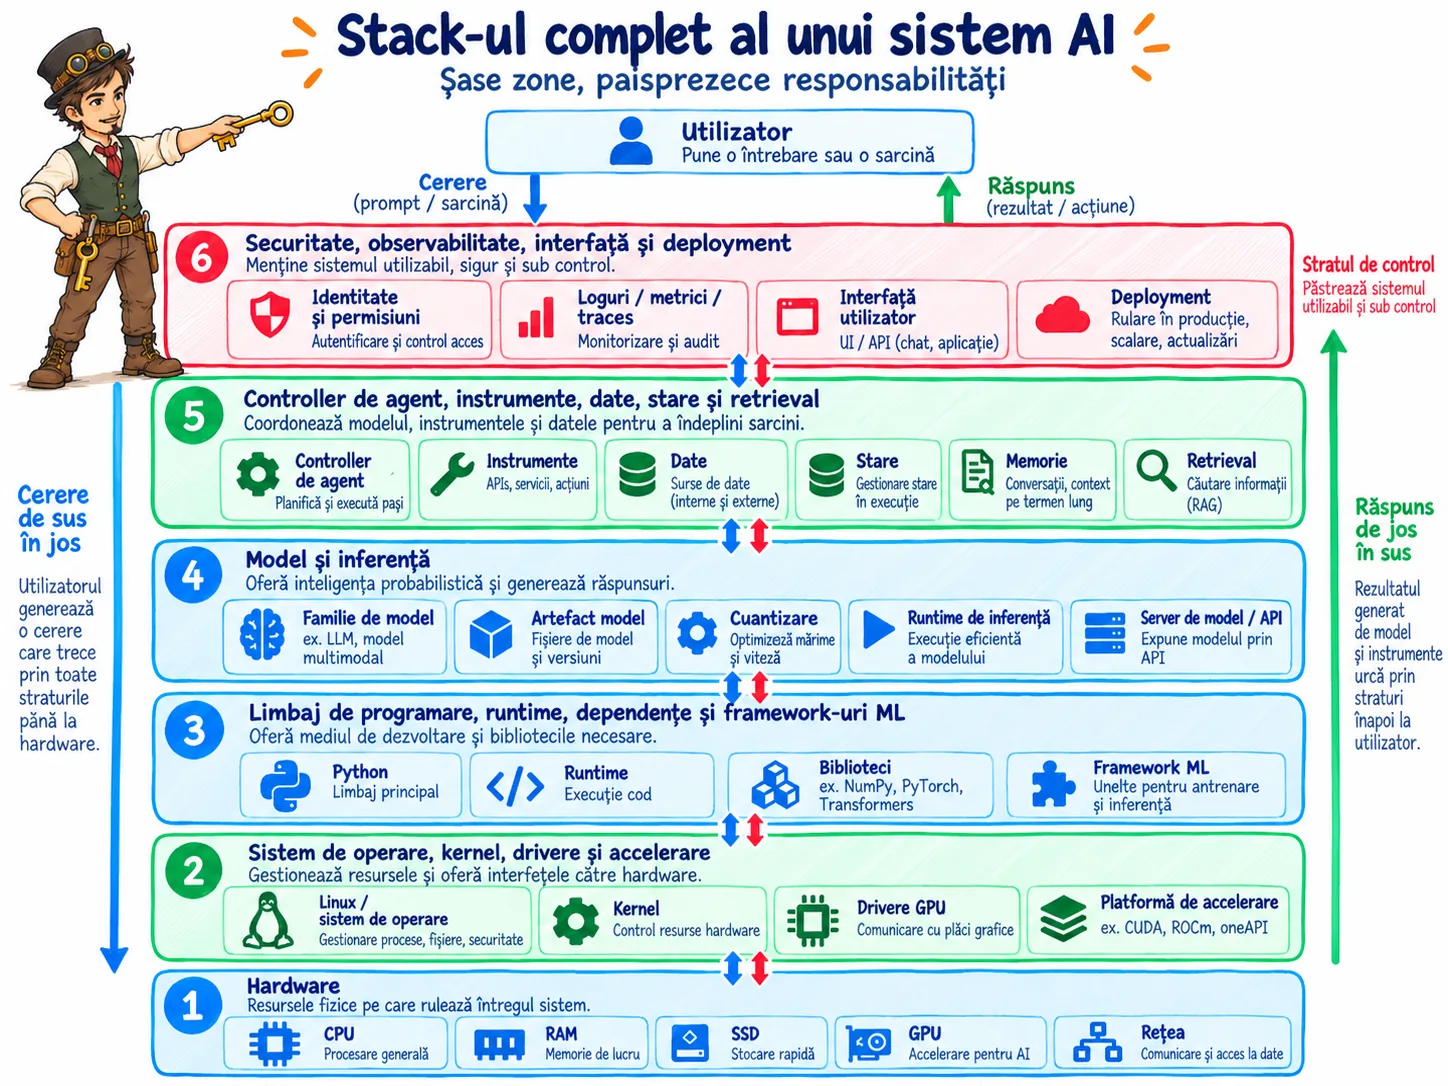
Harta tehnică a lecției enumeră paisprezece straturi. Le păstrăm pe toate, dar le grupăm în șase zone pentru ca harta să poată fi înțeleasă înainte de a fi memorată.
În tabelul următor, fiecare rând răspunde la o întrebare diferită. Prima coloană spune ce întrebare trebuie să poți pune. A doua numește responsabilitatea tehnică. A treia oferă un exemplu concret. Nu citi tabelul ca pe o listă de produse pe care trebuie să le instalezi; citește-l ca pe o listă de funcții care trebuie să fie îndeplinite undeva în sistem.
| Întrebarea practică | Responsabilitatea din stack | Exemplu concret |
|---|---|---|
| Unde se face fizic calculul și unde stau datele? | 1. Hardware17 fizic | CPU-ul18 execută cod general, RAM-ul ține date active, SSD-ul păstrează fișiere după oprire, iar un GPU19 poate accelera calculele paralele. |
| Cine organizează procesele, fișierele, memoria și dispozitivele? | 2. Sistem de operare și drivere22 | Linux pornește procesele și aplică permisiuni; driverul22 GPU19 permite sistemului să folosească acel dispozitiv. |
| Prin ce software ajung calculele la un accelerator? | 3. Platformă de accelerare23 | CUDA23 pentru anumite sisteme NVIDIA, ROCm pentru anumite sisteme AMD, sau alte căi specifice hardware-ului17. |
| Ce execută aplicația noastră? | 4. Limbaj, runtime10 și dependențe | Un program Python este executat de mediul Python și folosește pachetele instalate pentru proiect. |
| Ce software implementează operațiile numerice ale modelelor? | 5. Framework ML și biblioteci numerice | PyTorch poate executa operații pe tensori24 și poate folosi CPU18 sau un suport de calcul GPU19 compatibil. |
| Unde sunt stocate valorile învățate de model? | 6. Artefactul26 modelului | Un set de fișiere poate conține ponderi25, configurație, tokenizer, licență și alte metadate. |
| Cine încarcă modelul și îi execută inferența? | 7. Runtime de inferență28 / server de model29 | Un runtime10 citește artefactul26, alocă memorie și produce ieșiri; un server îl poate expune prin API9. |
| Cine decide ce pas urmează pentru atingerea obiectivului? | 8. Controllerul12 agentului1 | Bucla deterministă din Lecția 2 sau un framework de orchestrare păstrează starea4 și alege între model și instrumente5. |
| Cum citește sau modifică sistemul ceva din afara modelului? | 9. Instrumente5 și integrări | Un calculator, o bază de date, un API9 de calendar sau o funcție de creare a unui draft sunt instrumente5 cu intrări și ieșiri definite. |
| Unde păstrăm documentele, starea4 și informațiile care trebuie găsite ulterior? | 10. Date, stare4, memorie și retrieval | Fișiere, SQLite/PostgreSQL, stocare de obiecte și indecși de căutare pot îndeplini roluri diferite. |
| Cine are voie să facă ce și unde sunt păstrate secretele? | 11. Securitate, identitate și guvernanță | Permisiunile sistemului de operare, OAuth, cheile de acces, aprobările umane și izolarea limitează autoritatea. |
| Cum aflăm ce s-a întâmplat și dacă sistemul funcționează bine? | 12. Observabilitate31, teste și evaluări | Logurile arată evenimente, metricile arată tendințe numerice, urmele leagă pașii aceleiași cereri, iar testele/evaluările verifică rezultatul. |
| Cum intră cererea în sistem și cum ajunge rezultatul la utilizator? | 13. Interfață și aplicație | CLI, pagină web, chat, aplicație mobilă, voce, e-mail, API9 sau un eveniment de la un senzor. |
| Unde rulează întregul sistem și cine îl menține disponibil? | 14. Deployment33 și operațiuni | Poate rula pe laptop, pe un server local, în cloud, într-un cluster sau pe un dispozitiv aflat lângă sursa datelor. |
Cum citești harta: dacă înlocuiești un produs, de obicei nu elimini responsabilitatea. De exemplu, dacă nu mai rulezi modelul local și folosești un API9 extern, responsabilitățile 1–7 există în continuare, dar o parte dintre ele sunt administrate de furnizor. Dacă un produs acoperă mai multe rânduri, rândurile nu se contopesc conceptual: trebuie să știi în continuare ce face produsul în fiecare rol.
Testul de memorie al celor șase zone: dacă poți răspunde la cele șase întrebări de mai jos, poți reconstrui harta chiar dacă uiți ordinea celor paisprezece responsabilități.
- Zona I: Cu ce resurse fizice lucrăm?
- Zona II: Cum devin acele resurse utilizabile de software?
- Zona III: Ce execută aplicația și calculele de machine learning?
- Zona IV: Cum ajunge un model stocat pe disc să poată răspunde?
- Zona V: Cine decide ce se întâmplă și prin ce instrumente5 și date?
- Zona VI: Cum limităm, observăm, expunem și administrăm sistemul?
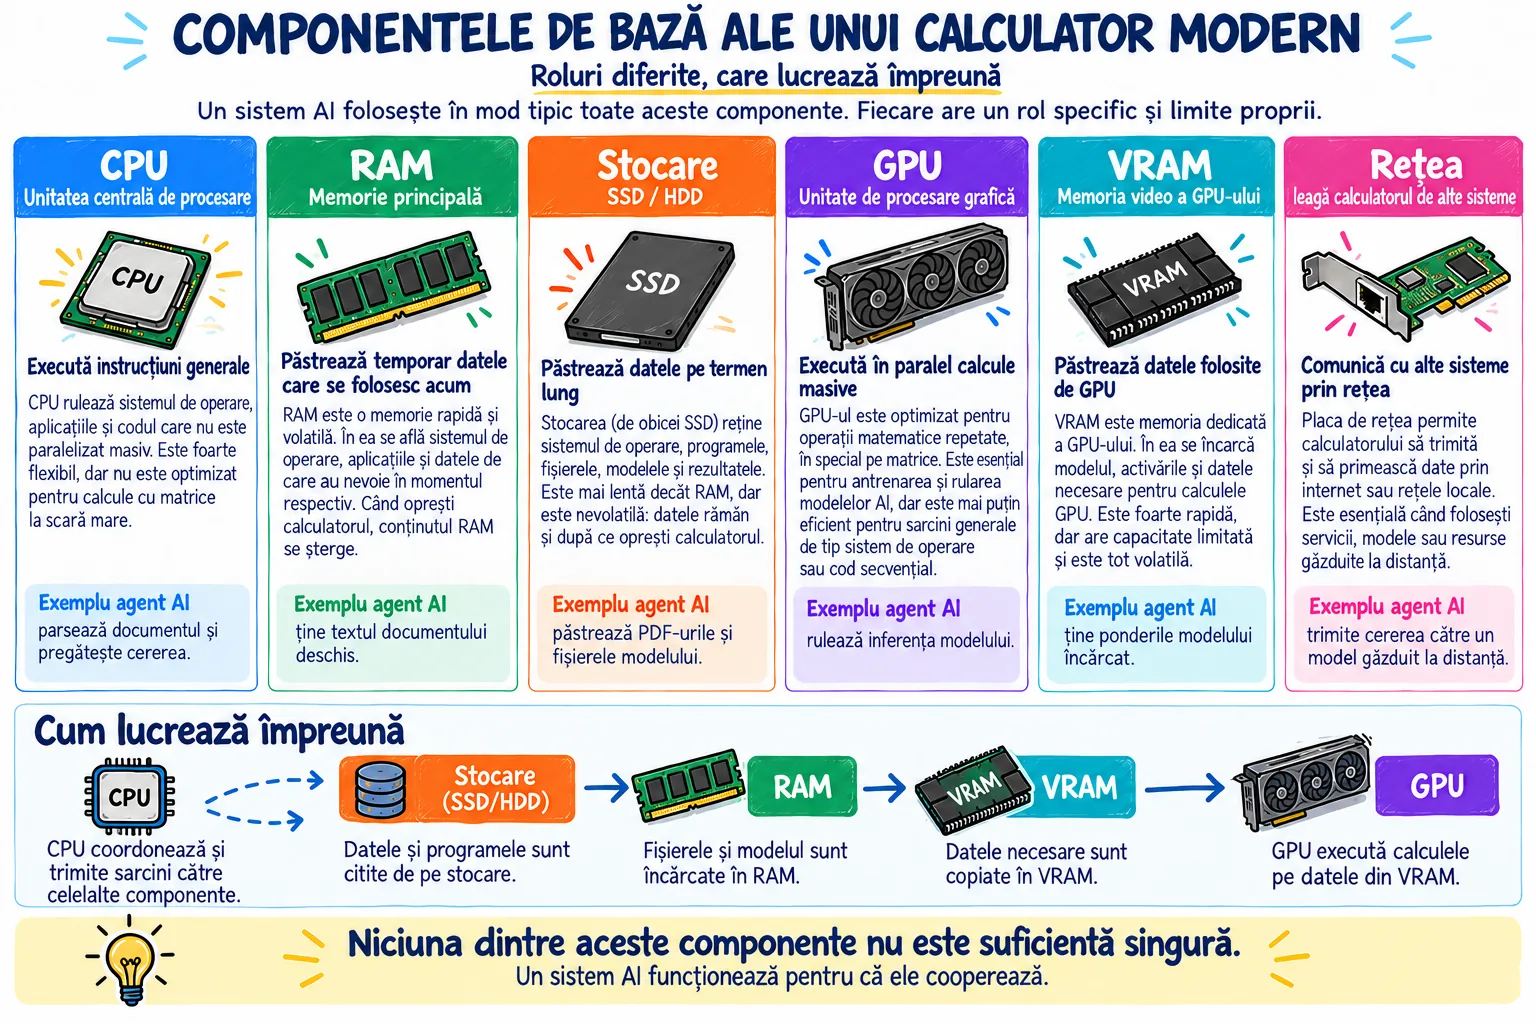
3. Zona I — fundația fizică: CPU, RAM, stocare, GPU, VRAM și rețea
Hardware-ul17 stabilește limitele fizice ale sistemului: câtă putere de calcul avem la dispoziție, câtă informație putem păstra activă, cât de repede putem încărca fișiere și ce volum de trafic putem transfera. Specificațiile nu aleg însă arhitectura în locul nostru.
3.1 CPU, RAM și stocare — resursele generale ale sistemului
CPU18 — procesorul general care nu dispare atunci când apare GPU-ul19
CPU18 vine de la central processing unit. Este procesorul general al calculatorului. Sistemul de operare, aplicația agentului1, parsarea JSON, accesul la fișiere, multe interogări de baze de date, apelurile de rețea și o parte din pregătirea datelor sunt executate de CPU chiar și într-un sistem care folosește un GPU19 pentru inferență.
Un GPU19 foarte puternic nu face CPU-ul18 inutil. Imaginează-ți un restaurant cu o bucătărie industrială extraordinară, dar cu o singură persoană care primește comenzile, verifică ingredientele și duce farfuriile. Dacă acea parte este lentă, bucătăria poate sta degeaba. Într-un sistem AI, blocajul poate fi modelul, dar poate fi la fel de bine citirea de pe disc, pregătirea datelor, rețeaua sau logica aplicației.
RAM — memoria de lucru a programelor aflate în execuție
RAM este memoria de lucru rapidă a calculatorului. Când pornești o aplicație, o parte din codul și datele ei ajung în RAM. Spre deosebire de SSD sau hard disk, conținutul RAM nu este conceput pentru a rămâne după oprirea alimentării.
Într-un sistem AI local, RAM-ul poate fi ocupat de sistemul de operare, browser, runtime-ul10 Python, baze de date, indecși de documente, fișiere temporare, procesele agentului1 și, în unele configurații, o parte din model. Dacă RAM-ul este insuficient, sistemul poate deveni foarte lent sau poate refuza alocări noi.
Stocarea — ceea ce trebuie să supraviețuiască opririi
SSD-ul sau hard disk-ul păstrează datele în mod persistent: cod, modele descărcate, baze de date, documente, imagini, loguri, rezultate de evaluare și imagini de container34. Un fișier de model mare poate avea de la câteva sute de megabytes la zeci sau sute de gigabytes, iar colecțiile de date pot depăși cu mult dimensiunea modelului.
Nu contează numai capacitatea. Viteza de citire influențează cât de repede poate fi încărcat un model sau un set de date. Într-un sistem care pornește modelul o singură dată și apoi îl ține în memorie, viteza SSD-ului poate conta mai mult la pornire decât după aceea.
3.2 GPU și VRAM — calcul paralel și memorie aflată lângă accelerator
GPU19 vine de la graphics processing unit. Deși aceste procesoare au fost dezvoltate pentru grafică, structura lor este potrivită și pentru executarea în paralel a unui număr foarte mare de operații numerice. Rețelele neuronale folosesc intens astfel de operații, motiv pentru care GPU-urile au devenit importante pentru antrenare și inferență.
VRAM20 este memoria direct disponibilă unui GPU19 discret. Acolo pot sta ponderile25 modelului, reprezentări intermediare și cache-uri folosite în timpul generării. Cantitatea necesară nu depinde doar de „numărul de parametri” al modelului. Contează precizia numerică sau cuantizarea27, lungimea contextului, numărul cererilor simultane, arhitectura modelului și tipul sarcinii.
Un model care încape tehnic în memorie nu este neapărat practic. Poate răspunde foarte lent, poate lăsa prea puțină memorie pentru un context mai lung sau poate servi un singur utilizator în condiții acceptabile, dar nu zece simultan.
3.3 Rețeaua — comunicarea dintre componente
Rețeaua contează imediat ce o parte a stack-ului se află în altă parte: model prin API9, bază de date aflată la distanță, stocare comună, senzori, aplicație mobilă sau mai multe servere. Lățimea de bandă, latența și disponibilitatea rețelei pot deveni parte din experiența utilizatorului.
„Local” nu înseamnă întotdeauna „fără rețea”. Un agent1 poate rula fără internet și totuși să comunice prin rețeaua internă cu un NAS, un senzor, un alt computer sau un server al companiei.
Tabelul următor nu compară „care componentă este mai importantă”, ci arată ce problemă rezolvă fiecare resursă. Citește fiecare rând pornind de la simptomul pe care l-ai putea vedea într-un sistem real.
| Dacă observi... | Resursa pe care o verifici mai întâi | De ce |
|---|---|---|
| Aplicația întreagă se mișcă greu chiar și înainte să înceapă modelul. | CPU18 | Logica aplicației, parsarea, pregătirea datelor și multe operații de sistem sunt executate de CPU18. Un accelerator nu compensează automat un procesor general foarte ocupat. |
| Sistemul începe să folosească swap sau programele sunt închise din lipsă de memorie. | RAM | Datele și procesele active au nevoie de memorie de lucru. Dacă RAM-ul nu ajunge, sistemul încearcă soluții mult mai lente sau refuză noi alocări. |
| Modelul nu încape pe GPU19 sau contextul lung produce erori de memorie. | VRAM20 | Ponderile25 și stările4 temporare ale inferenței ocupă memoria acceleratorului. Cuantizarea27 și lungimea contextului pot schimba mult necesarul. |
| Prima pornire a modelului durează foarte mult, dar după încărcare răspunde normal. | Stocare | Fișierele mari trebuie citite de pe SSD/hard disk înainte să ajungă în RAM sau VRAM20. Un dispozitiv lent poate prelungi pornirea. |
| Uneori serviciul de model găzduit la distanță răspunde normal, iar alteori apar întârzieri sau depășiri ale timpului de așteptare (timeout-uri) când conexiunea este slabă. | Rețea | Cererea și răspunsul trebuie transportate între aplicație și serviciul extern; problema poate exista fără ca modelul să fie lent. |
Concluzia: performanța este rezultatul unui traseu complet. Când un sistem este lent, nu începe diagnosticul cu presupunerea „modelul este prea mare”. Mai întâi identifică etapa în care apare întârzierea.
4. Zona II — de la hardware la software: sistem de operare, kernel, drivere și accelerare
Hardware-ul17 există fizic, dar aplicațiile nu îl controlează direct după bunul plac. Între program și dispozitive există straturi care organizează accesul, împart resursele și traduc cererile software în operații pe hardware.
4.1 Sistemul de operare și kernelul — cine administrează resursele și mediază accesul la hardware
Sistemul de operare — administratorul resurselor calculatorului
Sistemul de operare este software-ul de bază care organizează procesele, memoria, fișierele, utilizatorii, dispozitivele, rețeaua și permisiunile. Ubuntu și Kubuntu sunt sisteme Linux; ele folosesc același nucleu Linux, dar pot avea interfețe grafice și pachete implicite diferite.
Pentru un agent1 software, sistemul de operare contează foarte concret. El decide în ce folder poate scrie procesul, ce dispozitive vede, ce porturi de rețea poate deschide, ce utilizator îl execută și ce alte procese există. Lecțiile următoare vor intra mult mai adânc în aceste concepte; aici trebuie doar să vezi locul lor în hartă.
Kernelul21 — partea privilegiată care mediază accesul la hardware17
Kernelul21 este nucleul privilegiat al sistemului de operare. O aplicație obișnuită nu comunică direct, fără intermediere, cu controlerul SSD, placa de rețea sau memoria fizică. Ea cere sistemului de operare operații controlate, iar kernelul gestionează accesul la resurse.
Această separare este importantă și pentru securitate. Dacă orice proces ar putea citi memoria oricărui alt proces sau ar controla orice dispozitiv fără reguli, izolarea dintre aplicații ar dispărea. Autoritatea reală a agentului1 nu este determinată doar de prompt3; ea depinde și de drepturile procesului în sistemul de operare.
4.2 Driverul — legătura dintre sistemul de operare și un dispozitiv
Un driver22 este software-ul care permite sistemului de operare să comunice corect cu o anumită categorie de hardware17. Pentru GPU19-uri poți întâlni, de exemplu, drivere NVIDIA, driverul Linux amdgpu pentru hardware AMD sau drivere Intel.
Un driver22 funcțional nu înseamnă automat că ai instalat toate instrumentele5 pentru dezvoltare GPU19. De exemplu, sistemul poate vedea un GPU și îl poate folosi pentru afișarea desktopului, chiar dacă nu ai instalat un pachet complet de dezvoltare (toolkit) pentru calcul sau un framework de machine learning.
4.3 Platforma de accelerare — software-ul care folosește eficient hardware-ul specializat
O platformă de accelerare23 este un ansamblu de runtime-uri10, compilatoare, biblioteci și instrumente5 care fac posibilă folosirea unui accelerator pentru calcule generale. CUDA este platforma NVIDIA pentru calcul paralel pe GPU19-uri compatibile. ROCm este stack-ul software AMD pentru calcul accelerat pe GPU-uri compatibile. Alte ecosisteme au alte căi, cum ar fi Metal în ecosistemul Apple sau tehnologii Intel specifice platformei.
Nu trebuie să înveți acum API9-urile acestor platforme. Ideea de reținut este relația dintre straturi: driverul22 face dispozitivul utilizabil de sistem; platforma de accelerare23 oferă mecanisme prin care software-ul de calcul poate folosi dispozitivul eficient; framework-ul sau runtime-ul de inferență28 folosește acele mecanisme pentru model.
GPU fizic
   ↓
driver compatibil
   ↓
platformă / biblioteci de accelerare
   ↓
framework sau runtime de inferență
   ↓
modelul executat
Tabelul următor este construit pentru una dintre cele mai frecvente confuzii de început: toate componentele par „software pentru GPU19”, dar fiecare răspunde la altă întrebare. Coloana din mijloc spune ce face componenta; ultima coloană arată ce concluzie nu avem voie să tragem doar din existența ei.
| Componentă | Ce face, concret | Ce NU dovedește existența ei |
|---|---|---|
| Driver22 GPU19 | Permite sistemului de operare și aplicațiilor compatibile să comunice cu dispozitivul. | Nu dovedește că ai instalat un framework ML, un runtime de inferență28 sau un model. |
| CUDA23 / ROCm / altă platformă de accelerare | Oferă runtime-uri10, biblioteci, compilatoare sau interfețe pentru calcule accelerate. | Nu este modelul și nu este agentul1. Nici nu garantează că orice placă a furnizorului este compatibilă cu orice versiune. |
| PyTorch sau alt framework ML | Oferă operații pe tensori24 și mecanisme pentru definirea sau executarea modelelor; poate utiliza un mecanism de calcul compatibil cu hardware-ul17. | Nu dovedește că un anumit model este descărcat și nici că există o buclă de agent1. |
| Runtime de inferență28 | Încarcă un artefact26 de model, alocă memorie și execută inferența. | Nu definește automat obiectivul agentului1, permisiunile sau instrumentele5 sale. |
Cum interpretezi tabelul: într-un incident real, întrebarea „unde se rupe lanțul?” este mai bună decât „de ce nu merge AI-ul?”. Dacă sistemul de operare nu vede GPU-ul19, problema este mai jos decât PyTorch. Dacă PyTorch vede acceleratorul, dar modelul nu se încarcă, cauți mai sus: artefact26, memorie, format sau runtime10.
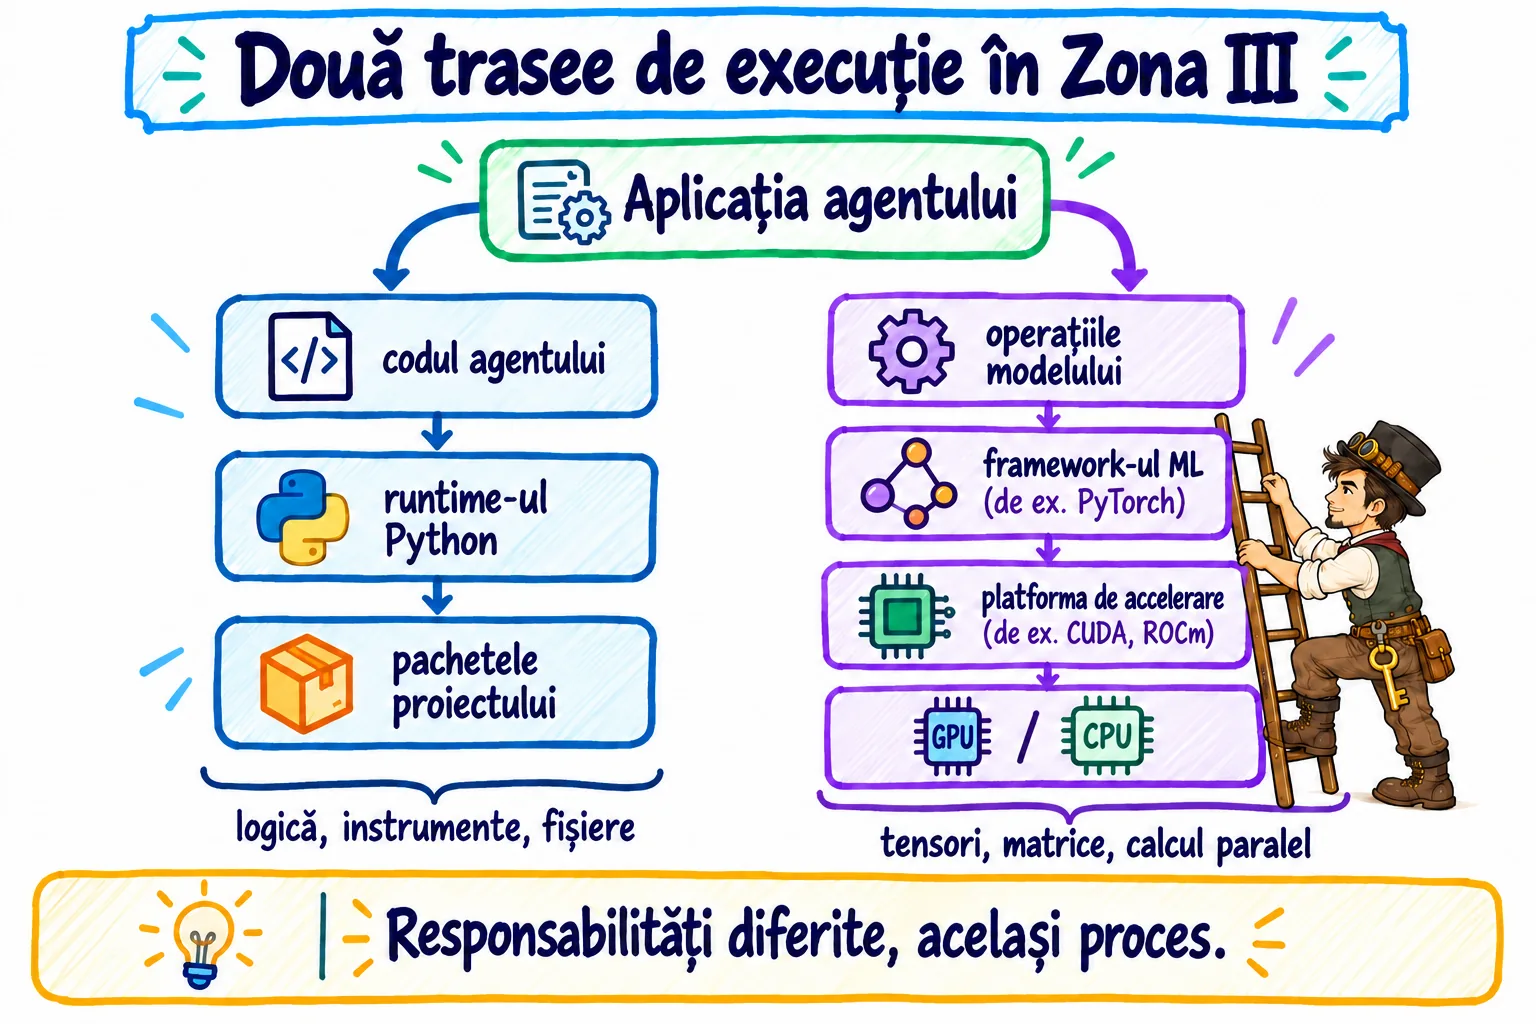
5. Zona III — software-ul care execută aplicația și calculele modelului
Acum urcăm un nivel. Sistemul de operare poate rula procese și poate vedea hardware-ul17; următoarea întrebare este ce mediu execută codul aplicației și ce biblioteci implementează operațiile matematice folosite de modele.
5.1 Limbaj, runtime, dependențe și mediu virtual
În laboratoarele anterioare ai folosit Python și un mediu virtual. Aici le plasăm pe amândouă în hartă. Codul Python al agentului1 este un set de instrucțiuni; runtime-ul10 Python este software-ul care le interpretează și le execută. Pachetele instalate pentru proiect sunt dependențe: cod de care aplicația depinde pentru anumite funcții.
Un agent1 nu trebuie să fie scris în Python. Poate fi scris în TypeScript, JavaScript, Rust, Go, Java, C# sau alt limbaj. Alegerea limbajului schimbă ecosistemul de pachete și modul de deployment33, dar nu schimbă responsabilitățile pe care le presupune un agent.
Un proiect reproductibil trebuie să poată răspunde la întrebări simple: ce versiune de limbaj folosește? ce pachete și versiuni cere? ce variabile de mediu trebuie definite? ce comandă pornește serviciul? ce comandă rulează testele? Fără aceste informații, „merge la mine” nu este o descriere tehnică suficientă.
Mediul virtual Python nu este o mașină virtuală și nu este un sandbox7
Un mediu virtual Python izolează în principal interpretorul și pachetele Python ale proiectului. Dacă două proiecte au nevoie de versiuni diferite ale aceleiași biblioteci, mediile virtuale reduc conflictul.
El nu creează însă un sistem de operare separat și nu reprezintă o barieră serioasă de securitate. Un program din mediul virtual poate avea, în limitele utilizatorului care îl execută, acces la fișiere, rețea și alte resurse ale sistemului. De aceea nu trebuie confundat cu o mașină virtuală, un container34 configurat restrictiv sau un sandbox7 de execuție.
5.2 Tensorul — forma de date pe care framework-urile ML o manipulează masiv
Un tensor24 este, în termeni practici, o structură multidimensională de numere. Un singur număr poate fi privit ca tensor cu zero dimensiuni; o listă de numere ca tensor cu o dimensiune; un tabel ca tensor cu două dimensiuni; un lot de imagini poate necesita și mai multe dimensiuni.
În rețele neuronale, ponderile25, embeddings, imaginile transformate numeric și multe rezultate intermediare sunt reprezentate ca tensori24. Framework-urile ML oferă operații eficiente pentru prelucrarea acestor structuri și pentru a executa aceleași calcule pe CPU18 sau pe acceleratoare compatibile.
5.3 Framework-uri și biblioteci ML — unde sunt implementate operațiile numerice
PyTorch, TensorFlow și JAX sunt exemple de software pentru calcul numeric și machine learning. Ele pot ajuta la definirea, antrenarea și executarea modelelor, folosind operații pe tensori24 și mecanisme de diferențiere/optimizare.
Acestea nu sunt, prin simplul fapt că există, framework-uri de agenți1. PyTorch poate calcula ieșirea unei rețele neuronale, dar nu stabilește automat obiectivul agentului, nu decide ce instrument5 de business este permis și nu cere aprobarea unui om înainte de o plată. Aceste responsabilități apar mai sus în stack.
Biblioteci de suport — piesele specializate care fac execuția eficientă
În jurul framework-urilor există numeroase biblioteci cu roluri mai înguste. NumPy oferă structuri și operații numerice generale. Biblioteci precum cuDNN oferă primitive optimizate pentru anumite operații neuronale pe hardware17 NVIDIA. Tokenizer-ele transformă textul în identificatori de tokeni, iar bibliotecile de comunicație pot coordona calcule distribuite pe mai multe acceleratoare.
Nu trebuie să memorezi aceste nume acum. Lecția importantă este diferența de scară: o bibliotecă oferă de regulă o capacitate reutilizabilă, un framework organizează un ansamblu mai larg de dezvoltare, iar un engine/runtime10 execută un anumit tip de sarcină. Marketingul nu folosește aceste cuvinte perfect consecvent, deci verificăm responsabilitatea reală.
Tabelul următor răspunde la o întrebare foarte practică: când vezi un nume într-un tutorial, la ce nivel trebuie să-l plasezi? Exemplele sunt intenționat contrastante ca să nu tratăm toate „tehnologiile AI” ca aceeași categorie.
| Exemplu | Ce fel de lucru este | Ce responsabilitate îndeplinește în exemplul nostru |
|---|---|---|
| Python | Limbaj + runtime10 de programare | Execută logica aplicației și controllerul12 agentului1 scrise în Python. |
| pip / uv / alt manager de pachete | Instrument5 de gestionare a dependențelor | Instalează și urmărește pachetele de care codul are nevoie. |
| NumPy | Bibliotecă numerică | Oferă structuri și operații eficiente pe date numerice. |
| PyTorch | Framework de machine learning | Execută operații pe tensori24 și modele și poate utiliza mecanisme de calcul diferite (backend-uri). |
| LangGraph | Framework pentru orchestrarea aplicațiilor/agenților1 | Poate coordona stare4 și tranziții între pași; nu este framework pentru calculele neuronale ale modelului în sensul PyTorch. |
Observația importantă: cuvântul „framework” nu garantează că două produse sunt din aceeași categorie. Trebuie să adaugi mereu întrebarea „framework pentru ce?”.
6. Zona IV — modelul nu rulează singur: artefact, cuantizare, runtime de inferență și server de model
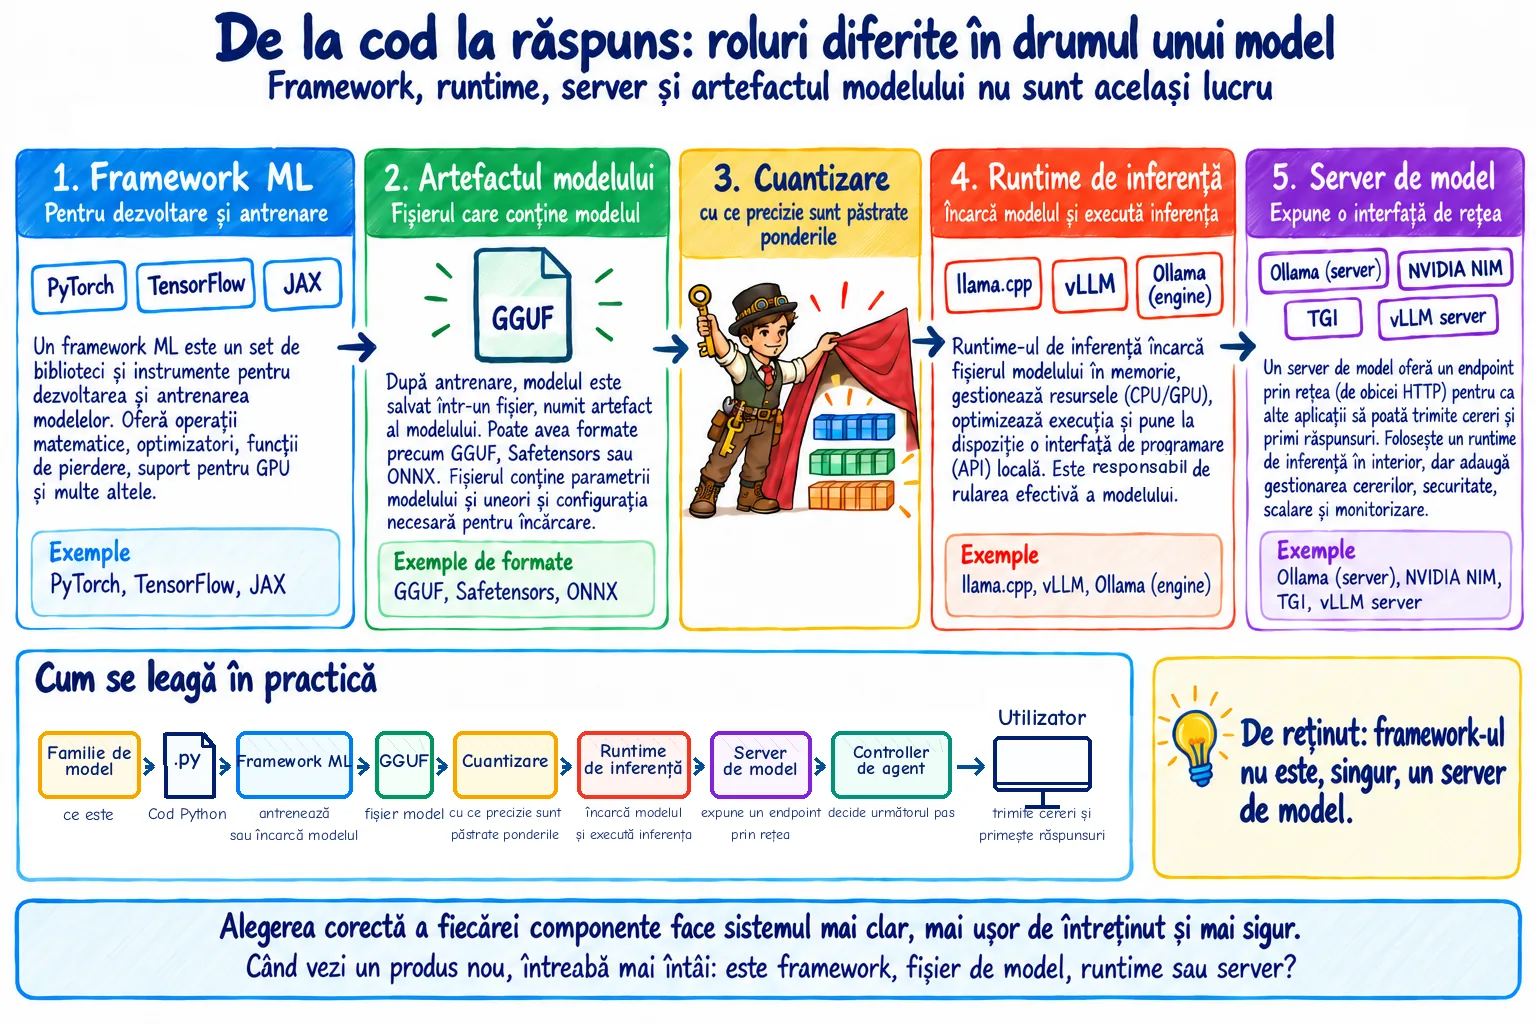
Aceasta este una dintre cele mai importante distincții ale lecției. În limbaj obișnuit spunem adesea „rulez modelul”, dar tehnic sunt implicate mai multe obiecte diferite: modelul ca arhitectură și ansamblu de capacități, fișierele care conțin parametrii și software-ul care știe să le încarce și să execute inferența.
6.1 Artefactul modelului — ponderi, format, model card și licență
Modelul și artefactul26 modelului nu sunt același lucru
În Lecțiile 1 și 2 am folosit cuvântul model pentru componenta care transformă o intrare în ieșire. Când ajungem la infrastructură, trebuie să separăm această idee de fișierele concrete stocate pe disc.
Un artefact26 de model este ansamblul de fișiere care păstrează ceea ce trebuie încărcat pentru a folosi un model antrenat. Poate conține ponderile25 învățate, configurația arhitecturii, vocabularul și regulile tokenizerului, șablonul de conversație, informații despre cuantizare27, configurația componentelor de preprocesare pentru imagini sau audio și documente precum model card sau licență.
Ponderile25 (weights) sunt valorile numerice ajustate în timpul antrenării. Ele nu sunt un program care se execută singur. Sunt date numerice pe care un software compatibil le citește și le folosește în operațiile definite de arhitectură.
Formatul fișierului nu este familia modelului
Vei întâlni formate precum Safetensors, GGUF, ONNX sau checkpoint-uri specifice unui framework. Aceste nume descriu modul în care datele modelului sunt împachetate sau reprezentate pentru anumite ecosisteme; nu descriu automat ce știe modelul.
De aceea propoziția „folosesc un GGUF” este incompletă. GGUF spune ceva despre formatul artefactului26 și despre ecosistemele care îl pot încărca. Nu spune ce familie de model este, câți parametri are, în ce limbi este bun, ce licență are sau cât de bine rezolvă sarcina ta.
Tabelul următor separă patru întrebări pe care începătorii le comprimă frecvent într-una singură. Fiecare rând descrie altă proprietate a aceluiași sistem.
| Întrebarea corectă | Exemplu de răspuns | Ce aflăm de fapt |
|---|---|---|
| Ce model folosim? | „Un model din familia Qwen” sau altă familie aleasă. | Aflăm identitatea/capabilitățile modelului, dar nu știm încă în ce format îl avem și cu ce îl rulăm. |
| În ce format este artefactul26? | „Fișier GGUF” sau „fișiere Safetensors”. | Aflăm cum sunt împachetate datele și ce software poate fi compatibil; nu aflăm singuri calitatea modelului. |
| Ce cuantizare27 folosim? | „Variantă pe 4 biți”, dacă ecosistemul/modelul oferă o astfel de reprezentare. | Aflăm ceva despre reprezentarea numerică și necesarul de memorie; nu aflăm automat viteza sau calitatea finală. |
| Cu ce software îl executăm? | „llama.cpp”, „Ollama”, „vLLM” sau alt runtime10/server compatibil. | Aflăm cine încarcă artefactul26 și execută inferența; acesta încă nu este automat controllerul12 agentului1. |
Concluzia: o descriere tehnică bună poate conține toate cele patru răspunsuri. Dacă lipsește unul dintre ele, nu presupune că restul poate fi dedus din numele unui singur produs.
Model card și licență — faptul că poți descărca fișierele nu înseamnă că le poți folosi oricum
Repository-ul unui model poate include un model card, adică documentația care descrie scopul modelului, datele sau procedurile de antrenare cunoscute, limitări, evaluări și recomandări de utilizare. Calitatea acestor documente variază, dar ele sunt primul loc în care cauți informații despre model înainte să îl integrezi.
Licența este o problemă separată de performanță. Faptul că ponderile25 pot fi descărcate nu înseamnă automat că orice utilizare comercială, redistribuire sau modificare este permisă. Pentru un produs real verifici textul licenței aplicabile artefactului26 și componentelor software din jur.
6.2 Cuantizarea — mai puțini biți pentru reprezentarea valorilor
Cuantizarea27 (quantization) reduce precizia numerică folosită pentru a reprezenta anumite valori ale modelului. Scopul practic este de obicei reducerea memoriei și, în anumite condiții, creșterea vitezei. Compromisul este că reprezentarea mai puțin precisă poate modifica rezultatele, iar metodele de cuantizare nu sunt toate echivalente.
Ca intuiție aritmetică, dacă am păstra 7 miliarde de valori la 16 biți fiecare, doar acele valori ar necesita aproximativ 14 GB. La 4 biți, aceeași socoteală brută ar fi aproximativ 3,5 GB. În practică există metadate, alte structuri și memorie temporară, deci aceste numere nu sunt o promisiune de consum total. Ele arată doar de ce precizia numerică influențează atât de mult dimensiunea.
Eticheta „4-bit” nu este suficientă pentru o comparație serioasă. Două metode de cuantizare27 la același număr nominal de biți pot avea calitate, viteză și compatibilitate diferite.
6.3 Runtime-ul de inferență — software-ul care încarcă artefactul și execută modelul
Un runtime de inferență28 este software-ul care încarcă artefactul26 modelului, pregătește intrarea numerică, alocă memorie, execută operațiile modelului și transformă ieșirea în forma pe care aplicația o poate folosi.
În cazul unui LLM2, un runtime10 poate participa la pași precum: încărcarea ponderilor25, tokenizarea intrării, gestionarea cache-ului de atenție, executarea operațiilor pe CPU18/GPU19, alegerea tokenilor conform parametrilor de generare și decodarea lor în text. Unele detalii pot fi împărțite între biblioteci, dar responsabilitatea generală rămâne aceeași: permite executarea inferenței.
Exemple de runtime-uri10 sau motoare de inferență includ llama.cpp, ONNX Runtime, OpenVINO și execuția oferită de framework-uri. Un produs poate include intern un astfel de runtime și să ascundă complexitatea.
6.4 Serverul de model — menține modelul disponibil și îl expune altor aplicații
Un server de model29 este un proces care păstrează unul sau mai multe modele disponibile și acceptă cereri printr-o interfață, adesea HTTP. Avantajul este că aplicația agentului1 nu trebuie să implementeze singură încărcarea modelului. Ea trimite o cerere și primește un răspuns.
Produse precum Ollama sau vLLM pot îndeplini roluri de rulare și servire a modelelor, cu scopuri și niveluri de optimizare diferite. Asta nu le transformă automat în agenți1. Serverul răspunde atunci când este apelat; controllerul12 agentului decide dacă, când și de ce trebuie apelat modelul.
6.5 Inferență locală versus inferență la distanță (remote)
Când modelul rulează local, tu administrezi mai multe straturi: fișiere, memorie, runtime10, eventual driver22 și accelerator. Poți obține funcționare offline și control direct asupra datelor, dar îți asumi întreținerea și limitele hardware-ului17.
Când modelul este oferit prin API9 găzduit la distanță, furnizorul administrează hardware-ul17 și servirea modelului. Pentru aplicația ta, componenta devine o dependență de rețea: trebuie să gestionezi autentificarea, depășirile timpului de așteptare (timeout-urile), limitele, costurile și politica de date. Niciuna dintre variante nu este automat mai ieftină, mai sigură sau mai rapidă pentru orice sarcină.
Comparația de mai jos nu încearcă să declare un câștigător. Ea arată ce responsabilitate se mută și ce compromis apare. Aceeași aplicație poate chiar folosi ambele variante pentru sarcini diferite.
| Aspect | Model local | Model prin API găzduit la distanță |
|---|---|---|
| Hardware17 pentru inferență | Îl asiguri și îl întreții tu. | Este administrat de furnizor; aplicația ta are nevoie în principal de conectivitate și resurse pentru propriul cod. |
| Date trimise modelului | Pot rămâne pe infrastructura pe care o controlezi, dacă întregul traseu este local. | Părăsesc sistemul tău către serviciul ales; trebuie analizate politica, contractul și cerințele de confidențialitate. |
| Offline | Poate continua fără internet, dacă toate dependențele sunt locale. | Nu poate apela serviciul când conexiunea sau serviciul nu sunt disponibile. |
| Scalare | Trebuie să adaugi sau să optimizezi resursele proprii. | Poate fi mai simplu operațional, dar costul crește cu utilizarea și depinzi de limitele furnizorului. |
| Întreținere | Tu gestionezi runtime10, compatibilitate, actualizări și resurse. | Furnizorul gestionează servirea modelului; tu gestionezi integrarea, erorile, datele și logica agentului1. |
Regula de decizie: alegerea are sens numai după ce cunoști volumul de lucru, sensibilitatea datelor, necesarul de latență, bugetul, conectivitatea și cine poate întreține sistemul.
7. Zona V — deasupra modelului: controllerul agentului, instrumentele și datele
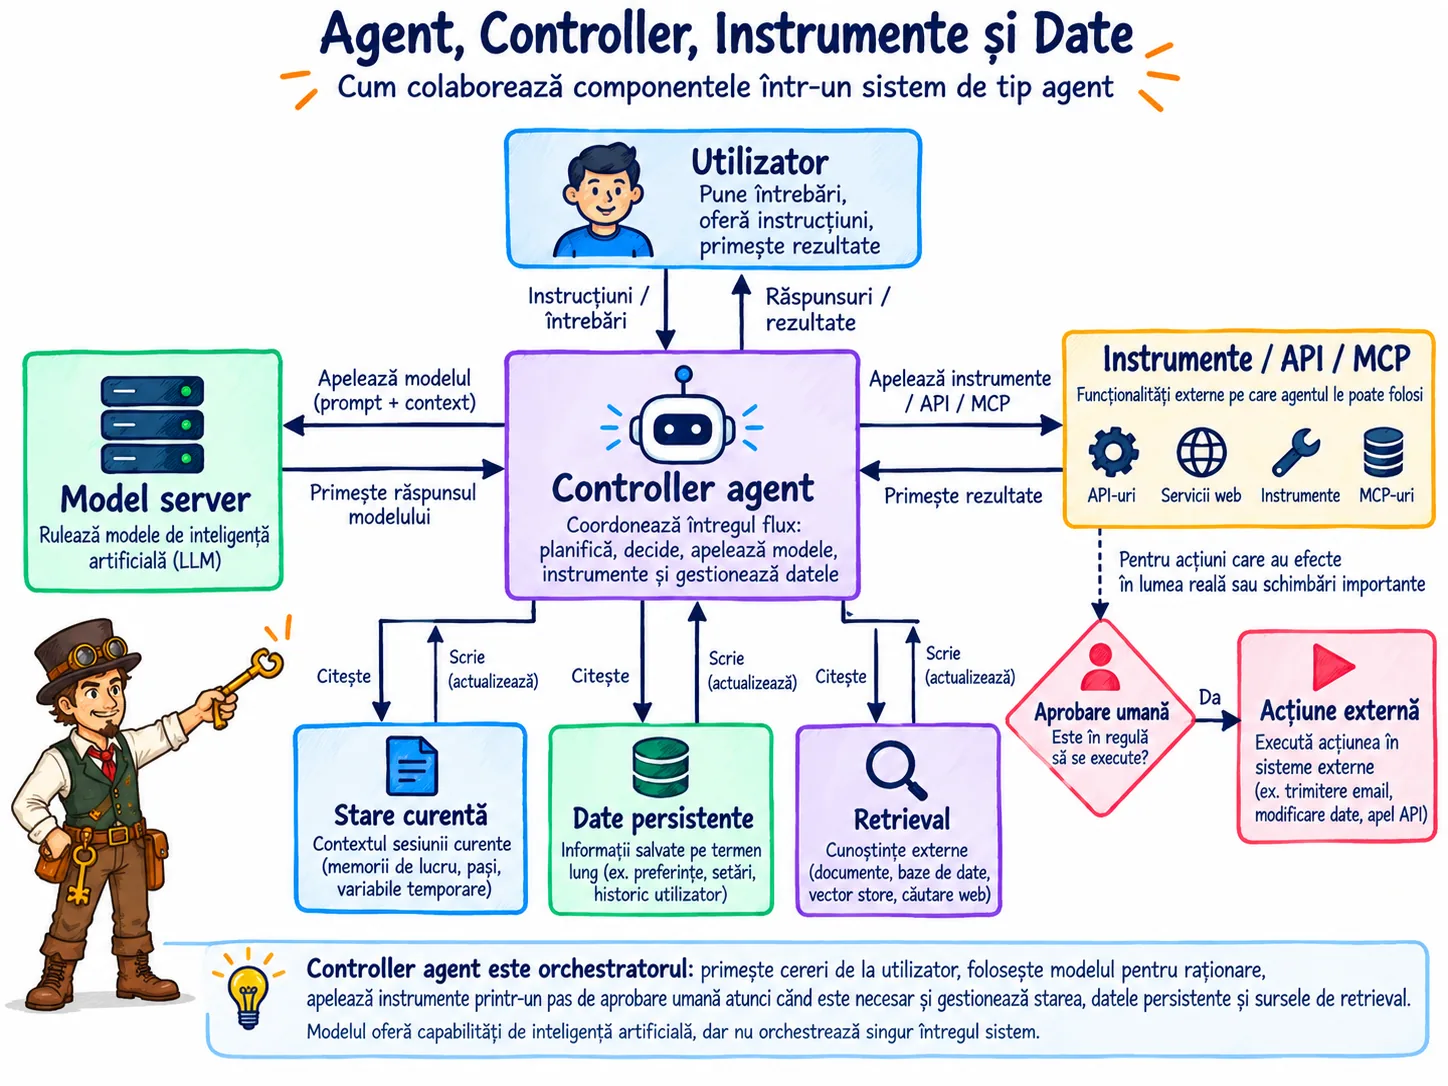
Aici legăm Lecția 3 de Lecția 2. Modelul produce ieșiri când este apelat; agentul1 este sistemul care urmărește un obiectiv, păstrează stare4, alege acțiuni și interpretează feedbackul.
7.1 Controller, orchestrator și harness — cine coordonează pașii agentului
În Lecția 2 am numit această responsabilitate componentă de control sau controller12. Aici îi vedem locul în stack: se află deasupra modelului și a instrumentelor5 și le coordonează pentru atingerea obiectivului.
Controllerul12 poate încărca obiectivul, păstra starea4, pregăti cererea către model, verifica răspunsul, selecta un instrument5, cere aprobarea unui om, înregistra rezultatul și testa condițiile de oprire. Unele sisteme fac aceste lucruri prin cod Python simplu; altele folosesc framework-uri, motoare de workflow6 sau aplicații complete.
Un controller12 poate fi determinist, cum a fost agentul1 de factură din laboratorul Lecției 2, sau poate consulta un model pentru anumite decizii. Într-o arhitectură hibridă, codul poate păstra regulile de siguranță, iar modelul poate interpreta limbajul sau propune opțiuni.
Orchestrator, harness13, runtime10 de agent1 și workflow6 engine — termeni care se pot suprapune
În industrie vei întâlni termeni precum orchestrator, agent1 runtime10, agent harness13, workflow6 engine sau framework de agenți. Nu presupune că sunt sinonime perfecte. Un produs poate coordona doar apeluri de model și instrumente5; altul poate gestiona și persistența stării4, cozi, programări, canale de mesagerie, aprobări și deployment33.
Metoda sigură este aceeași ca în întreaga lecție: înlocuiește eticheta cu o listă de responsabilități. „Ce stare4 păstrează? Ce poate executa? Cine validează? Cine reia după eroare? Unde sunt permisiunile?”
7.2 Instrumente, API-uri și MCP — cum ajunge agentul dincolo de model
Un model nu are prin el însuși acces la baza de date, calendar, fișiere sau senzori. Instrumentele5 expun capabilități precise pe care controllerul12 le poate apela. Un instrument bun are un scop îngust, intrări clare, ieșiri previzibile, erori explicite și limite de autoritate.
calculeaza_total_factura(linii)
cauta_in_manual(intrebare)
citeste_senzor(id_senzor, interval)
creeaza_draft_email(destinatar, subiect, continut)
Un API9 este o convenție prin care două componente software schimbă cereri și răspunsuri. Un instrument5 poate apela un API existent, dar instrumentul și API-ul nu sunt obligatoriu același lucru: instrumentul poate adăuga validare, limite și o interfață mai îngustă peste acel API.
MCP — Model Context Protocol este un standard deschis pentru conectarea aplicațiilor AI la capabilități externe printr-o arhitectură client–server. În ecosistemul MCP vei întâlni în special tools, resources și prompts. Pentru această lecție este suficient să îl plasezi la stratul de integrare: nu este model, nu este GPU19 și nu este definiția agentului1. Lecțiile ulterioare vor aborda protocoalele și integrările mai practic.
7.3 Date, stare, memorie și retrieval — patru probleme diferite
În produsele AI, termenul „memory” este folosit foarte larg. Pentru proiectare, este mai sigur să separăm cel puțin patru categorii.
Datele sursă sunt informațiile primite din exterior: contracte, facturi, senzori, fișiere, baze de date. Starea4 agentului1 spune unde a ajuns execuția curentă: obiectiv, pași făcuți, rezultate, aprobări, erori, condiție de oprire. Datele persistente ale aplicației trebuie să rămână disponibile și după încheierea rulării: conturi, preferințe, istorice, configurații. Retrieval-ul caută și aduce în context informațiile relevante atunci când sunt necesare.
Aceste categorii se pot stoca în aceeași bază de date, dar nu devin același lucru doar pentru că sunt stocate împreună.
Tabelul următor pornește de la întrebarea „ce anume vrem să păstrăm și pentru cât timp?”. A doua coloană explică rolul, iar a treia urmărește un singur exemplu — analiza unui contract — ca să nu rămânem la enumerări abstracte.
| Categorie | Ce înseamnă în această lecție | Exemplu: agent care analizează un contract |
|---|---|---|
| Date sursă | Informația externă pe care sistemul o primește și pe care nu trebuie să o confunde cu propriile concluzii. | Fișierul PDF încărcat de utilizator rămâne documentul original; agentul1 nu îl rescrie ca să „adauge” concluzia sa. |
| Stare4 a rulării | Informația necesară pentru ca agentul1 să știe ce a făcut și ce mai are de făcut în sarcina curentă. | Agentul1 reține că a extras textul, a găsit două clauze candidate și încă așteaptă verificarea uneia dintre ele. |
| Date persistente | Informații care trebuie să rămână disponibile după încheierea unei singure rulări. | Aplicația poate păstra contul utilizatorului și, dacă politica permite, lista documentelor încărcate și istoricul analizelor. |
| Retrieval / RAG | Mecanism care caută informația relevantă pentru întrebarea curentă și o aduce în contextul de lucru. | Pentru întrebarea despre reziliere, sistemul caută pasajele despre termen, notificare și încetarea contractului, în loc să trimită la model tot corpusul companiei. |
De ce contează separarea: politicile de încredere și retenție pot fi diferite. Documentul sursă poate fi neverificat; starea4 derivată trebuie să spună clar cine a calculat-o; datele persistente pot necesita ștergere la cerere; retrieval-ul trebuie să indice sursa informației recuperate.
Istoria conversației nu este automat memorie de încredere
Dacă salvezi fiecare mesaj la nesfârșit, nu obții automat „memorie bună”. Poți păstra greșeli, instrucțiuni temporare, date sensibile sau conținut ostil16 introdus printr-un document. O arhitectură matură decide ce poate fi păstrat, cât timp, cu ce proveniență și dacă informația trebuie verificată înainte să influențeze o acțiune viitoare.
8. Zona VI — cum ținem sistemul sub control: securitate, observabilitate, interfață și deployment
Până acum am construit drumul tehnic de la hardware17 la model și agent1. Dar un sistem real mai are nevoie de patru lucruri: să știe cine face cererea și ce are voie să facă, să poată explica ce s-a întâmplat, să ofere o interfață și să fie menținut într-un mediu de rulare concret.
8.1 Identitate, autorizare și secrete: „cine ești?” nu este aceeași întrebare cu „ce ai voie?”
Identitatea răspunde la întrebarea „cine face această cerere?”. Poate fi un utilizator, un serviciu, o aplicație sau un proces. Exemplele tehnice includ conturi de sistem de operare, conturi de serviciu, identități OAuth, certificate sau alte mecanisme de autentificare.
Autorizarea răspunde la altă întrebare: „ce are voie să facă identitatea respectivă?”. Un utilizator poate avea voie să citească facturi, dar nu să le șteargă; un agent1 poate avea voie să creeze un draft, dar nu să-l trimită; un proces poate scrie numai într-un anumit folder.
Secretele sunt informații sensibile folosite pentru autentificare sau criptografie: chei API9, parole, chei private, tokenuri de acces. Ele nu ar trebui scrise direct în cod și nici salvate în repository-ul Git. Faptul că un fișier este „ascuns” prin nume nu îl face sigur.
Guvernanța: regulile organizației care stau deasupra unei singure cereri
Guvernanța stabilește reguli precum ce clase de date pot fi procesate, cât timp sunt păstrate, ce furnizori de model sunt acceptați, ce acțiuni necesită aprobare umană, cine răspunde pentru deciziile finale și cum este gestionat un incident. Codul poate implementa o parte dintre aceste reguli, dar originea lor este organizațională și juridică, nu neuronală.
Într-un produs real, „agentul1 poate, din punct de vedere tehnic,” și „organizația permite” trebuie să fie tratate ca două condiții distincte. Autoritatea tehnică trebuie configurată astfel încât să respecte politica stabilită.
8.2 Sandbox, container și mașină virtuală: forme diferite de izolare
Un sandbox7 urmărește să limiteze ce poate accesa și modifica un proces sau codul pe care îl execută. Poate restricționa fișiere, rețea, dispozitive, procese sau credențiale.
Un container34 împachetează aplicația împreună cu fișierele și dependențele necesare și rulează procesul într-un mediu izolat la nivel de sistem de operare. Containerele sunt excelente pentru reproducibilitate și separare operațională, dar un container configurat cu privilegii largi, volume sensibile sau rețea deschisă nu devine automat un sandbox7 sigur.
O mașină virtuală poate oferi o separare mai puternică deoarece rulează propriul sistem de operare invitat deasupra unui hipervizor. Și aici configurația contează; niciun cuvânt — container34, VM, sandbox7 — nu înlocuiește analiza permisiunilor reale.
8.3 Observabilitatea: cum răspundem la „ce s-a întâmplat?” fără să ghicim
Observabilitatea31 este capacitatea de a înțelege comportamentul unui sistem din informațiile pe care acesta le emite. Pentru un agent1, observabilitatea este esențială deoarece o sarcină poate trece prin model, instrumente5, baze de date, aprobări și servicii diferite.
Nu este suficient să știm că „răspunsul final a fost greșit”. Vrem să putem reconstrui traseul: ce cerere a primit agentul1, ce instrument5 a apelat, ce rezultat a primit, dacă a existat o eroare, dacă a reîncercat și de ce s-a oprit.
Loguri
Un log este o înregistrare a unui eveniment. De exemplu: „a fost apelat instrumentul5 X”, „baza de date a răspuns cu eroare”, „sistemul a intrat în starea4 waiting_for_approval”. Logurile sunt utile pentru detalii discrete, dar o colecție mare de linii de log fără legături între ele poate fi greu de urmărit.
Metrici
O metrică32 este o măsurătoare numerică urmărită în timp: cereri pe minut, latență mediană, procent de erori, utilizare GPU19, memorie ocupată, număr de intervenții umane sau cost mediu pe sarcină. Metricile răspund bine la întrebări despre tendințe și sănătatea generală a sistemului.
Urme de execuție
O urmă de execuție (trace) leagă operațiile care aparțin aceleiași cereri sau sarcini. Dacă un utilizator trimite o întrebare și sistemul cheamă controllerul12, modelul, un instrument5 de căutare și baza de date, trace-ul le poate reuni într-o singură succesiune cronologică.
Teste și evaluări
Testele verifică de obicei comportamente deterministe: o funcție respinge date invalide; aprobarea este obligatorie înainte de o acțiune; o limită de pași oprește bucla. Evaluările măsoară calitatea componentelor probabilistice sau a rezultatului end-to-end: a ales instrumentul5 corect? răspunsul este susținut de dovezi? a îndeplinit sarcina?
Un test trecut nu dovedește că răspunsurile modelului sunt bune. O demonstrație impresionantă nu dovedește că regulile de siguranță sunt corecte. Avem nevoie de ambele.
Tabelul următor pornește de la întrebarea pe care vrem să o investigăm. Astfel vedem de ce logurile, metricile, trace-urile, testele și evaluările sunt complementare, nu cinci denumiri pentru aceeași activitate.
| Întrebarea | Instrumentul conceptual potrivit | Exemplu |
|---|---|---|
| Ce eveniment concret s-a produs? | Log | „La 10:22, agentul1 a cerut aprobarea înainte de trimitere.” |
| Cât de des sau cât de repede se întâmplă ceva? | Metrică32 | „2,8% dintre cereri au eroare; latența mediană este 1,4 secunde.” |
| Prin ce componente a trecut această cerere și în ce ordine? | Trace | „Interfață → controller12 → model → bază de date → retry → model → răspuns.” |
| Funcționează întotdeauna regula deterministă? | Test automat | „Fără aprobare, funcția de trimitere nu poate fi executată.” |
| Cât de bun este comportamentul probabilistic sau rezultatul final? | Evaluare | „Pe 100 de contracte, agentul1 identifică corect termenul relevant și îl citează în 91 de cazuri.” |
Lectura corectă: observabilitatea31 îți spune ce a făcut sistemul; testele și evaluările te ajută să judeci dacă ceea ce a făcut corespunde cerințelor. În practică, datele se pot susține reciproc: o evaluare eșuată poate fi investigată printr-un trace.
8.4 Interfața: partea vizibilă nu este întregul sistem
Interfața poate fi un terminal, o pagină web, un chat, o aplicație mobilă, voce, e-mail, un endpoint30 API9, un eveniment de la un senzor sau o sarcină programată. Ea primește obiectivul și prezintă rezultatul, dar nu ne spune singură nimic despre calitatea arhitecturii din spate.
O interfață bună arată și starea4 operațională. Utilizatorul trebuie să poată diferenția „finalizat”, „aștept informații”, „aștept aprobare”, „blocat”, „eșuat” sau „expirat”. Un spinner care se rotește la nesfârșit ascunde exact informația de care utilizatorul are nevoie.
8.5 Deployment și operațiuni: unde rulează sistemul și cine îl menține
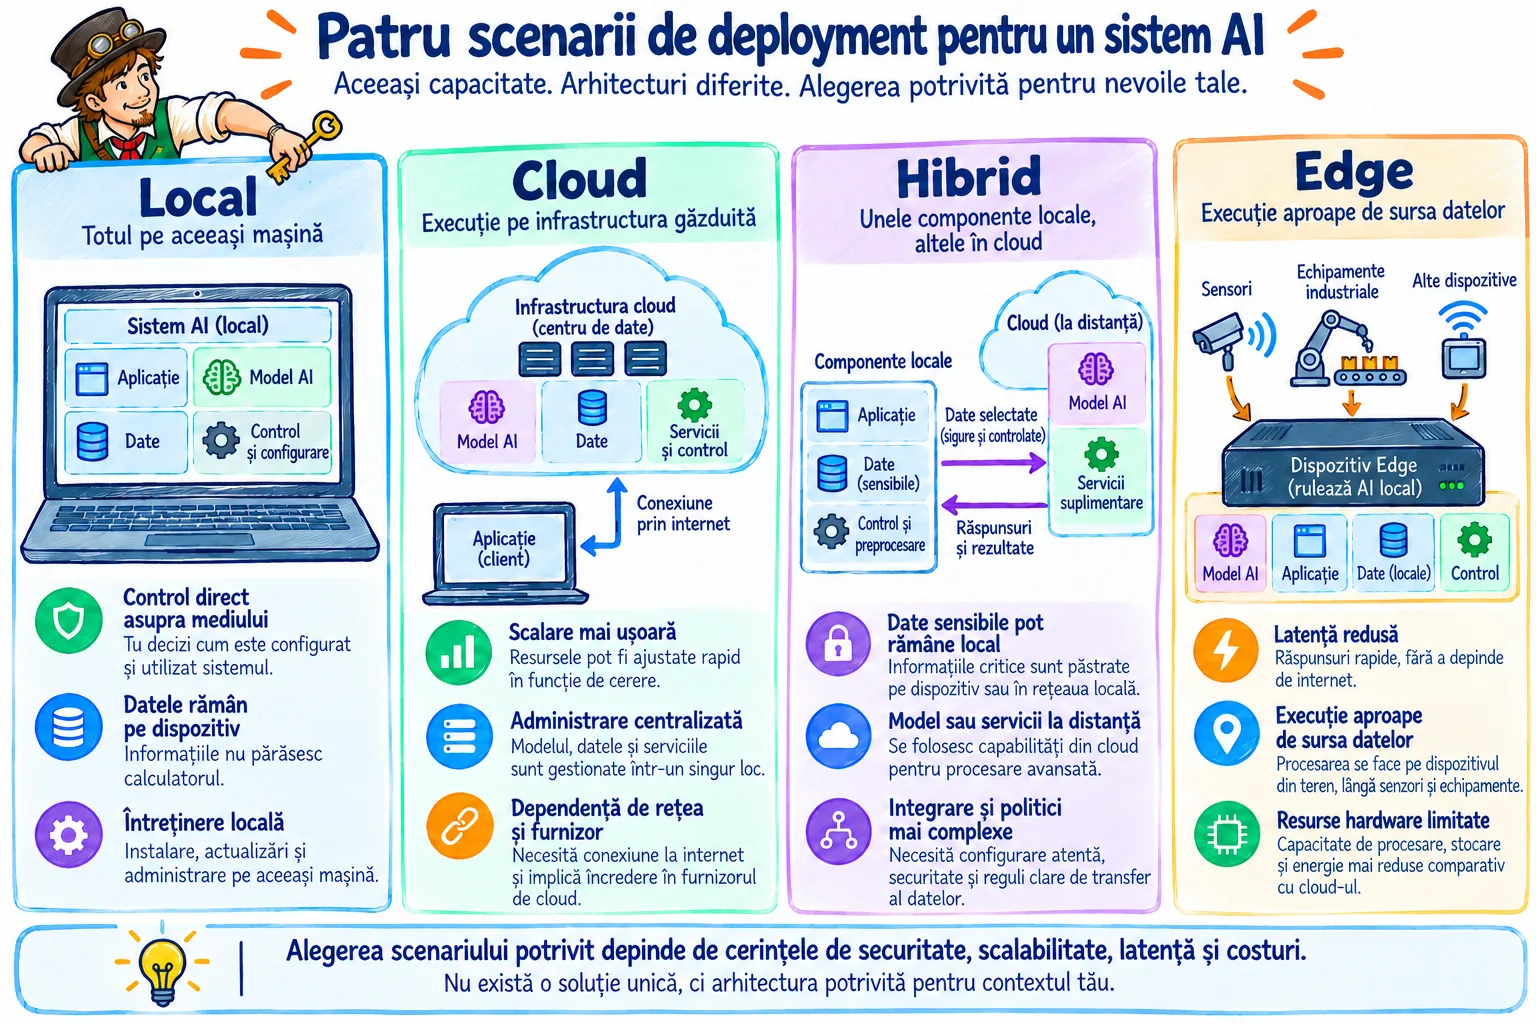
Deployment33 înseamnă aducerea aplicației într-un mediu în care poate fi utilizată și menținerea ei acolo. Același cod poate rula pe laptopul dezvoltatorului, pe un server al companiei, în cloud, într-un cluster sau pe un dispozitiv din teren.
Local
Sistemul rulează pe calculatorul utilizatorului sau în rețeaua locală. Poate oferi funcționare offline și control direct asupra fișierelor, dar utilizatorul/organizația întreține hardware17, actualizări, backup și securitate.
Cloud
Sistemul rulează pe infrastructură închiriată sau servicii gestionate. Poți obține rapid resurse mari și servicii administrate, dar apar costuri recurente, dependență de rețea, contracte de date și responsabilități de integrare.
Hibrid
Responsabilitățile sunt împărțite. De exemplu, documentele pot rămâne local, în timp ce anumite fragmente aprobate sunt trimise către un model găzduit la distanță. Sau controllerul12 poate rula în cloud, dar instrumentul5 care citește un senzor să ruleze în rețeaua fabricii. Flexibilitatea adaugă însă complexitate de rutare, sincronizare și securitate.
Edge
Edge35 înseamnă că procesarea se face aproape de locul în care apar datele sau acțiunea: fabrică, vehicul, punct de lucru, stație de pompare, cameră, gateway de senzori. Acolo pot exista constrângeri de energie, conectivitate și robustețe care nu apar pe un server dintr-un centru de date.
Un sistem edge35 poate trebui să continue când internetul cade, să consume puțină energie, să păstreze date local și să sincronizeze mai târziu. Din acest motiv, un model mai mic sau reguli deterministe pot fi mai potrivite decât un model maxim ca dimensiune.
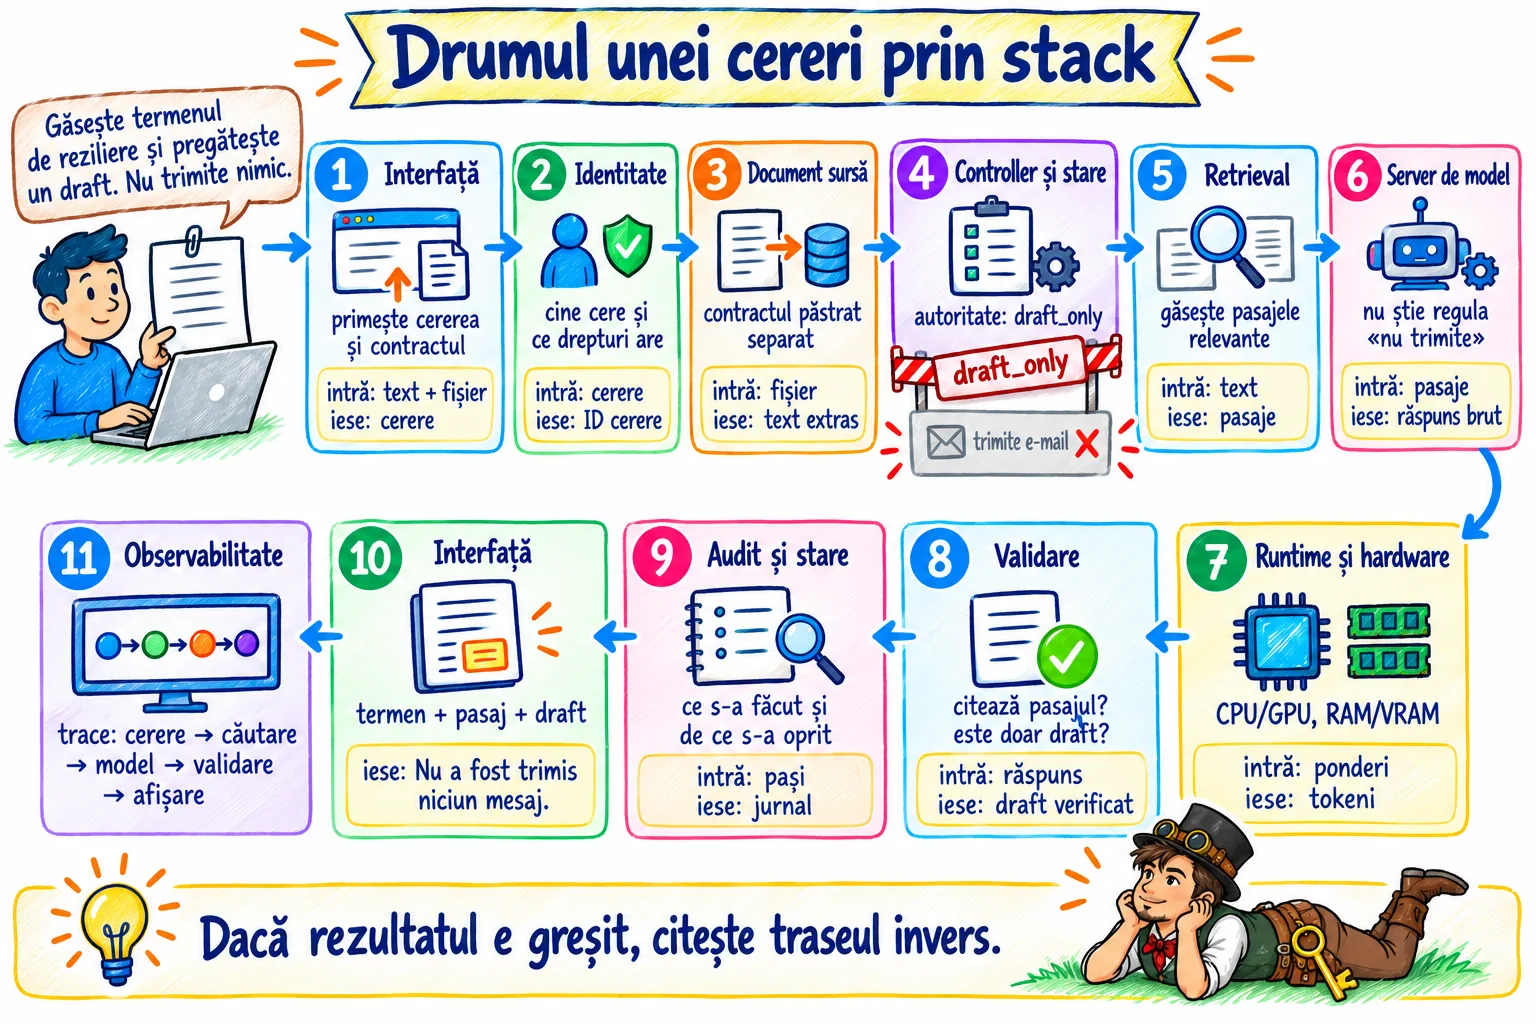
9. Exemplu complet — urmărim o singură cerere prin întregul stack
Listele de straturi devin utile abia când poți urmări un eveniment real prin ele. Vom folosi aceeași cerere de la început până la sfârșit și vom arăta, pentru fiecare etapă, cine are responsabilitatea și ce informație trece mai departe.
Scenariul este deliberat simplu. Un utilizator încarcă un contract și cere:
„Găsește termenul de reziliere din acest contract și pregătește un răspuns pentru cealaltă parte. Nu trimite nimic.”
Important: această propoziție conține deja trei lucruri diferite. Există un obiectiv — găsește termenul; o sarcină de generare — pregătește un răspuns; și o limită de autoritate — nu trimite nimic. Stack-ul trebuie să transporte și să respecte toate trei.
Pasul 1 — Interfața primește cererea și fișierul
Pagina web sau aplicația primește textul utilizatorului și contractul. În acest punct nu s-a făcut încă inferența. Interfața verifică lucruri de bază precum dimensiunea fișierului și tipul de conținut acceptat și trimite cererea către aplicație.
Ce trebuie să înțelegi: interfața este poarta de intrare. Nu este modelul și nu ar trebui să fie singurul loc unde sunt impuse regulile de securitate, deoarece cererile pot ajunge la aplicația de server (backend) și prin alte căi.
Pasul 2 — Aplicația identifică utilizatorul și creează identitatea cererii
Backend-ul verifică cine este utilizatorul, ce drepturi are și poate atribui un identificator unic cererii. Acest ID va fi util ulterior pentru a lega loguri și trace-uri.
Ce trebuie să înțelegi: înainte ca agentul1 să „gândească”, sistemul poate aplica reguli deterministe despre cine are voie să folosească funcția și ce date poate vedea.
Pasul 3 — Contractul este păstrat ca dată sursă
Fișierul original este salvat într-un loc permis. Textul poate fi extras într-o formă separată pentru analiză, dar documentul sursă rămâne distinct de notele și concluziile agentului1.
Legătura cu Lecția 2: exact cum factura nu avea voie să pretindă că totalurile au fost deja verificate, contractul nu are voie să devină automat „adevărul interpretat”. Agentul1 produce stare4 derivată separat.
Pasul 4 — Controllerul12 creează starea4 sarcinii
Controllerul12 transformă cererea într-o stare4 de lucru. O reprezentare simplificată poate arăta astfel:
{
  "obiectiv": "găsește termenul și pregătește un draft",
  "autoritate": "draft_only",
  "pasi_finalizati": [],
  "surse_gasite": [],
  "stop_reason": null
}
Valoarea draft_only este mai importantă decât pare: ea permite controllerului12 să verifice ulterior că un instrument5 de trimitere nu poate fi executat în această sarcină.
Pasul 5 — Instrumentele5 de document și retrieval găsesc pasajele relevante
Un parser extrage textul. Un mecanism de căutare poate identifica pasajele care conțin termeni precum reziliere, notificare, încetare sau termen. Dacă documentul este lung, acest pas reduce informația trimisă modelului la fragmentele relevante.
Ce trebuie să înțelegi: modelul nu trebuie să fie baza de date. Instrumentele5 pot furniza informație exactă și citabilă, iar modelul o poate interpreta.
Pasul 6 — Controllerul12 cheamă serverul de model29
Controllerul12 pregătește o cerere care conține instrucțiunea și pasajele relevante. Dacă modelul este local, cererea poate merge către un server de model29 de pe aceeași mașină. Dacă este găzduit la distanță, traversează rețeaua către furnizor.
Serverul de model29 nu știe automat politica de business „nu trimite”. El primește date și produce o ieșire conform interfeței sale. Autoritatea operațională rămâne la aplicație/controller12.
Pasul 7 — Sub API9, runtime-ul10 încarcă/execută modelul pe hardware17
La nivelul inferior, runtime-ul10 transformă intrarea în forma necesară modelului, folosește artefactul26 și execută operațiile pe CPU18/GPU19 prin stack-ul software compatibil. Dacă modelul este deja încărcat, ponderile25 pot rămâne în memorie între cereri.
Acesta este punctul în care straturile „invizibile” utilizatorului devin active: driver22, biblioteci de accelerare, RAM/VRAM20, CPU18/GPU19 și stocare.
Pasul 8 — Ieșirea modelului este validată înainte de a deveni rezultat
Codul poate verifica dacă răspunsul citează pasajul identificat, dacă a păstrat distincția dintre fapt și interpretare și dacă rezultatul este un draft, nu o afirmație falsă că mesajul a fost trimis.
Dacă modelul generează un format invalid, controllerul12 poate cere o corectare, poate aplica un parser sau poate opri sarcina în loc să execute o acțiune bazată pe date greșite.
Pasul 9 — Starea4 și auditul păstrează ceea ce trebuie reconstruit
Sistemul poate înregistra pasajele recuperate, versiunea modelului, versiunea promptului, rezultatele instrumentelor5, starea4 finală și motivul opririi. Nu este necesar și nici sigur să copieze întregul contract confidențial în fiecare linie de log.
Pasul 10 — Utilizatorul vede rezultatul și limita de autoritate
Interfața afișează termenul identificat, pasajul care îl susține și draftul de răspuns. Trebuie să existe și un mesaj clar: „Nu a fost trimis niciun mesaj.”
Astfel, interfața nu oferă doar conținut; comunică și starea4 operațională.
Pasul 11 — Observabilitatea31 leagă traseul
Dacă utilizatorul semnalează o problemă, trace-ul poate arăta: cerere primită → document extras → căutare executată → model apelat → validare → rezultat afișat. Dacă pasul de căutare a selectat clauza greșită, nu mai trebuie să presupunem că „LLM-ul2 a halucinat”; vedem unde a apărut eroarea.
Acum citește traseul invers. Dacă rezultatul final este greșit, nu începe automat cu presupunerea că modelul a greșit. Întreabă, în ordine inversă: interfața a afișat corect starea4? validarea a acceptat ceva ce trebuia respins? modelul a primit pasajele potrivite? retrieval-ul a găsit sursa corectă? documentul a fost extras corect? Această lectură inversă transformă harta stack-ului într-o metodă de diagnostic.
10. Cinci profiluri de stack care pot fi toate corecte
Nu există o combinație universală de produse. Același obiectiv general poate fi implementat cu stack-uri foarte diferite, în funcție de volum, date, conectivitate, buget și cine operează sistemul.
Profil 1 — Agent1 determinist local
laptop existent
→ Ubuntu/Kubuntu
→ Python + mediu virtual
→ controller determinist
→ instrumente locale
→ stare JSON
→ CLI
→ teste + trace JSONL
Acesta seamănă cu agentul1 din laboratorul Lecției 2. Nu are nevoie de LLM2. Este un stack valid pentru o problemă în care regulile pot fi scrise explicit.
Profil 2 — Agent1 local asistat de model
stație de lucru (workstation) cu CPU/GPU
→ Linux + driver compatibil
→ runtime / server de model local
→ artefact model descărcat
→ controller Python
→ instrumente locale
→ SQLite/PostgreSQL
→ interfață locală
→ loguri + evaluări
Aici organizația operează aproape toate straturile. Avantajul poate fi controlul și funcționarea offline; costul este întreținerea hardware17 și software.
Profil 3 — Prototip cu model găzduit prin API9
laptop de dezvoltare
→ aplicație server în Python/TypeScript
→ controller de agent
→ API către un model găzduit
→ bază de date gestionată
→ stocare de fișiere
→ aplicație web
→ loguri și metrici cloud
Echipa nu operează hardware-ul17 modelului, dar rămâne responsabilă pentru integrare, date, instrumente5, permisiuni, evaluare și experiența utilizatorului.
Profil 4 — Sistem privat on-premise
server dedicat cu GPU
→ Linux + drivere validate
→ server privat de model
→ identitate internă
→ controller + instrumente restricționate
→ baze de date private
→ loguri de audit
→ aprobare umană
Acest profil poate fi ales când există cerințe de date, conectivitate sau control operațional care justifică infrastructura proprie.
Profil 5 — Servire de modele la volum mare
cluster de acceleratoare
→ orchestrare containere
→ servere de inferență
→ gruparea cererilor în loturi (batching) și rutarea lor
→ ajustarea automată a capacității (autoscaling)
→ stocare distribuită
→ telemetrie și alerte
→ planificare de capacitate
Aici problema nu mai este numai „AI”. Este și o problemă serioasă de infrastructură distribuită, capacitate, cost și operare.
Tabelul următor nu spune că un profil este „mai matur” decât altul. El arată pentru ce condiții este rezonabil fiecare. Ultima coloană este importantă: spune ce cost operațional accepți în schimbul avantajului.
| Profil | Când are sens | Ce responsabilitate accepți |
|---|---|---|
| Determinist local | Problema poate fi rezolvată prin reguli și date locale; vrei transparență și cost mic. | Întreții aplicația și mediul local, dar nu un model. |
| Model local | Ai nevoie de model, datele trebuie să rămână local sau ai nevoie de funcționare offline. | Întreții modelul, runtime-ul10, compatibilitatea și hardware-ul17. |
| API9 găzduit | Vrei acces rapid la capabilități fără infrastructură proprie de inferență. | Întreții integrarea și politica de date și accepți dependența de furnizor/rețea. |
| On-premise privat | Ai cerințe organizaționale de control, integrare internă sau date sensibile. | Organizația devine operator pentru o parte mare din stack. |
| Servire la scară mare | Ai trafic mare și trebuie optimizate debitul de procesare (throughput), latența și utilizarea acceleratoarelor. | Accepți complexitate de infrastructură distribuită și observabilitate31 avansată. |
Ideea de proiectare: începe de la sarcină și constrângeri, nu de la profilul care pare mai impresionant. Un agent1 determinist de 200 de linii poate fi arhitectura corectă pentru o problemă; un cluster GPU19 poate fi risipă.
11. Compatibilitatea este o proprietate a sistemului, nu a unei singure componente
Multe erori de instalare apar atunci când fiecare componentă pare corect configurată atunci când este verificată separat, dar combinația de versiuni și hardware17 nu este suportată.
Compatibilitatea poate depinde simultan de sistem de operare, kernel21, arhitectura CPU18, modelul exact al GPU19-ului, driver22, versiunea platformei de accelerare23, versiunea Python, varianta compilată (build) a framework-ului, arhitectura modelului, formatul artefactului26 și runtime-ul10 ales.
De aceea o frază precum „am eroare CUDA23” este prea vagă. Pentru diagnostic avem nevoie de contextul complet.
Sistem de operare: versiunea exactă
Kernel: versiunea exactă
Arhitectură CPU: x86_64 / ARM64 / alta
GPU: modelul exact
Driver: versiunea exactă
Python: versiunea exactă
Framework/runtime: versiunea exactă
Artefact model: repository + revizie/fișier
Comanda: comanda exactă
Eroarea: mesajul complet
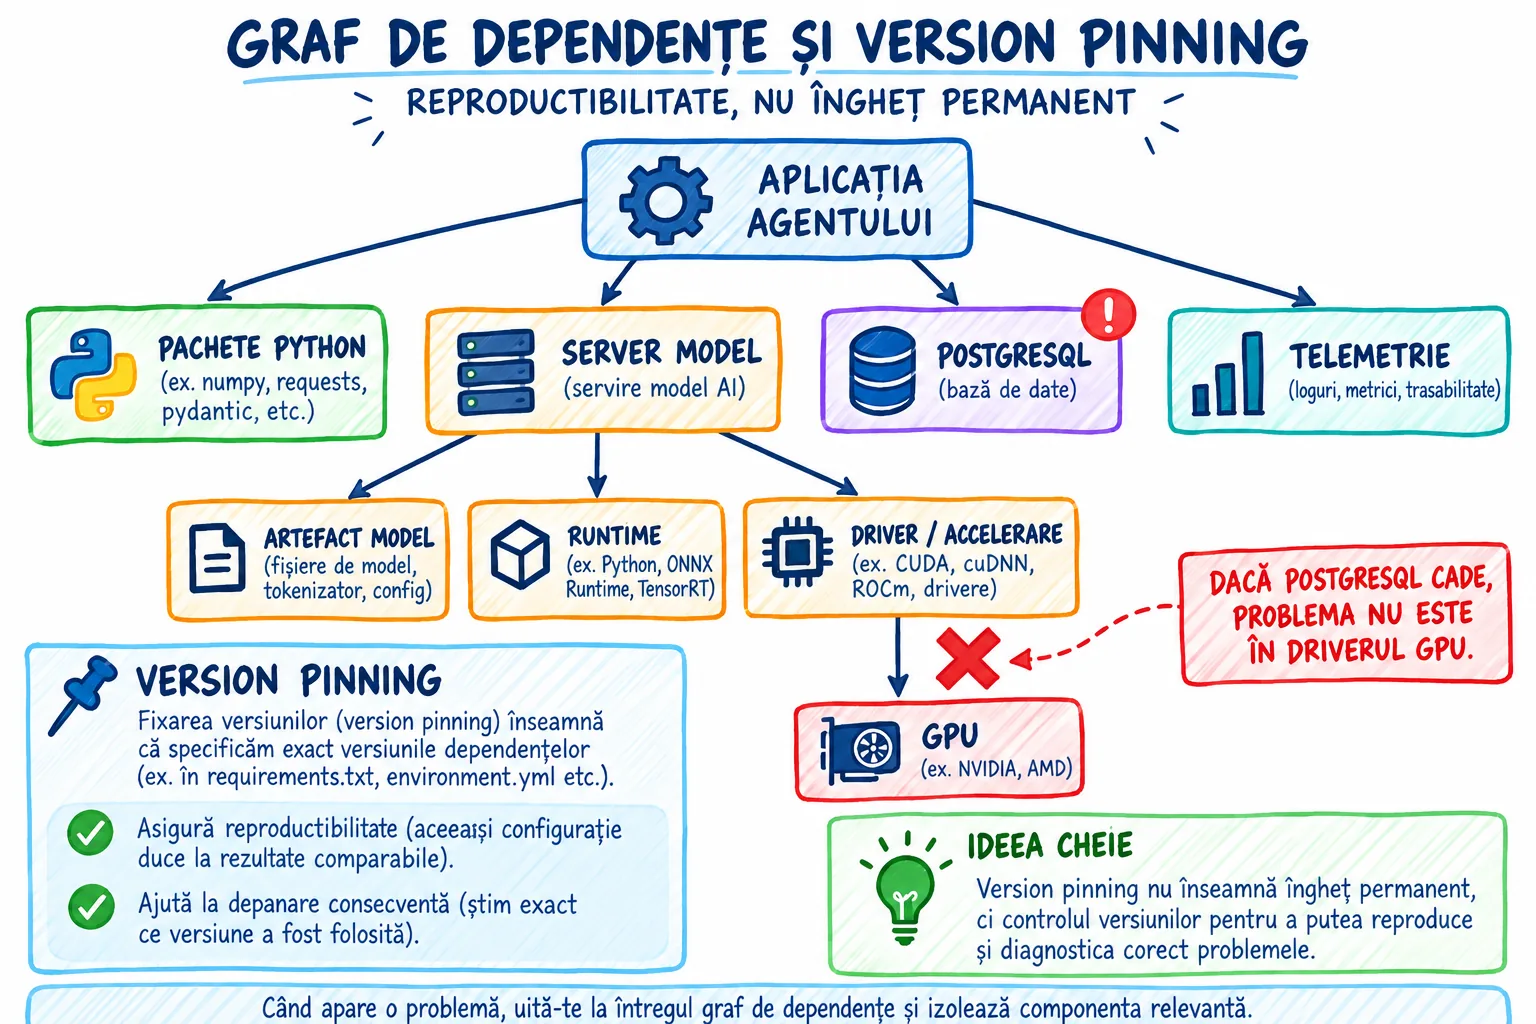
11.1 Graful de dependențe: relațiile sunt mai importante decât lista
O listă de tehnologii spune ce există; un graf de dependențe arată cine depinde de cine. Pentru depanare, a doua reprezentare este mult mai utilă.
Aplicația agentului
├── depinde de pachete Python
├── apelează API-ul serverului de model
├── apelează PostgreSQL
└── scrie telemetrie

Serverul de model
├── încarcă artefactul modelului
├── depinde de runtime/biblioteci
└── poate depinde de driver + platformă GPU
Dacă baza de date cade, nu are sens să reinstalezi driverul22 GPU19. Graful te ajută să limitezi zona de căutare.
11.2 Version pinning: reproducibilitate, nu îngheț permanent
Version pinning36 înseamnă să înregistrezi versiuni exacte sau intervale permise pentru dependențe. Acest lucru face proiectul mai reproductibil: altă persoană poate reconstrui un mediu asemănător celui testat.
Versiunile fixate nu trebuie însă uitate pentru totdeauna. Apar actualizări de securitate și compatibilitate. Pinning36-ul reduce variația necontrolată; nu elimină nevoia unui proces de actualizare.
12. Ce trebuie să existe și ce poate fi administrat de altcineva
Un serviciu gestionat poate ascunde un strat din vedere, dar nu poate șterge responsabilitatea arhitecturală. În această secțiune separăm „trebuie să existe undeva” de „trebuie să îl operez eu”.
Fiecare rând răspunde la două întrebări: responsabilitatea este necesară pentru tipul respectiv de sistem și, dacă da, poate fi delegată operațional unui furnizor? Ultima coloană arată ce responsabilitate rămâne totuși la echipa care construiește produsul.
| Responsabilitate | Trebuie să existe? | Poate fi administrată de altcineva? | Ce rămâne responsabilitatea ta |
|---|---|---|---|
| Calcul fizic | Da, pentru orice software. | Da — cloud sau serviciu găzduit. | Să alegi nivelul de serviciu, costul și riscurile potrivite aplicației. |
| Sistem de operare | Da, undeva sub aplicație. | Da — poate fi complet ascuns de servicii gestionate. | Să înțelegi limitele serviciului și contractul operațional. |
| Execuția modelului | Numai dacă sistemul folosește un model. | Da. | Să verifici modelul/serviciul ales și modul în care datele sunt procesate. |
| Controlul agentului1 | Da, dacă vorbim despre un agent1. | Poate fi oferit parțial de o platformă. | Obiectivul, limitele de autoritate și criteriile de succes nu pot fi externalizate conceptual. |
| Autorizarea instrumentelor5 | Da, dacă există instrumente5 cu efect. | Mecanismele pot fi furnizate de platformă. | Tu stabilești ce acțiuni sunt acceptabile pentru produsul tău. |
| Politica datelor | Da. | Stocarea poate fi gestionată. | Clasificarea datelor, retenția și scopul folosirii rămân decizii ale organizației. |
| Observabilitate31 | Necesară practic pentru producție. | Da — colectare și dashboard-uri gestionate. | Trebuie să definești ce semnale contează și ce date nu trebuie logate. |
| Interfață | Trebuie să existe o cale de intrare/ieșire, nu neapărat grafică. | Poate fi oferită de alt produs. | Trebuie să comunici corect starea4 și limitele sistemului. |
Concluzia: externalizarea schimbă cine operează stratul. Nu elimină nevoia de cerințe, limite, contracte, permisiuni și planuri pentru eșec.
13. Greșeli frecvente când citim un stack AI
Cele mai multe confuzii nu vin din lipsă de inteligență, ci din folosirea unui singur cuvânt pentru obiecte aflate pe straturi diferite. În fiecare exemplu de mai jos corectăm nu doar termenul, ci și întrebarea pe care trebuie să o pui.
Fiecare card pornește de la o propoziție pe care o spune des cineva care învață. Citește-o, încearcă să vezi singur problema, apoi citește explicația.
13.1 Confuzii între model, artefact, runtime și agent
Ce spune cineva: „Modelul este agentul1”
De ce este greșit: Un model poate genera text sau alege între opțiuni atunci când este apelat. Un agent1 are nevoie, în plus, de control al pașilor, stare4, instrumente5, limite și condiții de oprire. Unele produse împachetează toate aceste elemente și le prezintă utilizatorului ca o singură experiență; arhitectural, responsabilitățile rămân distincte.
Ce se întâmplă de fapt: un agent1 funcționează complet fără ca vreun model să fie apelat. Comanda următoare, rulată în proiectul laboratorului 2 pe Ubuntu 24.04, pornește un agent determinist care calculează, pregătește pachetul și se oprește la verificarea umană — fără nicio cerere către vreun model:
./src/lesson02_invoice_agent.py --input data/inbox/invoice_complete.json --trace-file logs/lesson02/complete.jsonl | jq '{status, actions_taken}'
{
  "status": "waiting_for_review",
  "actions_taken": [
    "calculate_totals",
    "prepare_review_package",
    "wait_for_human_review"
  ]
}
Întrebarea corectă și cum afli răspunsul: Ce componentă menține starea4, alege pașii, aplică limitele și autorizează instrumentele5 dincolo de model?
Ce spune cineva: „Am fișierul GGUF, deci am modelul instalat și funcțional”
De ce este greșit: Fișierul este un artefact26. Mai ai nevoie de software compatibil care să îl încarce și să execute inferența, plus resursele hardware17 necesare. Formatul nu este un runtime10.
Ce se întâmplă de fapt: artefactul26 rămâne un fișier inert până când un runtime10 compatibil îl încarcă; în laboratoarele următoare vei vedea exact pasul în care runtime-ul citește fișierul și abia apoi apare vreun răspuns. Nu există o comandă „instalează GGUF și pornește” — există întotdeauna un program separat care face execuția.
Întrebarea corectă și cum afli răspunsul: Ce runtime10 compatibil va încărca artefactul26 și pe ce hardware17 va rula?
Ce spune cineva: „Ollama este modelul”
De ce este greșit: Ollama este software care poate descărca, rula și servi diferite modele. Numele modelului și numele aplicației care îl rulează trebuie separate. Altfel, nu mai poți compara corect modele între ele sau runtime-uri10 între ele.
Ce se întâmplă de fapt: același server poate rula oricâte modele; numele aplicației nu spune nimic despre ponderile25 încărcate acum. Verificarea se face din lista modelelor serverului și din metadatele artefactului26, nu din numele programului.
Întrebarea corectă și cum afli răspunsul: Ce model rulează Ollama și ce artefact26 și runtime10 sunt implicate?
13.2 Confuzii de infrastructură și securitate
Ce spune cineva: „Orice AI are nevoie de CUDA23”
De ce este greșit: CUDA23 aparține ecosistemului NVIDIA. Poți avea agenți1 fără model, modele executate pe CPU18, căi AMD/Intel/Apple sau modele găzduite la distanță.
Ce se întâmplă de fapt: același agent1 din laboratorul 2 rulează pe CPU18, fără niciun pachet CUDA23 instalat. Comanda din primul card — rulată pe Ubuntu 24.04 pe un calculator cu plăci Intel și AMD, vizibile cu lspci | grep -i vga — s-a terminat corect, cu starea4 waiting_for_review, fără accelerare NVIDIA.
Întrebarea corectă și cum afli răspunsul: Ce hardware17 execută sarcina și ce stack de software este compatibil cu acel hardware?
Ce spune cineva: „Instalez tot stack-ul GPU19 și după aceea văd dacă există suport oficial pentru placă”
De ce este greșit: Ordinea corectă este inversă: identifici hardware-ul17, sistemul de operare și versiunile, verifici matricea de compatibilitate și abia apoi instalezi componentele necesare. Altfel poți petrece ore depanând o combinație nesuportată.
Ce se întâmplă de fapt: identificarea hardware-ului17 este o comandă de câteva secunde, înaintea oricărei instalări. Ieșire reală pe Ubuntu 24.04:
lspci | grep -i -E "vga|nvidia|3d"
00:02.0 VGA compatible controller: Intel Corporation Crystal Well Integrated Graphics Controller (rev 08)
01:00.0 VGA compatible controller: Advanced Micro Devices, Inc. [AMD/ATI] Venus XT [Radeon HD 8870M / R9 M270X/M370X] (rev 83)
Comanda lspci listează dispozitivele PCI; grep păstrează numai rândurile despre plăci grafice. Iată cu ce hardware17 se verifică matricea de compatibilitate — nu după ce ai instalat orbește un stack.
Întrebarea corectă și cum afli răspunsul: Ce GPU19, sistem de operare, driver22 și versiuni sunt suportate oficial înainte să instalez?
Ce spune cineva: „Este doar un prototip; pun cheia API9 direct în cod”
De ce este greșit: Repository-urile sunt copiate, sincronizate, arhivate și uneori publicate accidental. Un secret scris în istoria Git poate rămâne recuperabil chiar dacă îl ștergi din ultima versiune. Secretele trebuie gestionate separat.
Ce se întâmplă de fapt: ștergerea fișierului nu șterge istoria. Demonstrație reală: un commit introduce o cheie, al doilea o scoate, iar istoria o arată în continuare:
git log -p -- app.py | grep "API_KEY"
-API_KEY="sk-demo-1234"
+API_KEY="sk-demo-1234"
Liniile cu minus arată ce a fost scos, dar rămân în istorie, recuperabile cu git show pe commit-ul vechi.
Întrebarea corectă și cum afli răspunsul: Cum furnizez secretul aplicației fără să intre în cod sau în istoria Git?
Ce spune cineva: „Ca să putem depana, logăm absolut tot”
De ce este greșit: Un log poate deveni o scurgere de date. Contracte, date personale, chei API9, prompturi3 interne și rezultate confidențiale nu trebuie copiate fără discernământ. Observabilitatea31 bună înseamnă suficiente dovezi pentru diagnostic, nu duplicarea întregului sistem în text.
Ce se întâmplă de fapt: jurnalul bun înregistrează pași și rezultate, nu conținut integral. Comanda următoare, rulată pe trace-ul laboratorului 2, arată forma utilă: fiecare pas cu acțiunea și starea4, fără textul facturii și fără date personale:
jq '{step, action: .selected_action, status: .status_after_action}' logs/lesson02/complete.jsonl
{
  "step": 1,
  "action": "calculate_totals",
  "status": "running"
}
{
  "step": 2,
  "action": "prepare_review_package",
  "status": "running"
}
{
  "step": 3,
  "action": "wait_for_human_review",
  "status": "waiting_for_review"
}
Întrebarea corectă și cum afli răspunsul: Ce dovezi sunt necesare pentru diagnostic și ce date trebuie excluse, reduse sau redactate?
Ce spune cineva: „Este în container34, deci este sigur”
De ce este greșit: Un container34 poate avea acces la rețea, fișiere montate, dispozitive și privilegii. Securitatea include identitate, autorizare, secrete, politici de rețea, actualizări și uneori izolare mai puternică.
Ce se întâmplă de fapt: diferența nu stă în tehnologie, ci în parametri: același container34 rulează fără rețea și cu un singur dosar montat — aproape un sandbox7 — sau cu drepturi de administrator și acces la socket-ul Docker, care este o poartă către tot sistemul. Verificarea se face din configurație: ce rețele, volume, dispozitive și privilegii au fost acordate.
Întrebarea corectă și cum afli răspunsul: Ce permisiuni, volume montate, rețele, secrete și privilegii are containerul34 în realitate?
13.3 Confuzii de proiectare și alegerea produselor
Ce spune cineva: „Alegem întâi produsele și apoi vedem ce construim cu ele”
De ce este greșit: Stack-ul depinde de sarcină: tipul datelor, numărul utilizatorilor, latență, buget, sensibilitate, conectivitate și competența echipei. Produsele alese prea devreme pot crea cost și complexitate fără valoare.
Ce se întâmplă de fapt: produsul ales înainte de cerințe dictează înapoi cerințele: datele trebuie „să intre” în formatul lui, limitele lui devin limitele agentului1, iar refactorul costă de fiecare dată când cerința reală apare. Fișa din secțiunea 15 există tocmai pentru ca ordinea să fie inversă.
Întrebarea corectă și cum afli răspunsul: Care sunt sarcina, volumul, sensibilitatea datelor, latența, conectivitatea și bugetul înainte să aleg produsele?
Ce spune cineva: „Orice agent1 are nevoie de vector database”
De ce este greșit: Nu. Dacă datele sunt mici, structurate sau pot fi interogate exact, o căutare simplă, SQL sau indexare clasică poate fi mai bună. Alegi retrieval-ul și stocarea după problemă, nu după popularitatea tehnologiei.
Ce se întâmplă de fapt: pentru date mici și structurate, o căutare exactă rezolvă problema într-o linie de shell. Comandă reală, rulată pe datele laboratorului 2:
grep -r -o '"customer": {[^}]*}' data/inbox/ | head -2
data/inbox/invoice_untrusted_totals.json:"customer": {"name": "Demo Client SRL", "tax_id": "RO87654321"}
data/inbox/invoice_approved.json:"customer": {"name": "Demo Client SRL", "tax_id": "RO87654321"}
Căutarea exactă după câmp a găsit răspunsul instant, fără index vectorial; grep caută text după tipar, iar -r parcurge folderele recursiv.
Întrebarea corectă și cum afli răspunsul: Ce tip de căutare cere problema și care este cea mai simplă soluție care o rezolvă fiabil?
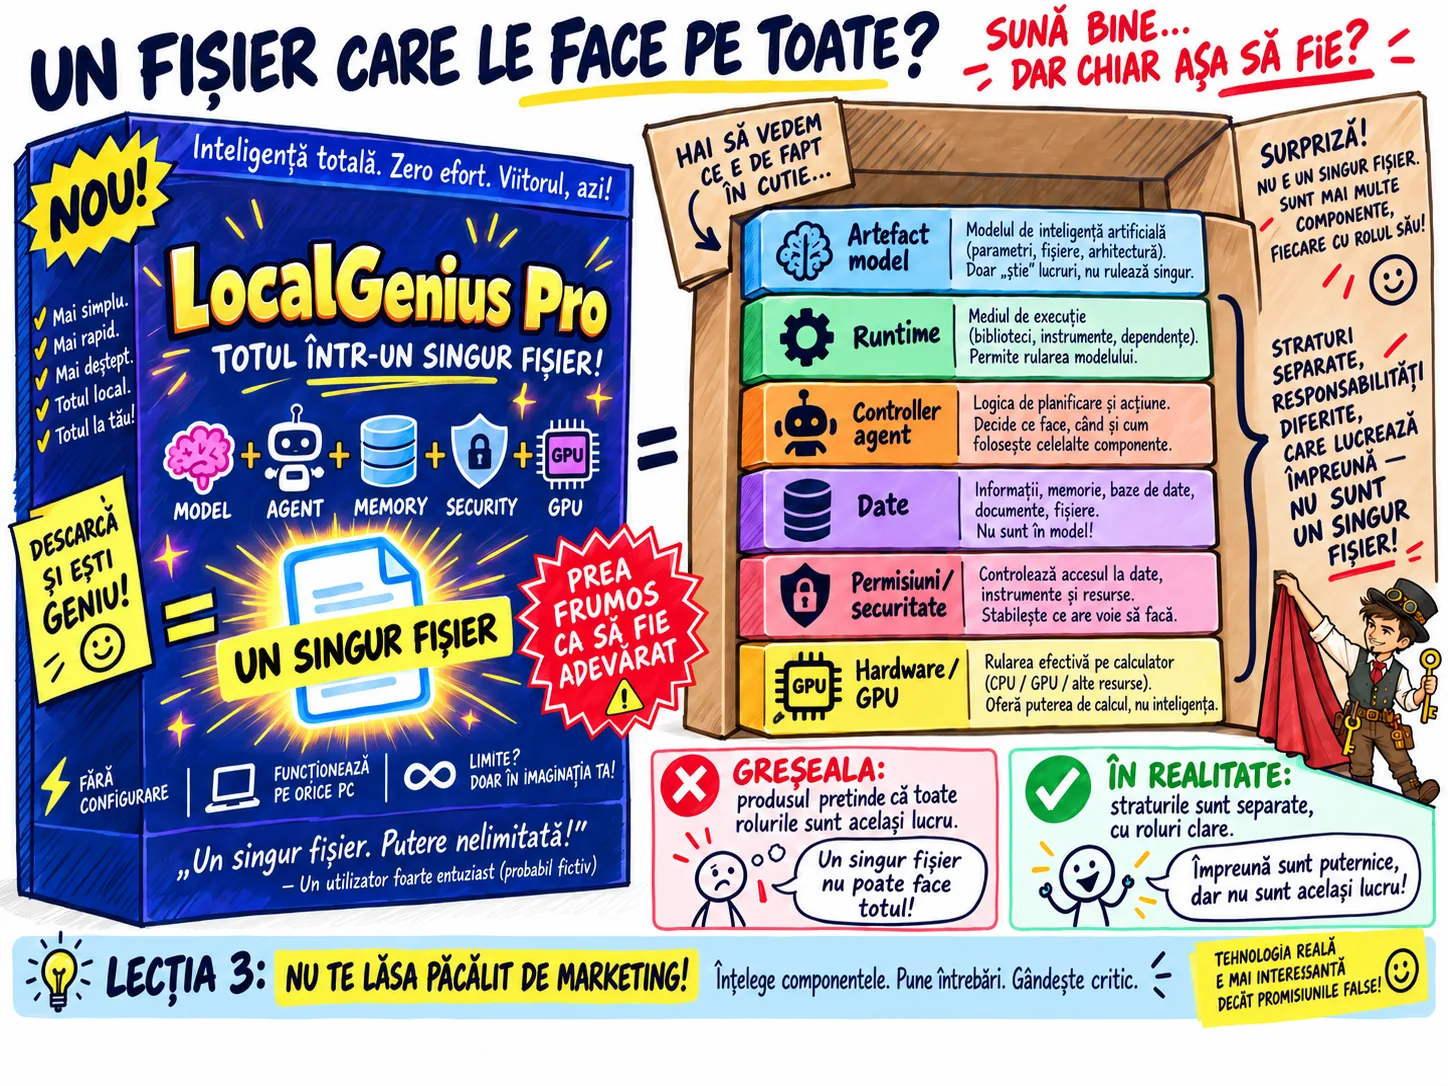
14. Găsește greșeala — reclama „LocalGenius Pro face totul”
Exercițiul următor folosește același model ca în Lecțiile 1–2: citim o afirmație de marketing propoziție cu propoziție și verificăm ce strat este descris corect și unde sunt amestecate responsabilități.
Cheia instructorului
1. „Instalează fișierul nostru GGUF de 8 GB și primești imediat un agent1 AI complet autonom și privat.”
Problema începe din primul enunț. GGUF este un format de artefact26 — adică formatul de fișier în care se distribuie un model gata antrenat — iar fișierul nu se execută singur. Mai este necesar un runtime10 compatibil — programul care execută efectiv modelul, explicat în Lecția 1. În plus, un model care poate genera text nu devine agent1 numai pentru că este local: agentul are nevoie de controller12 — componenta care coordonează bucla — de stare4, instrumente5 și o condiție de oprire. „Autonom” mai adaugă și o afirmație despre autoritate, care nu poate fi dedusă din formatul fișierului.
Cuvântul „privat” este și el prea larg. Faptul că un fișier se află local poate reduce transferul de date către un furnizor, dar aplicația poate avea în continuare acces la internet, loguri, instrumente5 externe sau alte procese. Confidențialitatea este proprietatea întregului traseu.
2. „GGUF include modelul, runtime-ul10 agentului1, memoria, securitatea instrumentelor5 și accelerarea GPU19.”
Aici sunt comprimate cinci straturi diferite. Un artefact26 GGUF poate conține ponderi25 și metadate pentru model. Runtime-ul10 este software separat. Memoria agentului1 este o problemă de stare4/date. Securitatea instrumentelor5 ține de autorizare și controller12. Accelerarea GPU19 depinde de hardware17, driver22, runtime și varianta software compatibilă. Un singur format de fișier nu poate înlocui aceste responsabilități.
3. „Deoarece fișierul este local, nu mai ai nevoie de sandbox7, sistem de aprobare, loguri sau analiză de securitate.”
Localitatea modelului nu reduce automat autoritatea agentului1. Un proces local cu drepturi suficiente poate șterge fișiere, poate citi secrete sau poate trimite date în rețea. Cu cât instrumentele5 au efecte mai mari, cu atât limitele și auditul rămân importante, indiferent unde rulează modelul.
4. „Pentru funcționare trebuie instalat CUDA23, indiferent ce calculator folosești.”
Fals. CUDA23 este o cale specifică ecosistemului NVIDIA compatibil. Un sistem poate rula numai pe CPU18 (CPU-only), pe AMD/ROCm — ecosistemul echivalent al lui AMD — pe alte acceleratoare sau poate folosi un API9 găzduit la distanță. Hardware-ul17 și software-ul concret stabilesc stack-ul de accelerare.
O descriere mai corectă ar suna astfel: „Produsul oferă un artefact26 de model în format GGUF. Pentru a-l folosi ai nevoie de un runtime10 compatibil și de resurse hardware17 suficiente. Dacă aplicația îl integrează într-un agent1, controllerul12, instrumentele5, starea4, permisiunile și observabilitatea31 trebuie definite separat.”
Concluzie. Reclama comprimă cinci responsabilități separate — artefactul26 de model, runtime-ul10, starea4, autorizarea și accelerarea — într-un singur fișier, și tratează localitatea ca înlocuitor pentru control. Lecția arată exact opusul: fiecare strat din stiva AI este o componentă distinctă, iar mecanismele de siguranță depind de ce are voie să facă sistemul, nu de unde rulează modelul.
15. De la hartă la proiectare: descrie stack-ul înainte să alegi produsele
Acum folosim harta pentru o sarcină practică: descriem ce are nevoie sistemul înainte de a decide ce produse cumpărăm sau instalăm. Este acceptabil ca unele răspunsuri să fie „nu este ales încă”.
Fișa de proiectare a stack-ului
Pentru un agent1 pe care vrei să-l construiești, răspunde pe rând. Fiecare întrebare elimină alegeri nepotrivite mai târziu.
Întrebarea: SCOPUL SISTEMULUI — cine îl folosește și ce rezultat concret trebuie să obțină?
De ce contează: Fără utilizator numit și rezultat măsurabil, fiecare decizie următoare — model, instrumente5, limite — devine arbitrară. Acest câmp este cel care decide dacă o tehnologie este potrivită, nu listele de funcții.
Cum afli răspunsul: Îl stabilești cu utilizatorul și îl scrii în fișa proiectului (de pildă docs/agent-profile.md); nu există comandă care să îl dea — există conversația cu omul pentru care construiești.
Un răspuns bun și unul slab: Bun: „contabilii firmei; facturile pregătite pentru plată în maximum 10 minute.” Slab: „utilizatori de AI” — fără rezultat numit, nimic nu poate fi testat.
Întrebarea: VOLUMUL DE LUCRU — text, imagini, audio, video, senzori, simulare sau combinație?
De ce contează: Tipul și cantitatea datelor decid hardware-ul17, cuantizarea27, alegerea între local și găzduit și costul pe rulare. Același model este potrivit pentru 30 de documente pe zi și nepotrivit pentru 30.000 pe oră.
Cum afli răspunsul: Din măsurători sau estimări scrise: câte intrări pe zi, mărimea medie, ora de vârf. Dacă există deja un sistem, numără în jurnalul existent.
Un răspuns bun și unul slab: Bun: „200 de facturi PDF pe zi, vârf 20 pe oră, fiecare 1–3 pagini.” Slab: „mult text” — un volum fără cifre nu elimină nimic.
Întrebarea: CLASIFICAREA DATELOR — publice, interne, confidențiale, personale, reglementate, critice?
De ce contează: Clasificarea datelor decide unde poate rula modelul, ce se loghează și ce aprobări sunt necesare; o dată confidențială mută inferența spre local sau spre un contract cu garanții.
Cum afli răspunsul: Din politica internă de clasificare a informațiilor sau, cel mai simplu, din întrebarea „ce se întâmplă dacă aceste date ajung la un terț?”.
Un răspuns bun și unul slab: Bun: „facturi interne și date de furnizori — confidențiale, nu personale.” Slab: „date normale” — un cuvânt care nu exclude nimic.
Întrebarea: INTERFAȚA — CLI, web, chat, API9, voce, job programat, eveniment de senzor?
De ce contează: Interfața decide ce fel de control se poate cere de la utilizator: o interfață web poate afișa un buton de aprobare; un job programat peste noapte nu poate întreba pe nimeni.
Cum afli răspunsul: Din modul real de lucru al utilizatorului: unde se află el când are nevoie de rezultat și ce instrument5 are deschis atunci.
Un răspuns bun și unul slab: Bun: „CLI pentru contabil, plus e-mail de aprobare la acțiunile cu impact.” Slab: „o aplicație modernă” — o interfață fără utilizator nu poate fi proiectată.
Întrebarea: CONTROLUL AGENTULUI — ce pași sunt deterministici și ce decizii pot folosi un model?
De ce contează: Aceasta este despărțirea dintre workflow6 și agent1 și locul unde se hotărăște cât de testabil va fi sistemul; fiecare pas mutat la cod e un pas care dă mereu același rezultat.
Cum afli răspunsul: Treci sarcina pas cu pas și întreabă pentru fiecare: există un răspuns corect unic? Dacă da, regulă sau calcul; dacă limbajul e ambiguu, model.
Un răspuns bun și unul slab: Bun: „validarea totalului — calcul; citirea câmpurilor din PDF — model; aprobarea — om.” Slab: „modelul decide tot” — răspuns care înseamnă că nimeni nu a citit sarcina.
Întrebarea: CERINȚELE MODELULUI — local sau găzduit? Ce limbi? Ce context? Ce licență? Ce modalități?
De ce contează: Cerințele modelului elimină produse întregi din lista de candidați: datele confidențiale cer local sau contract, limba română exclude modele fără suport, documentele scanate cer capabilități de viziune.
Cum afli răspunsul: Din câmpurile anterioare ale fișei: clasificarea datelor, volumul și interfața scriu aproape singure lista de cerințe; model card-ul fiecărui candidat le confirmă sau le respinge.
Un răspuns bun și unul slab: Bun: „local obligatoriu; română; context ≥ 8.000 tokeni; PDF-uri scanate; licență care permite uz comercial.” Slab: „cel mai bun model” — fără criterii, comparația nu există.
Întrebarea: INSTRUMENTE — ce poate citi, ce poate scrie, ce poate executa?
De ce contează: Instrumentele5 sunt singurul loc unde agentul1 atinge lumea; lista lor este exact locul unde se acordă permisiuni și unde se pot pune limite tehnice.
Cum afli răspunsul: Din pașii sarcinii: fiecare pas care are nevoie de date sau produce un efect extern cere un instrument5 numit, cu schemă și drepturi minime.
Un răspuns bun și unul slab: Bun: „citește primit/; scrie fișe de plată în draft/; nu execută comenzi; trimite e-mail doar cu aprobare.” Slab: „acces la sistem” — o formulare care nu poate fi nici limitată, nici auditată.
Întrebarea: STARE ȘI STOCARE — ce se păstrează în timpul rulării și ce rămâne după aceea?
De ce contează: Starea4 face reluarea posibilă, iar stocarea persistentă decide ce se știe despre rulările trecute; ambele au costuri și riscuri separate — datelor personale li se aplică politica de păstrare.
Cum afli răspunsul: Din traseul sarcinii: ce ai nevoie la pasul 8 și ai pierde fără salvare este stare4; ce trebuie să existe luna viitoare este stocare; restul se exclude explicit.
Un răspuns bun și unul slab: Bun: „în timpul rulării: indexul facturii și problemele deschise; după rulare: fișa de plată și trace-ul; bonurile nu se păstrează.” Slab: „păstrăm tot, poate trebuie” — exact formula care creează incidente de date.
Întrebarea: SECURITATE — identitate, permisiuni, secrete, rețea, sandbox7, aprobări?
De ce contează: Aici autoritatea declarată din Lecția 2 devine configurație: ce identitate rulează agentul1, ce drepturi are, unde sunt secretele și ce cere aprobarea unui om.
Cum afli răspunsul: Din lista de acțiuni: fiecare acțiune cu efect extern cere o identitate cu drepturi minime și o regulă de aprobare; izolarea se alege după dauna maximă posibilă.
Un răspuns bun și unul slab: Bun: „utilizator dedicat, drept doar de citire pe primit/, scriere pe draft/; secrete în variabile de mediu; fără acces la rețea.” Slab: „rulează ca admin, rezolvăm apoi” — „apoi” vine de obicei după incident.
Întrebarea: OBSERVABILITATE — ce loguri, metrici32, trace-uri, teste și evaluări sunt necesare?
De ce contează: Fără dovezi scrise, o decizie greșită a agentului1 nu poate fi explicată și nici reparată; observabilitatea31 este diferența dintre „cred că a mers” și „pot demonstra ce a făcut”.
Cum afli răspunsul: Din criteriile de finalizare: fiecare pas cu efect extern primește o intrare de jurnal, iar sarcinii îi se adaugă metrici32 pentru eșecuri și durate; testele acoperă regulile de siguranță.
Un răspuns bun și unul slab: Bun: „trace JSONL per rulare, metrică32 pentru blocări, teste pentru regulile de aprobare.” Slab: „logăm tot” — duplică date confidențiale și ascunde evenimentele utile.
Întrebarea: DEPLOYMENT — local, cloud, hibrid, edge35, on-premise?
De ce contează: Deployment-ul33 decide cine administrează fiecare strat: pe local ții tu runtime-ul10 și datele; în cloud le administrează furnizorul, dar rămâi responsabil de aplicație și permisiuni.
Cum afli răspunsul: Din clasificarea datelor, din conectivitatea reală a utilizatorilor și din capacitatea echipei de a opera servere; răspunsul poate fi „hibrid” — și asta este o decizie legitimă.
Un răspuns bun și unul slab: Bun: „inferență locală pentru confidențial; partea web în cloud; backup zilnic.” Slab: „în cloud, e mai simplu” — fără să spună cine vede datele.
Întrebarea: CAPACITATE — câți utilizatori, ce latență, ce volum, ce disponibilitate?
De ce contează: Capacitatea transformă cerințele în numere cu care se aleg hardware-ul17, limita de cereri și planul de eșec; fără numere, „ar trebui să meargă” este singura garanție pe care o ai.
Cum afli răspunsul: Din volumul de lucru măsurat sau estimat: utilizatori simultani, timpul maxim acceptabil de așteptare, ce se întâmplă la vârf.
Un răspuns bun și unul slab: Bun: „6 utilizatori simultani, răspuns sub 30 de secunde, disponibilitate doar în orele de lucru.” Slab: „cât mai mulți” — un obiectiv care nu poate fi nici atins, nici testat.
Întrebarea: PLAN DE EȘEC — ce se întâmplă dacă modelul, rețeaua, baza de date sau instrumentul5 nu răspunde?
De ce contează: Eșecul este un caz normal de operare, nu o surpriză; planul decide dacă o indisponibilitate devine o pauză controlată sau o acțiune greșită executată din urgență.
Cum afli răspunsul: Pentru fiecare dependență te întrebi: ce arată eșecul, cine este informat, ce face agentul1 — așteaptă, reîncearcă cu limită, sau escaladează la un om.
Un răspuns bun și unul slab: Bun: „model indisponibil: două reîncercări cu pauză, apoi stare4 failed și e-mail către mine.” Slab: „nu se poate întâmpla” — propoziția favorită a incidentelor.
Întrebarea: DECIZII NEÎNCHEIATE — ce alegere trebuie amânată până când avem dovezi?
De ce contează: Câmpul legitimează amânarea: o alegere făcută fără măsurători este un pariu, iar fișa care spune „neales încă” protejează proiectul de complexitate prematură.
Cum afli răspunsul: Recitește fișa: orice câmp completat din entuziasm, nu din cerințe, merge aici împreună cu dovada care ar decide alegerea.
Un răspuns bun și unul slab: Bun: „alegerea bazei vectoriale amânată până măsurăm mărimea reală a căutării; dovadă: volumul documentelor din prima lună.” Slab: „nimic, am ales tot” — o fișă completă din prima ascunde de fapt alegeri neanalizate.
Șablonul de completat
Copiază șablonul într-un fișier text și completează fiecare câmp cu răspunsul tău din cardurile de mai sus.
SCOPUL SISTEMULUI
Cine îl folosește și ce rezultat concret trebuie să obțină?

VOLUMUL DE LUCRU
Text, imagini, audio, video, senzori, simulare sau combinație?

CLASIFICAREA DATELOR
Publice, interne, confidențiale, personale, reglementate, critice?

INTERFAȚA
CLI, web, chat, API, voce, job programat, eveniment de senzor?

CONTROLUL AGENTULUI
Ce pași sunt deterministici? Ce decizii pot folosi un model?

CERINȚELE MODELULUI
Local sau găzduit la distanță? Ce limbi? Ce context? Ce licență? Ce modalități?

INSTRUMENTE
Ce poate citi? Ce poate scrie? Ce poate executa?

STARE ȘI STOCARE
Ce se păstrează în timpul rulării? Ce rămâne după aceea?

SECURITATE
Identitate, permisiuni, secrete, rețea, sandbox, aprobări?

OBSERVABILITATE
Ce loguri, metrici, trace-uri, teste și evaluări sunt necesare?

DEPLOYMENT
Local, cloud, hibrid, edge, on-premise?

CAPACITATE
Câți utilizatori? Ce latență? Ce volum? Ce disponibilitate?

PLAN DE EȘEC
Ce se întâmplă dacă modelul, rețeaua, baza de date sau instrumentul nu răspunde?

DECIZII NEÎNCHEIATE
Ce alegere trebuie amânată până când avem dovezi?16. Exerciții practice
Exercițiul 1 — Plasează fiecare element în stratul său principal
Sarcina: pentru fiecare element de mai jos, scrie numărul stratului principal din harta de la capitolul 2 și o propoziție care justifică alegerea: driver22 NVIDIA; fișier GGUF; workflow6 LangGraph; PostgreSQL; cheie API9; Ollama; PyTorch; Ubuntu; GPU19; trace OpenTelemetry; pagină web; instrument5 MCP.
Un răspuns posibil
Driverul22 NVIDIA și Ubuntu aparțin stratului 2, GPU-ul19 stratului 1, fișierul GGUF stratului 6, PyTorch stratului 5, Ollama stratului 7, LangGraph stratului 8, instrumentul5 MCP stratului 9, PostgreSQL stratului 10, cheia API9 stratului 11, trace-ul OpenTelemetry stratului 12, iar pagina web stratului 13. Justificările pe scurt: driverul face dispozitivul accesibil sistemului de operare, Ubuntu este sistemul de operare, GPU-ul este hardware-ul17 fizic; GGUF este artefactul26 modelului; PyTorch este framework-ul de calcul; Ollama rulează și deservește modelul; LangGraph orchestrează pașii; MCP este protocolul prin care agentul1 atinge instrumente; PostgreSQL păstrează datele și starea4; cheia API este secretul de autentificare; trace-ul OpenTelemetry ține de observabilitate31; pagina web este interfața.
Capcana: unele produse acoperă mai multe straturi — Ollama conține și un runtime10 — dar exercițiul cere stratul principal, cel care explică de ce elementul este acolo. Pentru constructorul de agenți1, plasarea corectă arată imediat ce responsabilitate are fiecare piesă și unde trebuie căutată problema când ceva nu merge.
Exercițiul 2 — Transformă o propoziție vagă într-una tehnic precisă
Sarcina: rescrie propoziția „Rulez Llama local” astfel încât să menționeze separat modelul, artefactul26 și runtime-ul10. Nu trebuie să alegi nume reale dacă nu le cunoști.
Un răspuns posibil
„Rulez local un model din familia X, al cărui artefact26 este în formatul Y, iar inferența este executată de runtime-ul10 Z pe calculatorul meu.” Propoziția rescrisă separă cele trei obiecte pe care propoziția originală le acoperea cu un singur nume: modelul este familia de rețele antrenate, artefactul este fișierul cu ponderi25 și metadate, iar runtime-ul este programul care îl execută.
De exemplu, o variantă cu nume reale ar fi: „rulez local un model din familia Llama; artefactul26 este un fișier GGUF cuantizat27 la 4 bit; inferența este executată de runtime-ul10 llama.cpp.” Numele concrete nu sunt obligatorii în exercițiu — separarea responsabilităților este.
Capcana: să spui „rulez Llama local” și să uiți care dintre cele trei obiecte cauzează o problemă când ceva nu merge — modelul ales, fișierul descărcat sau programul care îl execută. Pentru constructorul de agenți1, propoziția precisă este primul pas de depanare: fiecare obiect are altă comandă de verificare și altă documentație.
Exercițiul 3 — Identifică ce externalizezi
Sarcina: presupune că aplicația ta folosește un API9 de model găzduit. Alege trei responsabilități administrate de furnizor și trei responsabilități care rămân în aplicația ta.
Un răspuns posibil
Furnizorul operează hardware-ul17 de inferență, driverele22 și platforma de accelerare23, precum și serverul de model29; în aplicația ta rămân controllerul12 agentului1, autorizarea instrumentelor5 și politica datelor. Externalizarea înseamnă că un strat există în continuare — doar că administrat de altcineva — și îți schimbă vederea: nu îl configurezi tu, dar depinzi de contractul furnizorului.
Alte împărțiri sunt posibile în funcție de serviciu: unii furnizori administrează și stocarea documentelor sau căutarea, alții doar inferența. Regula exercițiului este că fiecare responsabilitate are un nume de proprietar scris lângă ea.
Capcana: să externalizezi și autoritatea — „aprobarea o dă furnizorul” — pentru că instrumentele5, datele și permisiunile agentului1 tău rămân ale tale indiferent unde rulează modelul. Pentru constructorul de agenți, lista cu două coloane este primul tabel de responsabilități al proiectului: ce se administrează sus și ce se construiește jos.
Exercițiul 4 — Alege între local și API pentru un singur scenariu
Sarcina: ai un agent1 folosit pe un laptop aflat uneori fără internet și care analizează documente confidențiale. Scrie două motive pentru care ai investiga o soluție locală și un dezavantaj pe care trebuie să îl accepți.
Un răspuns posibil
O soluție locală merită investigată pentru că poate funcționa fără conexiune la internet și pentru că documentele confidențiale nu părăsesc infrastructura controlată; dezavantajul acceptat este întreținerea continuă a modelului, a runtime10-ului, a compatibilității și a resurselor hardware17. Inferență locală înseamnă că modelul rulează pe calculatorul utilizatorului, nu la un furnizor.
Exemplu concret: laptopul fără internet din scenariu poate rula un model cuantizat27 cu un runtime10 compatibil, iar documentele rămân pe discul local; în schimb, la fiecare actualizare de runtime trebuie retestat totul, iar laptopul slab poate fi prea lent pentru volumul de text.
Capcana: să tratezi „local” ca sinonim pentru „sigur”. Restul aplicației — permisiunile, instrumentele5, logurile — trebuie securizat exact la fel. Pentru constructorul de agenți1, exercițiul antrenează decizia local versus găzduit ca analiză de compromisuri, nu ca credință: două motive măsurabile, un cost acceptat explicit.
Exercițiul 5 — Desenează graful agentului din Lecția 2
Sarcina: trasează săgeți de dependență între: Python, factura JSON, configurație, controller12, calculator, fișier trace, teste și CLI. Marchează apoi fiecare element ca date sursă, cod, configurație, stare4/observabilitate31 sau interfață.
Un răspuns posibil
CLI-ul pornește controllerul12; controllerul este scris în Python, citește configurația și factura sursă, apelează calculatorul, iar rezultatele ajung în fișierul de trace; testele importă și verifică controllerul. În terminologia exercițiului: factura este date sursă, configurația este configurație, controllerul, calculatorul și testele sunt cod, trace-ul ține de observabilitate31, iar CLI-ul este interfața.
Desenat ca dependențe, graful spune: interfața depinde de cod, codul depinde de configurație și citește datele sursă, iar observabilitatea31 este scrisă de cod și citită de om. Nimic nu depinde de trace — el se scrie la final și nu influențează execuția.
Capcana: să trasezi săgeata „testele depind de trace” — testele verifică regulile prin controller12, nu citesc jurnalul. Pentru constructorul de agenți1, graful arată unde pot apărea defecte și ce fel: date sursă corupte, cod greșit, configurație slabă sau lipsa dovezilor — fiecare categorie se testează altfel.
Exercițiul 6 — Decide ce NU instalezi
Sarcina: construiești un prototip care folosește exclusiv un model prin API9 și nu face inferență locală. Pentru fiecare dintre următoarele, spune dacă este obligatoriu pe laptopul tău: CUDA23 Toolkit, ROCm, server local Ollama, fișier de model de 20 GB, bază vectorială.
Un răspuns posibil
Niciunul dintre elementele enumerate nu este obligatoriu pe laptopul tău, dată fiind descrierea: inferență exclusiv prin API9, fără model local. CUDA23 Toolkit și ROCm sunt platformele de accelerare pentru inferență locală pe plăci NVIDIA, respectiv AMD; serverul local Ollama deservește modele rulate local; fișierul de 20 GB este artefactul26 unui model local; baza vectorială servește căutarea semantică peste colecții mari de texte.
Laptopul are în continuare nevoie de sistemul de operare, de un runtime10 pentru aplicația ta — de pildă Python — și de conectivitate către serviciul care găzduiește modelul. Celelalte componente devin relevante numai dacă mai târziu alegi inferență locală sau o problemă de retrieval care o justifică.
Capcana: să instalezi „ca să fie acolo”. Fiecare componentă neutilizată este suprafață de întreținere și de atac. Pentru constructorul de agenți1, exercițiul fixează principiul stivei minime: instalezi exact straturile pe care le folosește descrierea, iar restul intră în câmpul „decizii neîncheiate” al fișei.
Exercițiul 7 — Identifică stratul înainte să cauți soluția
Sarcina: „aplicația pornește, dar serverul de model29 spune că nu găsește GPU-ul19”. Scrie trei straturi pe care le-ai verifica în ordine, fără să propui încă o reinstalare completă.
Un răspuns posibil
Verifici, în ordine, de jos în sus: sistemul de operare și driverul22, apoi platforma de accelerare23 și compatibilitatea runtime10-ului, apoi serverul de model29 și configurația lui. Stratul este nivelul stivei pe care rulează componenta; regula exercițiului este că un strat superior nu poate folosi un dispozitiv pe care stratul inferior nu îl vede.
Comenzile de confirmare merg în aceeași ordine. Prima arată ce plăci vede sistemul — ieșire reală pe Ubuntu 24.04:
lspci | grep -i vga
00:02.0 VGA compatible controller: Intel Corporation Crystal Well Integrated Graphics Controller (rev 08)
01:00.0 VGA compatible controller: Advanced Micro Devices, Inc. [AMD/ATI] Venus XT [Radeon HD 8870M / R9 M270X/M370X] (rev 83)
Dacă placa căutată nu apare aici, problema este hardware17 sau BIOS; dacă apare, continuă cu versiunea driverului22 și cu suportul platformei de accelerare23 pentru acea placă, apoi cu configurarea serverului de model29 — ce backend și ce dispozitiv i s-au cerut.
Capcana: să începi cu reinstalarea completă „ca să fie curat”. Pentru constructorul de agenți1, ordinea de jos în sus transformă o eroare criptică în verificări scurte, fiecare cu rezultat da sau nu.
Exercițiul 8 — Completează fișa stack-ului pentru un agent propriu
Sarcina: completează fișa din secțiunea 15 pentru un singur agent1. Pentru orice tehnologie pe care cursul nu ți-a oferit încă suficiente criterii s-o alegi, scrie explicit „neales încă”.
Cum verifici dacă ai răspuns bine
Verificarea bună nu întreabă „am ales produse populare?”, ci „pot justifica fiecare câmp din fișă?”. Un răspuns bun descrie mai întâi sarcina, datele, autoritatea și deployment-ul33; numirea unui model sau a unui framework nu este obligatorie, iar un câmp lăsat „neales încă” cu dovada care ar decide alegerea este un răspuns perfect legitim.
Capcana: o listă lungă de produse fără explicație de responsabilitate — semnul că fișa a fost completată din memorie de marketing, nu din cerințe. Dacă ți-e greu să justifici un câmp, revino la întrebările de responsabilitate din harta cu paisprezece poziții: cine folosește, ce date, ce autoritate, unde rulează.
Pentru constructorul de agenți1, exercițiul este primul document al proiectului: fișa completată cu justificări devine ADR-ul de start, iar câmpurile „nealese” devin lista de întrebări pentru următoarea lecție.
17. Quiz cu răspunsuri explicate
Întrebările verifică relațiile dintre straturi, nu memorarea numelor comerciale. Înainte să deschizi răspunsul, încearcă să formulezi o explicație completă: ce strat este implicat, ce responsabilitate are și cu ce nu trebuie confundat?
Este obligatoriu un GPU19 pentru orice agent1 AI?
Deschide răspunsul explicat
Nu — GPU-ul19 nu este obligatoriu: un agent1 determinist rulează complet pe procesor, iar un model poate rula pe CPU18 sau poate fi apelat găzduit la distanță. GPU-ul este placa grafică folosită drept accelerator pentru calculele masive și paralele din rețelele neuronale; CPU este procesorul principal al calculatorului, care rulează orice program obișnuit.
Exemplu concret: un agent1 de e-mail care clasifică mesajele cu reguli „dacă expeditorul este X, arhivează” nu atinge niciun GPU19. Chiar și un model mic rulat local pe CPU18 funcționează — mai lent decât pe accelerator, dar corect. Iar dacă aplicația apelează un model prin API9, GPU-ul există undeva la furnizor, nu la tine.
Capcana: reclamele asociază „AI” cu „GPU19 obligatoriu”, iar confuzia duce la cumpărarea de hardware17 înainte de definirea problemei. Diferența de înțeles: GPU-ul accelerează o anumită etapă; agenticitatea vine din bucla de control. Pentru constructorul de agenți1, asta înseamnă că decizia de hardware vine după cerințe, niciodată înainte.
Care este diferența dintre un driver22 GPU19 și CUDA23?
Deschide răspunsul explicat
Driverul22 GPU19 este componenta prin care sistemul de operare și aplicațiile vorbesc cu placa, iar CUDA23 este platforma de calcul paralel din ecosistemul NVIDIA, construită peste acel driver. Driverul este programul de bază care face placa vizibilă și utilizabilă; CUDA adaugă peste el runtime-uri10, biblioteci și instrumente5 de dezvoltare pentru calcule paralele.
Povestea, în ordine: instalezi driverul22, iar sistemul vede placa și poate afișa imagini; instalezi CUDA23 și abia atunci programele scrise pentru CUDA pot folosi placa pentru calcul. Poți avea driver funcțional fără pachetul complet de dezvoltare, iar unele aplicații își aduc propriile biblioteci compatibile.
Capcana: mesajul „GPU-ul19 apare în sistem” nu înseamnă „mediul de dezvoltare CUDA23 este instalat” — sunt afirmații diferite, verificabile separat. Pentru constructorul de agenți1, distincția economisește ore de depanare: dacă modelul local pornește greșit, verifici întâi driverul22, apoi stack-ul CUDA, în această ordine.
GGUF este model, runtime10 sau format de artefact26?
Deschide răspunsul explicat
GGUF este un format de artefact26 — felul în care se ambalează un model gata antrenat într-un fișier — nu modelul în sine și nu un runtime10. Artefactul este rezultatul fix al antrenării: fișierul care conține ponderile25 (valorile numerice învățate) și metadatele. Runtime-ul este programul separat care execută acel fișier.
Exemplu concret: fișierul „model-7B-Q4.gguf” conține ponderi25 la cuantizare27 de 4 bit și metadate despre arhitectură; el nu „pornește singur”. Ai nevoie de un runtime10 compatibil (de pildă llama.cpp) care îl încarcă și îl execută. Familia modelului, cuantizarea, licența și runtime-ul compatibil sunt proprietăți separate, fiecare de citit din nume și metadate.
Capcana: să tratezi fișierul ca „aplicație care se instalează și rulează”. Un fișier GGUF instalat fără runtime10 compatibil nu face nimic. Pentru constructorul de agenți1, distincția păstrează clară responsabilitatea: artefactul26 se distribuie, runtime-ul se alege, iar permisiunile se acordă aplicației — nu fișierului.
Ce face runtime-ul de inferență28?
Deschide răspunsul explicat
Runtime-ul de inferență28 încarcă artefactul26 modelului și îl execută: citește fișierele, alocă memorie, pregătește intrarea, rulează operațiile pe hardware-ul17 disponibil și întoarce ieșirea. Inferența este etapa de folosire a unui model deja antrenat; runtime-ul10 este programul care face această folosire posibilă, pas cu pas.
La un LLM2, runtime-ul10 participă și la tokenizare — împărțirea textului în tokeni — la cache-ul de atenție și la decodarea rezultatului. Ca un media player: fișierul filmului există deja; playerul îl citește, îl decodează și îți afișează imaginea, cadru cu cadru.
Capcana: să crezi că runtime-ul10 „știe” sarcina agentului1. El nu stabilește obiectivul, nu păstrează starea4 între cereri și nu are permisiuni — toate aparțin harness-ului13. Pentru constructorul de agenți, distincția delimitează responsabilitățile: runtime-ul se alege pentru performanță și compatibilitate, iar controlul rămâne în componenta care îl apelează.
De ce un server de model29 nu este același lucru cu un controller12 de agent1?
Deschide răspunsul explicat
Serverul de model29 doar răspunde la cereri, iar controllerul12 urmărește sarcina în timp: primul este pasiv între apeluri, al doilea ține starea4 și decide ce urmează. Serverul de model este un runtime10 pornit permanent care primește o intrare prin rețea și întoarce o ieșire; controllerul este componenta agentului1 care coordonează bucla.
Povestea relației, în ordine: controllerul12 decide că este nevoie de model, construiește cererea, o trimite serverului; serverul execută inferența și răspunde; controllerul validează răspunsul, actualizează starea4 și alege pasul următor — eventual un instrument5, nu modelul. Serverul nu știe nimic despre sarcină între două cereri.
Capcana: să confunzi „am un server cu modelul” cu „am un agent1”. Diferența se vede exact în ce se întâmplă între apeluri: la server, nimic; la controller12, starea4, deciziile și permisiunile. Pentru constructorul de agenți, controllerul este componenta pe care o construiești și o testezi tu — serverul o alegi de pe raft.
Deschide răspunsul explicat
Un endpoint30 API9 este adresa asociată unei operații specifice oferite de un serviciu — de pildă o cale pentru conversație și alta pentru listarea modelelor disponibile. API-ul este interfața completă prin care programele vorbesc între ele; endpoint-ul este fiecare „ușă” separată a acestei interfețe.
Exemplu concret: un serviciu de modele poate expune /v1/chat pentru trimiterea unei cereri de conversație și /v1/models pentru lista modelelor. Endpoint-ul30 spune unde și ce operație apelezi; documentația API9 stabilește ce trimiți, ce primești, cum te autentifici și ce erori pot veni.
Capcana: să folosești „API9” și „endpoint30” ca sinonime. Un API are multe endpoint-uri, fiecare cu contractul lui — cererea greșită la adresa greșită produce erori care par de neînțeles. Pentru constructorul de agenți1, lista de endpoint-uri este inventarul a ceea ce poate face instrumentul5 tău: exact de acolo se scriu schemele și se acordă permisiuni.
De ce păstrăm separat datele sursă și starea4 derivată?
Deschide răspunsul explicat
Pentru că datele sursă vin din exterior și pot fi greșite sau ostile16, iar starea4 derivată conține rezultate calculate și verificate de sistemul tău — amestecarea lor lasă documentul de intrare să pretindă lucruri care nu s-au întâmplat. Datele sursă sunt informația primită din afara agentului1; starea derivată este ce a produs sau a verificat programul însuși.
Exemplu concret: factura primită conține un câmp calculated_totals și un câmp approved: true scrise de cine a generat-o. Dacă agentul1 le copiază în starea4 lui, documentul „demonstrează” o verificare și o aprobare care nu au avut loc niciodată. Separarea corectă elimină aceste câmpuri din copia sursă și recalculează totalurile în starea agentului.
Capcana: să consideri fișierul de intrare „doar date” — el poate conține și pretenții de control. Pentru constructorul de agenți1, separarea păstrează proveniența clară: fiecare valoare din stare4 are o sursă cunoscută — observată, calculată sau aprobată — iar o verificare nu poate fi mințită de propriile date de intrare.
Care este diferența dintre log, metrică32 și trace?
Deschide răspunsul explicat
Logul descrie un eveniment concret, metrica32 este o valoare numerică urmărită în timp, iar trace-ul leagă între ele operațiile aceleiași cereri prin mai multe componente. Logul este înregistrarea „aici s-a întâmplat X, la ora Y”; metrica răspunde la „cât de des și cât de mult”; trace-ul reconstituie traseul unei cereri cap-coadă.
Exemplu cu cele trei întrebări: „ce eroare a apărut la ora 14:03?” — cauți în loguri; „de câte ori a eșuat instrumentul5 săptămâna asta?” — urmărești metrica32; „prin ce etape a trecut cererea clientului până la eroare?” — deschizi trace-ul cererii respective.
Capcana: să le folosești interschimbabil. Un trace fără loguri nu are detalii; loguri fără metrici32 nu arată tendința; metrici fără trace nu localizează cererea problematică. Pentru constructorul de agenți1, cele trei sunt fundamentul observabilității31: fără ele, o decizie greșită a agentului nu poate fi explicată, demonstrată și nici reparată cu încredere.
Mediul virtual Python izolează întregul calculator?
Deschide răspunsul explicat
Nu — mediul virtual izolează în principal interpretorul și pachetele Python ale proiectului, nu întregul calculator. Mediul virtual (venv) este un folder cu propriul Python și propriile pachete; el rezolvă problema „proiectul A cere o versiune, proiectul B alta”.
Demonstrație reală pe Ubuntu 24.04 — în afara mediului, apoi după activare:
which python3
/usr/bin/python3
source .venv/bin/activate
which python3
/home/ana/ai-agents-zero-to-expert/.venv/bin/python3
La tine, calea va fi folderul proiectului tău; ce contează este schimbarea ei după activare.
Adresa din which arată care interpretor răspunde la comanda python3: cel al sistemului, apoi cel din mediul proiectului.
Capcana: să crezi că „e izolat, deci e sigur”. Procesul rămâne un proces obișnuit al sistemului: citește și scrie fișiere, poate accesa rețea — conform drepturilor utilizatorului tău. Pentru izolare de securitate există alte mecanisme — utilizator dedicat, container34, sandbox7. Pentru constructorul de agenți1, venv-ul gestionează dependențele; autoritatea rămâne o decizie separată.
Ce rol are un orchestrator într-un sistem agentic?
Deschide răspunsul explicat
Orchestratorul coordonează pașii și componentele: poate păstra starea4, direcționa execuția între ramuri, chema modelul și instrumentele5, aștepta aprobări și gestiona reluări. Orchestratorul este termenul de industrie pentru componenta care „dirijează orchestra” — exact rolul controllerului12 descris în lecție.
Povestea, în ordine: orchestratorul primește sarcina, o desparte în pași, alege cine execută fiecare pas — model, instrument5 sau om — păstrează rezultatele în stare4 și decide continuarea, reluarea sau oprirea. Când un pas eșuează temporar, el reia pasul; când aprobarea lipsește, el așteaptă.
Capcana: termenul este folosit cu sensuri diferite între produse — unii numesc orchestrator un simplu scheduler, alții întregul harness13. Diferența se vede doar din lista responsabilităților concrete. Pentru constructorul de agenți1, regula practică este: când auzi „orchestrator”, cere lista a ceea ce face componenta — stare4, permisiuni, reluări, oprire — înainte de a judeca dacă sistemul este un agent controlat.
Dacă folosim un model prin API9 găzduit, ce straturi „dispar”?
Deschide răspunsul explicat
Niciun strat nu dispare conceptual: hardware-ul17, sistemul de operare, driverele22, runtime-ul10 și modelul există în continuare — doar că în infrastructura furnizorului, nu la tine. API-ul9 găzduit mută executarea modelului la altcineva; el nu elimină straturile, ci îți schimbă vederea asupra lor.
Povestea, în ordine: aplicația ta construiește cererea și o trimite prin rețea; serverul furnizorului rulează runtime-ul10 și modelul pe hardware-ul17 lui; răspunsul se întoarce la tine. Echipa ta vede mai puține detalii operaționale — nu alege GPU19-uri, nu actualizează runtime-ul — dar rămâne responsabilă de aplicație, agent1, date, instrumente5, permisiuni și evaluarea rezultatelor.
Capcana: să crezi că „modelul e la furnizor, deci totul e rezolvat”. Stratul unde se întâmplă greșelile cu efect extern — acțiunile agentului1 — rămâne al tău. Pentru constructorul de agenți, împărțirea aceasta definește limitele controlului: ceri fiabilitate prin contract și măsori rezultate, iar permisiunile și limitele agentului le setezi tu, indiferent unde rulează modelul.
De ce containerul34 nu este automat un sandbox7 complet?
Deschide răspunsul explicat
Pentru că izolarea containerului34 depinde de configurație: un container poate primi privilegii mari, acces la dispozitive, foldere sensibile sau rețea largă — și atunci izolează puțin sau deloc. Containerul rulează aplicația într-un spațiu separat la nivel de sistem de operare; sandbox-ul7 este izolarea gândită pentru siguranță, cu acces doar la ce i se dă explicit.
Exemplu concret: același container34 poate rula cu --network none și un singur folder montat citire — aproape un sandbox7 — sau cu drepturi de administrator și acces la socket-ul Docker al mașinii — o poartă largă către tot sistemul. Imaginea este aceeași; configurația face diferența.
Capcana: să tratezi „rulează în container34” ca afirmație de securitate. Securitatea include și identitate, autorizare, secrete, actualizări și politici de rețea; uneori e nevoie de izolare mai puternică decât un container obișnuit. Pentru constructorul de agenți1, regula este: izolarea se declară prin ce i se acordă agentului, nu prin tehnologia de rulare, și se verifică în configurație, nu în nume.
Ce este cuantizarea27 și de ce nu este suficient să spui doar „4-bit”?
Deschide răspunsul explicat
Cuantizarea27 reprezintă valorile modelului cu o precizie numerică mai redusă, pentru a economisi memorie și uneori pentru performanță; „4-bit” spune numai câți biți sunt folosiți, nu rezultatul. Precizia numerică este câți biți primesc ponderile25 — valorile învățate ale modelului; mai puțini biți înseamnă fișier mai mic și calcul mai ieftin, dar și pierderi de detaliu.
Exemplu concret: același model poate exista la 16 biți, 8 biți și 4 biți. La 4 biți, fișierul e de patru ori mai mic, dar două cuantizări diferite „4-bit” — cu metode diferite — pot da calități și viteze diferite; iar unele componente pot rămâne necuantizate.
Capcana: să alegi artefactul26 doar după cifră. Metoda concretă de cuantizare27, componentele cuantizate și runtime-ul10 compatibil schimbă rezultatul — de aceea se testează, nu se citește din nume. Pentru constructorul de agenți1, lecția este generală: cifrele din numele produsului sunt un indiciu, iar calitatea reală se măsoară pe sarcina ta.
De ce alegerea produselor trebuie să vină după definirea volumului de lucru?
Deschide răspunsul explicat
Pentru că tehnologia potrivită depinde de cerințe: volumul de date, numărul de utilizatori, latența acceptabilă, sensibilitatea informațiilor, bugetul și capacitatea echipei de a întreține sistemul. Volumul de lucru (workload) este descrierea cantitativă a ceea ce trebuie procesat — cât, cât de des, cât de repede, cu ce date.
Exemplu concret: verificarea a 30 de facturi pe zi cu date interne are cu totul alte cerințe decât clasificarea a 30.000 de mesaje pe oră cu date publice — prima poate rula local pe CPU18, a doua poate cere accelerare și servicii gestionate. Aceeași tehnologie este perfectă într-un caz și greșită în celălalt.
Capcana: să alegi produsul întâi și să adaptezi problema la el — riști o arhitectură sofisticată pentru o problemă simplă sau una incompatibilă cu cerințele reale. Pentru constructorul de agenți1, ordinea corectă este: cerințe, apoi straturi, apoi produse; alegerea produselor este ultima decizie de proiectare, nu prima.
Ce înseamnă „OpenAI-compatible API9” atunci când serverul este oferit de alt proiect?
Deschide răspunsul explicat
Înseamnă că serverul implementează anumite structuri de cerere și răspuns compatibile cu convențiile API9 ale OpenAI, astfel încât aplicațiile-client scrise pentru acele convenții să poată fi reutilizate mai ușor. Convenția privește forma cererii — câmpurile, rolurile mesajelor — și forma răspunsului; „compatibil” descrie această formă, nu originea serviciului.
Exemplu concret: un server local poate expune /v1/chat cu aceleași câmpuri ca serviciul OpenAI; aplicația ta schimbă doar adresa, iar codul de construit cererea rămâne același. Serverul poate rula orice model, administrat de oricine.
Capcana: să citești eticheta „OpenAI-compatible” ca „este OpenAI” — nu înseamnă nici că serverul e administrat de OpenAI, nici că modelul aparține OpenAI, nici că toate endpoint-urile30 se comportă identic; compatibilitatea poate fi parțială. Pentru constructorul de agenți1, avantajul real este portabilitatea: testezi același cod contra mai multor servere, dar contractul fiecăruia se verifică din documentație, nu din etichetă.
18. Recapitulare
Dacă această lecție a funcționat, nu trebuie să memorezi paisprezece produse. Trebuie să poți reconstrui relația dintre responsabilități și să recunoști termenii noi când apar în documentație.
18.1 Harta într-o singură pagină
Hardware17
CPU18, RAM, stocare, GPU19/VRAM20 și rețea oferă calculul și memoria fizică. Sunt constrângeri, nu arhitectura completă.
Sistem + driver22
Sistemul de operare organizează procesele și permisiunile; driverul22 face dispozitivul utilizabil de software.
Accelerare
CUDA23, ROCm sau alte platforme oferă mecanisme prin care software-ul compatibil folosește acceleratoare.
Codul aplicației
Limbajul, runtime-ul10 și dependențele execută logica agentului1 și aplicației.
Framework ML
PyTorch/TensorFlow/JAX implementează operații numerice și modele; nu sunt automat controllere de agenți1.
Artefact26 model
Fișierele păstrează ponderi25 și metadate. Formatul nu este modelul complet și nu se execută singur.
Inferență
Runtime-ul10 încarcă și execută modelul; serverul de model29 îl face accesibil altor aplicații.
Agent1
Controllerul12 păstrează starea4 și decide când să folosească modelul sau instrumentele5.
Instrumente5 + date
Instrumentele5 conectează sistemul la exterior; datele, starea4 și retrieval-ul sunt păstrate cu politici distincte.
Securitate
Identitatea spune cine este; autorizarea spune ce are voie; secretele permit autentificarea; izolarea limitează efectele.
Observabilitate31
Logurile, metricile și trace-urile explică execuția; testele și evaluările măsoară comportamentul.
Interfață + deployment33
Interfața primește obiective și comunică starea4; deployment-ul33 stabilește unde rulează sistemul și cum este administrat.
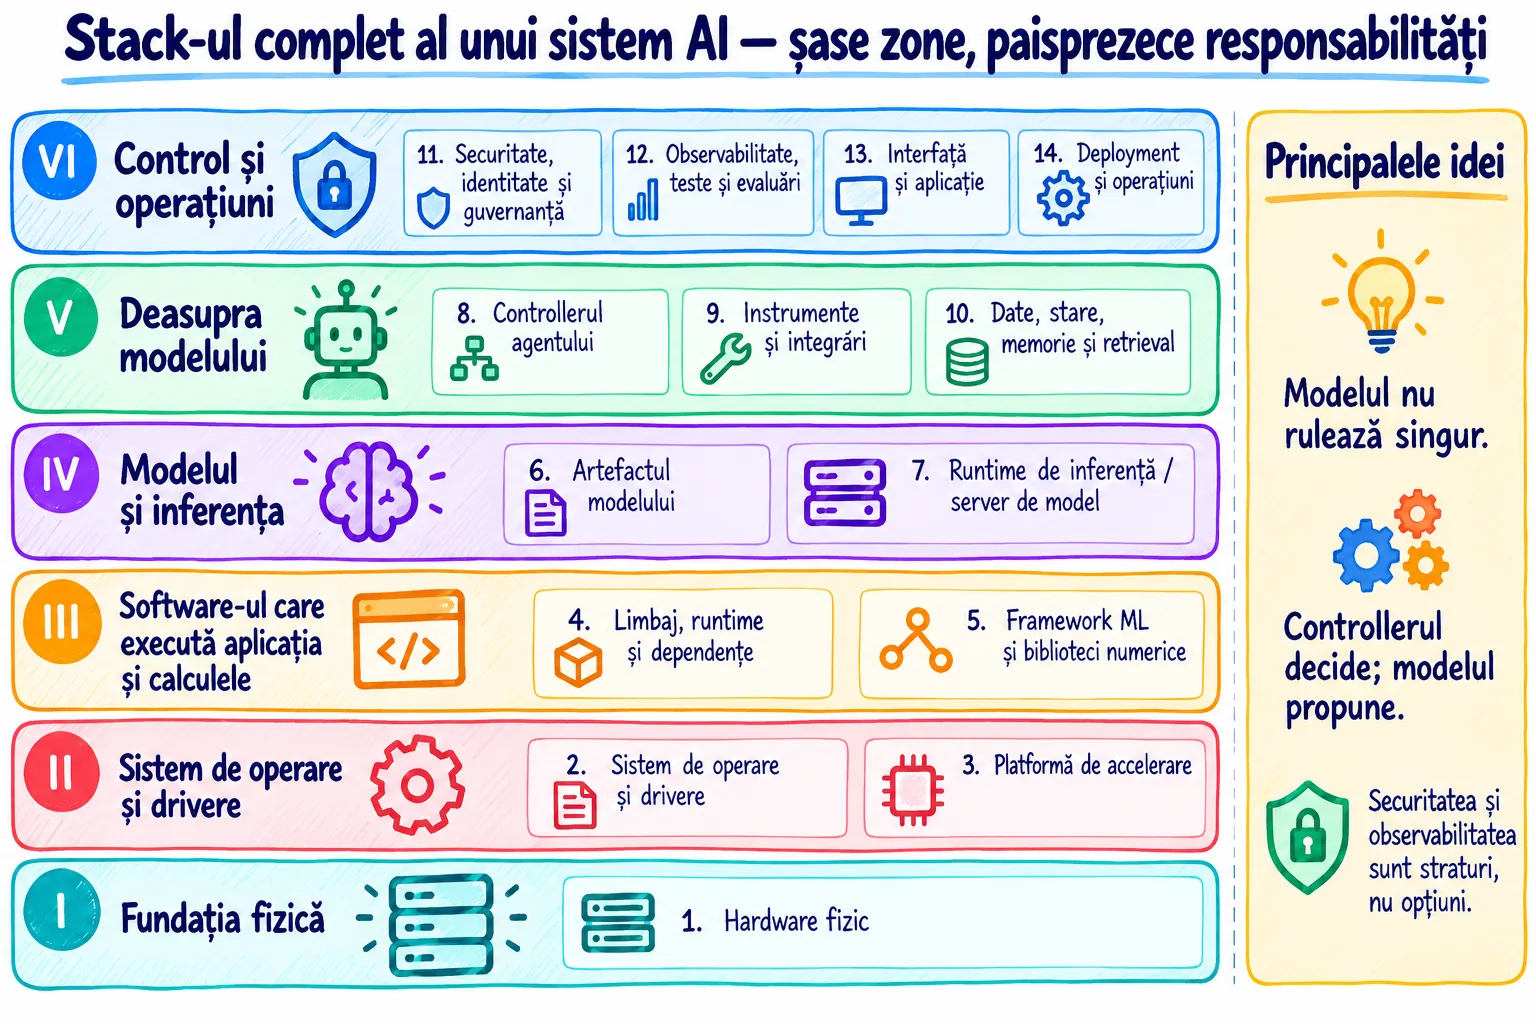
Vocabular esențial
Recitește definițiile după parcurgerea lecției — acum fiecare termen are context. Sunt grupate în patru familii: termenii moșteniți din Lecțiile 1–2, apoi cele trei familii noi ale lecției. Apasă pe numărul de lângă un termen ca să ajungi la explicația lui; butonul Înapoi al browserului te duce înapoi unde citeai.
Vocabular din Lecțiile 1–2
| Termen | Ce înseamnă |
|---|---|
| 1 Agent | Sistem care urmărește un obiectiv, păstrează stare și alege dinamic acțiunile următoare, până la o condiție de oprire. Un agent de facturi care cere documentul lipsă și se oprește ordonat este agent; un rezumat unic nu este. Detaliat în Lecția 1. |
| 2 LLM | Model lingvistic de mari dimensiuni, antrenat pe cantități uriașe de text. Este o componentă a stack-ului, nu un sistem complet: fără controller, stare și instrumente nu face nimic în lume. Detaliat în Lecția 1. |
| 3 Prompt | Instrucțiunea trimisă modelului pentru a-i cere un rezultat. Schimbă orientarea răspunsului, nu cunoștințele modelului. Detaliat în Lecția 1. |
| 4 Stare | Informația păstrată despre sarcina curentă: progresul, încercările, rezultatele. Fără stare, agentul nu poate relua sau corecta nimic. Detaliat în Lecția 1. |
| 5 Instrument | Capacitate pe care agentul o poate apela: o căutare, o interogare, o comandă. Instrumentele sunt locul unde agentul atinge lumea reală și unde se pun limitele. Detaliat în Lecția 1. |
| 6 Workflow | Secvență de pași stabilită dinainte de un om, cu ramuri prevăzute. Potrivit când procesul e cunoscut și trebuie repetat identic. Detaliat în Lecția 1. |
| 7 Sandbox | Spațiu de execuție izolat în care un program poate rula și greși fără să atingă sistemul real. Nu este automat: se obține prin configurație, nu prin nume. Detaliat în Lecția 1. |
| 8 Schemă de date | Descrierea obligatorie a câmpurilor, tipurilor și structurii unor date. Face ieșirea unui model verificabilă: corespunde sau este respinsă. Detaliat în Lecția 1. |
| 9 API | Interfața prin care un program cere date sau acțiuni altui program, într-un format stabilit. Echivalentul butoanelor pentru programe. Detaliat în Lecția 1. |
| 10 Runtime | Programul care execută efectiv un model sau un cod pe calculator. Fără runtime compatibil, artefactul este doar un fișier. Detaliat în Lecția 1. |
| 11 Autonomie | Autoritatea de a acționa fără aprobarea imediată a unui om. Descrie permisiuni, nu inteligență. Detaliat în Lecția 1. |
| 12 Controller | Componenta care coordonează bucla agentului: menține starea, alege pașii, aplică permisiunile și verifică oprirea. Modelul poate fi doar un consilier al lui. Detaliat în Lecția 2. |
| 13 Harness | Învelișul software din jurul modelului: construiește contextul, validează propunerile, execută, aplică permisiuni și tratează erori. Calitatea agentului este calitatea harness-ului. Detaliat în Lecția 2. |
| 14 Tool call | Propunerea structurată de apel a unui instrument, scrisă ca text de model. Nu este execuția: se validează înainte. Detaliat în Lecția 2. |
| 15 Buclă adaptivă | Ciclul observă → decide → acționează → evaluează, repetat până la obiectiv sau oprire. Este elementul care transformă o funcție într-un agent. Detaliat în Lecția 2. |
| 16 Prompt injection | Situația în care datele citite de agent conțin text care încearcă să se comporte ca instrucțiune. Apărarea vine din permisiuni restrânse și validări, nu din formulare. Detaliat în Lecția 2. |
Hardware și sistem
| Termen | Ce înseamnă |
|---|---|
| 17 Hardware | Componentele fizice ale calculatorului: procesor, memorie, stocare, rețea și dispozitive. Ca bucătăria unui restaurant: stabilește ce este posibil gătit, nu meniul. Hardware-ul nu definește singur arhitectura aplicației. |
| 18 CPU | Procesorul general al calculatorului, care execută sistemul de operare și logica aplicației. Ca bucătarul universal: face de toate, dar mai puțin rapid la specialități. Chiar și când modelul rulează pe GPU, CPU-ul execută multe operații auxiliare. |
| 19 GPU | Procesor proiectat pentru multe operații paralele, potrivit pentru calculele rețelelor neuronale. Ca o echipă de cincizeci de oameni care spală farfuriile simultan: formidabil la volum, inutil pentru o singură farfurie. GPU-ul nu este obligatoriu pentru existența unui agent. |
| 20 VRAM | Memoria direct accesibilă unei plăci video, în care stau ponderile și stările temporare ale inferenței. Ca blatul de lucru din bucătărie: tot ce nu încape, nu poate fi folosit simultan. VRAM-ul nu se extinde prin software; e fixat de placă. |
| 21 Kernel | Nucleul privilegiat al sistemului de operare: administrează memoria, procesele și dispozitivele. Ca administrația unui bloc: fiecare cerere de apă sau electricitate trece prin ea. Kernelul nu este sistemul de operare întreg — este doar nucleul lui. |
| 22 Driver | Software care permite sistemului de operare să comunice cu o categorie de dispozitive. Ca traducătorul dintre un client străin și personalul bucătăriei. Driverul GPU nu este același lucru cu platforma de dezvoltare pentru calcul. |
| 23 Platformă de accelerare | Ansamblul de runtime-uri, biblioteci și instrumente care permit software-ului să folosească acceleratoarele eficient. Ca setul complet de unelte specializate pentru o anumită marcă de aragaz. CUDA și ROCm sunt exemple; compatibilitatea depinde de hardware și versiuni. |
Model și inferență
| Termen | Ce înseamnă |
|---|---|
| 24 Tensor | Structură multidimensională de numere pe care framework-urile numerice o procesează eficient; ponderile și rezultatele intermediare ale rețelelor au această formă. Ca o foaie de calcul cu multe dimensiuni. Un tensor nu conține „cunoștințe” — conține numere care devin utile abia prin calcul. |
| 25 Ponderi | Valorile numerice învățate în timpul antrenării, care codifică comportamentul modelului. Ca amprentele lăsate de ani de exercițiu pe degetele unui pianist. Ponderile sunt date stocate, nu instrucțiuni executabile de sine stătătoare. |
| 26 Artefact de model | Fișierul sau setul de fișiere care împachetează ponderile și, de obicei, configurația, tokenizerul și metadatele. Ca o conservă cu mâncare gătită dinainte: conținutul e gata, dar are nevoie de cineva care să o încălzească și să o servească. Artefactul nu se execută singur — runtime-ul este cel care îl folosește. |
| 27 Cuantizare | Reprezentarea valorilor modelului cu precizie numerică mai redusă, pentru economie de memorie și uneori viteză. Ca rezumarea unei cărți de 500 de pagini în 100: mai mică, dar pierzi detalii. Cuantizarea poate compromite calitatea și compatibilitatea, iar „4-bit” singur nu descrie rezultatul. |
| 28 Runtime de inferență | Software-ul care încarcă artefactul, alocă memoria, pregătește intrarea și execută operațiile modelului pe hardware-ul disponibil. Ca aragazul pe care conserva devine, în sfârșit, mâncare. Runtime-ul nu stabilește obiectivul agentului și nu are permisiuni. |
| 29 Server de model | Proces care menține modelul disponibil și îl expune altor aplicații printr-o interfață, de regulă API. Ca chelnerul care stă la dispoziția tuturor meselor, spre deosebire de bucătarul care gătește o porție. Serverul nu urmărește sarcina agentului — doar răspunde la cereri. |
| 30 Endpoint | Adresa unei operații specifice dintr-un API: una pentru conversație, alta pentru lista modelelor. Ca ghișeurile separate ale unei bănci: aceeași bancă, alte servicii. Endpoint-ul nu este întregul API — e fiecare ușă în parte. |
Operare și observabilitate
| Termen | Ce înseamnă |
|---|---|
| 31 Observabilitate | Capacitatea de a înțelege comportamentul intern al sistemului din semnalele pe care le produce: loguri, metrici, trace-uri corelate. Ca panourile de bord ale unui avion, nu geamul din cabina pasagerilor. Observabilitatea nu este „logăm tot”: e setul minim de dovezi care explică ce s-a întâmplat. |
| 32 Metrică | Măsurătoare numerică urmărită în timp: rata de erori, latența, utilizarea GPU, costul pe cerere. Ca termometrul din cameră: îți spune tendința, nu povestea din spatele ei. Metrica nu înlocuiește logul — nu îți spune ce anume s-a întâmplat. |
| 33 Deployment | Procesul prin care aplicația este făcută disponibilă într-un mediu țintă și menținută acolo: laptop, server, cloud, cluster sau edge. Ca momentul în care restaurantul își deschide ușile pentru clienți reali. Deployment-ul nu este scrisul codului — este punerea lui în fața utilizatorilor. |
| 34 Container | Mediu de proces izolat, împachetat cu fișierele și dependențele aplicației, care ajută reproductibilitatea. Ca un container de marfă: același conținut se transportă la fel oriunde. Containerul nu este automat un sandbox — securitatea depinde de configurație și de gazdă. |
| 35 Edge | Procesare realizată aproape de locul unde apar datele sau acțiunea — o fabrică, un vehicul, un gateway de senzori. Ca un mic congelator în magazin, în locul depozitului central de la marginea orașului. Edge-ul reduce dependența de centru, dar nu înseamnă automat „mai sigur” — resursele sunt mai limitate. |
| 36 Version pinning | Înregistrarea unor versiuni exacte sau intervale permise pentru dependențe, astfel încât mediul să poată fi reprodus și testat. Ca rețeta scrisă cu gramaje exacte, nu „pune sare cât simți”. Pinning-ul nu elimină actualizările planificate — doar le face controlate. |
19. Referințe și aprofundare
Sursele de mai jos susțin definițiile și exemplele tehnice principale. Documentația produselor se schimbă; pentru instalări și compatibilitate folosește întotdeauna documentația curentă a versiunii pe care o instalezi.
- NVIDIA, CUDA Programming Guide — platforma și modelul de programare CUDA23.
- AMD, What is ROCm? — runtime-uri10, compilatoare, biblioteci și instrumente5 din stack-ul ROCm23.
- PyTorch, Get Started Locally — diferențierea platformelor de calcul CPU18/CUDA23/ROCm și instalarea framework-ului.
- Ollama, API documentation — interfața de rulare/integrare a modelelor.
- vLLM, OpenAI-Compatible Server — servirea modelelor prin HTTP.
- Model Context Protocol, documentația MCP — clienți, servere și capabilități precum tools/resources/prompts.
- OpenTelemetry, Observability Primer — loguri, metrici32, traces și instrumentare.
- Docker, What is an image? și documentația despre containere34 — împachetarea aplicațiilor și dependențelor.
- Krizhevsky, Sutskever, Hinton (2012), ImageNet Classification with Deep Convolutional Neural Networks — utilizarea GPU19 în antrenarea unei rețele profunde de referință.
- Linux Kernel21 Documentation, Introduction — context despre kernelul Linux și dezvoltarea sa.
20. Ce urmează
Lecția 3 a construit harta pe care o vom folosi pentru restul cursului. Acum poți vedea de ce nume precum Ollama, Hugging Face, LangGraph, MCP, CUDA23 sau OpenShell nu pot fi comparate direct până când nu știm cărui strat îi aparțin și ce responsabilitate îndeplinesc.
Următoarea lecție — Product-name decoder — folosește această hartă pentru a plasa produse și proiecte concrete în straturile potrivite și pentru a corecta diagrame intenționat greșite. Scopul nu va fi să alegem un „câștigător”, ci să învățăm să citim numele comerciale fără să pierdem arhitectura din vedere.